
- 월간 방문 수
- 0
- 가격
- 설정되지 않음
- 등록일
- —
- 업데이트됨
- 2026-09-21
01Laya란 무엇인가
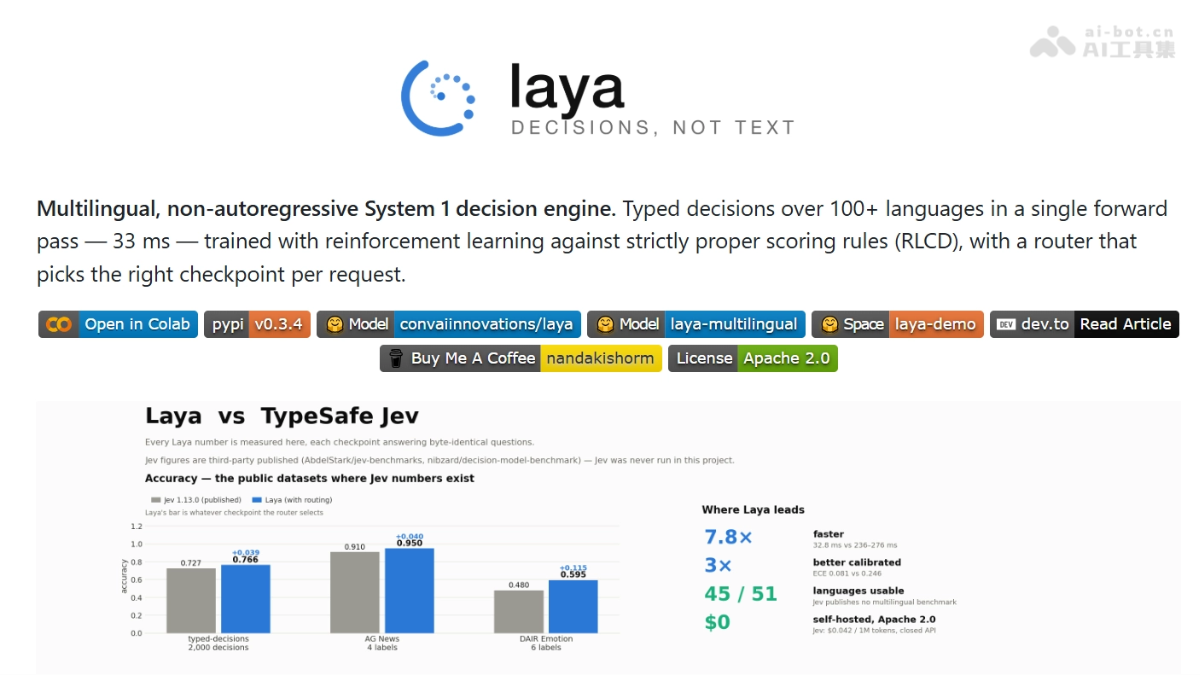
Laya는 오픈 소스 비자기회귀 AI 의사결정 모델입니다. 텍스트를 생성하지 않으며, ModernBERT/mmBERT 양방향 인코더를 기반으로 텍스트와 유형화된 질문을 한 번만 순전파해 약 33ms 만에 구조화된 결과와 보정된 확률을 출력합니다. 모델에는 100개 이상의 언어를 지원하는 내장 언어 라우팅 기능이 있습니다. 폐쇄형 모델 Jev와 비교하면 Laya는 정확도(76.6% vs 72.7%), 다국어 지원(100개 이상 언어), 비용(로컬 배포 무료) 측면에서 더 뛰어납니다.
02Laya의 주요 기능
단일 순전파 의사결정: 상태 텍스트와 유형화된 질문 세트를 입력하면 텍스트를 생성하지 않고 한 번의 순전파로 구조화된 결과를 직접 반환하며, 약 33ms가 소요됩니다.
세 가지 의사결정 원시 타입: choice는 후보 중 하나를 선택하고 각 항목의 확률을 제공합니다. score는 순서형 척도에 점수를 매기고 분포를 제공합니다. noul은 예/아니요 질문에 답하고 성립 확률을 0–1로 반환합니다.
자동 언어 라우팅: Router가 0.5ms 이내에 입력 스크립트와 언어를 감지하고 영어 또는 다국어 체크포인트로 자동 분배해, 잘못된 모델을 선택하여 ‘자신 있게 틀리는’ 문제를 방지합니다.
신뢰도 게이팅: 확률은 RLCD 학습을 통해 통계적 의미를 갖습니다. 임계값에 따라 신뢰도가 높은 의사결정은 자동 승인하고, 낮은 신뢰도의 결과는 사람에게 전달할 수 있습니다.
내장 워크플로 사전 설정: 모델 라우팅, 프롬프트 주입 방어, 콘텐츠 안전성 검토, 티켓 분류 등의 사전 정의된 질문 템플릿을 제공해 바로 사용할 수 있습니다.
로컬 미세 조정: Kaggle notebook을 제공하며, 자체 데이터로 데이터 생성, RLCD 학습, 온도 피팅, 평가를 수행하는 전체 미세 조정 과정을 지원합니다.
03Laya의 기술 원리
WeChat에서 팔로우한 뒤 “开源”라고 답장하여 AI 오픈 소스 프로젝트 교류 그룹에 참여하세요.
양방향 비자기회귀 아키텍처: ModernBERT-large(421M) 또는 mmBERT-base(322M) 양방향 인코더를 기반으로 하며, 입력 토큰이 앞뒤 문맥을 동시에 볼 수 있습니다. 추론 시 글자를 하나씩 생성하지 않고 각 후보에 독립적인 [MASK] 위치를 할당해 한 번의 순전파로 모든 후보의 logits를 출력한 다음 Softmax로 정규화하여 확률 분포를 만듭니다. 이것이 33ms 수준의 지연 시간이 가능한 이유입니다.
RLCD 강화 학습: 로그 점수, 구면 점수, 등급 확률 점수 등 엄격한 참값 점수 규칙을 보상으로 사용합니다. 모델은 실제 사후 확률을 출력할 때만 높은 점수를 얻으므로, 불확실할 때 신뢰도가 자연스럽게 낮아져 기존 대규모 모델의 ‘맹목적인 자신감’ 문제를 방지합니다.
언어 라우팅 메커니즘: Router는 forward 전에 순수 Python으로 Unicode 문자 집합과 언어를 감지하고 이에 따라 체크포인트를 선택합니다. 영어 체크포인트는 비라틴 문자에서 0.95의 신뢰도로 정확도 0인 답을 낼 수 있어 신뢰도 자체로는 사전에 경고할 수 없으므로, 라우팅 결정은 추론 전에 완료되어야 합니다.
확률 보정: 배포 체크포인트에는 과도한 자신감이 존재하므로, 자체 데이터에서 (질문 유형, 선택지 수)에 따라 온도를 피팅해야 합니다. 피팅 후 평균 ECE는 0.466에서 0.081로 낮아질 수 있으며, 이때 확률을 자동 승인 결정에 직접 사용할 수 있습니다.
04Laya 사용 방법
설치: PyPI 패키지인 laya를 pip install laya로 설치합니다. 이틀 만에 0.1.0에서 0.3.4로 업데이트되었으므로 인터페이스가 아직 변경 중이라는 점에 유의하세요.
모델 로드: Router(preload=True)는 세 개의 체크포인트를 미리 로드해, 콜드 스타트 시 언어를 전환할 때마다 모델을 다시 구축하지 않도록 합니다.
상태 준비: 분석할 텍스트를 {"from": ..., "subject": ..., "body": ...}와 같은 dict로 구성합니다. 모든 언어 또는 JSON 구조를 지원합니다.
질문 정의: JSON으로 유형화된 질문 세트를 작성하고 type(choice / score / noul), instructions 및 criteria(선택지 또는 척도)를 지정합니다.
예측 실행: router.predict(state, questions)를 호출하면 한 번의 순전파로 모든 답변을 반환합니다. 영어는 laya를 사용하고 Hindi 등은 자동으로 multilingual을 사용합니다.
결과 읽기: res["answers"]에서 choice 레이블, score 점수 또는 noul 확률을 가져옵니다. res["routing"]에서는 해당 체크포인트를 선택한 이유를 확인할 수 있습니다.
신뢰도 게이팅: confidence에 임계값(예: 0.85)을 설정해 신뢰도가 높으면 자동 처리하고 낮으면 사람에게 전달합니다. 단, 먼저 자체 데이터에서 온도 피팅을 수행해야 합니다.
05Laya의 핵심 장점
초고속 추론: 단일 순전파에 약 33ms(T4)가 소요되며, 배치 처리 시 최저 7.2ms/문항입니다. 폐쇄형 TypeSafe Jev보다 약 7.8배 빠릅니다.
환각 위험 없음: 텍스트를 생성하지 않고 구조화된 의사결정만 출력하므로 파싱 부담이 없으며 내용을 지어낼 문제도 없습니다.
확률 보정 가능: RLCD의 엄격한 참값 점수 규칙으로 학습되어 신뢰도가 통계적 의미를 가지며, 자동 승인 및 수동 검토 프로세스를 직접 구동할 수 있습니다.
뛰어난 보정 정확도: 온도 피팅 후 ECE가 0.081에 불과해 Jev의 0.246보다 우수하며, typed-decisions 정확도도 0.766으로 Jev의 0.727을 넘어섭니다.
다국어 라우팅: 내장 Router가 1ms 미만으로 100개 이상의 언어를 식별하고 체크포인트를 자동 선택해, 영어 모델이 비라틴 문자에서 ‘자신 있게 틀리는’ 문제를 방지합니다.
완전 오픈 소스 및 무료: Apache-2.0 라이선스, 공개 가중치, 자체 호스팅을 지원합니다. Jev의 $0.042/백만 token API 비용과 비교하면 장기 사용 비용이 없습니다.
유형화된 출력: choice / score / noul 세 가지 원시 타입으로 분류, 점수 매기기, 예/아니요 판단 등 대부분의 구조화된 의사결정 시나리오를 지원합니다.
06Laya 프로젝트 주소
GitHub 저장소: https://github.com/NandhaKishorM/laya
HuggingFace 모델 저장소: https://huggingface.co/convaiinnovations/laya
07Laya의 활용 사례
고객 지원 티켓 자동 분류: 담당 부서(billing/technical/sales), 긴급도, 사용자 불만 및 이탈 위험을 판단하고, 신뢰도가 높으면 자동 배정하며 낮으면 사람에게 전달합니다.
콘텐츠 안전 및 검토: 유해성, 괴롭힘, 위협 콘텐츠를 감지하고 noul 원시 타입으로 위반 확률을 출력해 커뮤니티와 UGC 플랫폼의 실시간 검토에 적합합니다.
프롬프트 주입 방어(Guardrails): Agent 시스템 진입점에서 탈옥, 주입, 키 유출 등의 공격을 감지하며, 33ms 수준의 지연 시간으로 모든 요청 흐름에 삽입할 수 있습니다.
지능형 모델 라우팅: 혼합 대규모 모델 아키텍처에서 요청을 소형 모델로 처리할지 최첨단 모델로 처리할지 판단합니다. 매우 낮은 비용으로 라우팅 결정을 수행해 추론 비용을 절감합니다.
© 면책 조항: 도메인 및 연결된 콘텐츠는 시간이 지나면서 변경될 수 있습니다. AIEZZ은(는) 제3자 웹사이트를 관리하지 않습니다. 외부 콘텐츠와 위험을 독립적으로 검토하세요.
사용자 리뷰0