
- 월간 방문 수
- 0
- 가격
- 설정되지 않음
- 등록일
- —
- 업데이트됨
- 2026-09-28
01Kev란 무엇인가
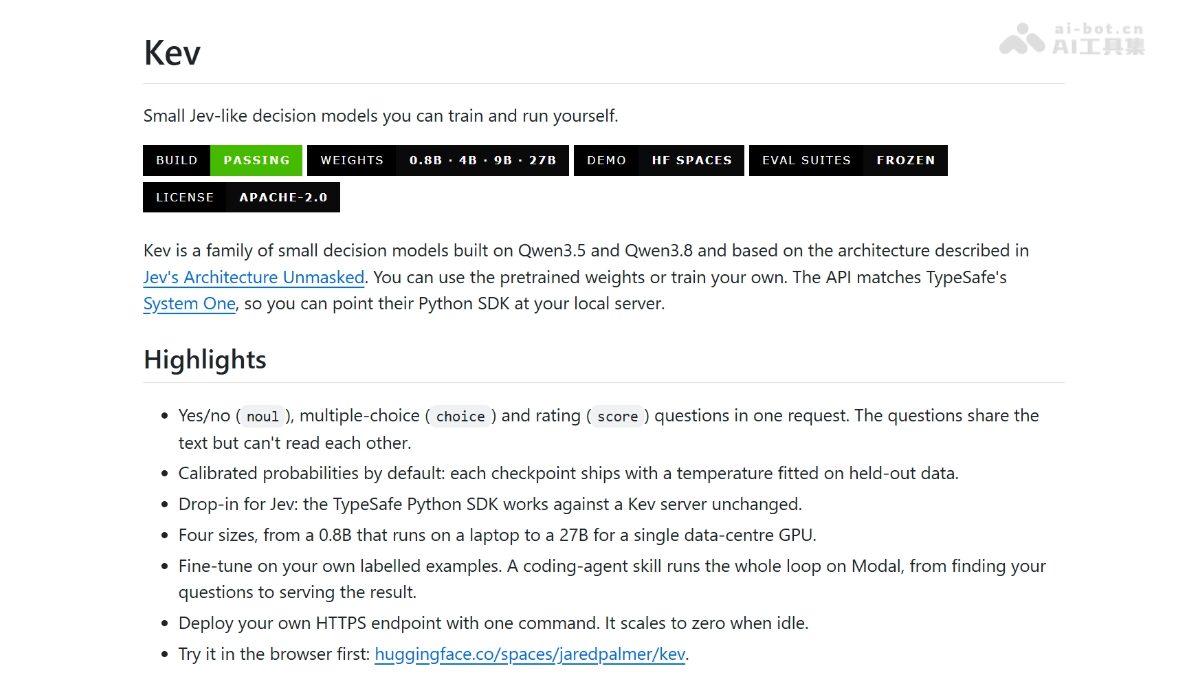
Kev는 Cognition의 엔지니어링 부사장 Jared Palmer가 공개한 의사결정 모델 제품군으로, Qwen3.5/Qwen3.8을 기반으로 하며 0.8B부터 27B까지 여러 모델을 제공합니다. Kev는 텍스트를 생성하지 않고 상태 텍스트와 구조화된 질문을 입력받아 한 번의 순전파로 보정된 확률을 직접 출력합니다. 예/아니요, 선택지 라우팅, 등급 점수의 세 가지 의사결정을 지원하며 TypeSafe System One API와 호환됩니다.
02Kev의 주요 기능
구조화된 의사결정: 상태 텍스트와 여러 구조화된 질문을 입력하면 한 번의 요청으로 각 선택지의 보정된 확률을 직접 출력하며, 설명 텍스트는 생성하지 않습니다.
세 가지 의사결정 원시 기능: noul, choice, score를 지원합니다.
일괄 질문 격리: 여러 질문이 동일한 입력 상태를 공유하면서 어텐션 마스크로 서로 격리됩니다. 한 번의 순전파로 모든 질문에 동시에 답하고 서로 영향을 주지 않습니다.
로컬 배포: kev.serve 한 줄 명령으로 서비스를 실행하고 POST /v1/systemone 엔드포인트를 제공합니다. CUDA, ROCm, Apple Silicon(MLX)과 호환됩니다.
저비용 파인튜닝: 자체 라벨링 데이터로 공식 checkpoint를 기반으로 계속 학습할 수 있습니다. kev-finetune skill을 사용하면 coding agent가 데이터 정리, 학습, 평가, 배포의 전체 과정을 자동으로 수행합니다.
내장 평가 체계: 동결 평가 세트를 내장하고 정확도, Brier 점수, 보정 오차, 자동화 가능한 의사결정 비율을 보고합니다. 또한 CI가 릴리스 수치를 자동으로 검증합니다.
03Kev의 기술 원리
微信关注回复“开源”,加入AI开源项目交流群
포인터 헤드로 생성을 분류로 전환: Kev는 Qwen 기반 모델의 가중치를 동결하고 rank-16 LoRA 어댑터와 포인터 헤드를 추가합니다. 각 후보 항목의 은닉 상태와 질문의 은닉 상태를 점수화한 뒤 softmax를 적용해 확률을 얻습니다. 본질적으로 대규모 모델의 “서술형 문제”를 “선택형 문제”로 바꾸어 토큰 단위 생성을 건너뜁니다.
블록 인과 어텐션으로 질문 격리: 입력 시퀀스를 “상태 + 여러 질문 블록”으로 구성하고, 어텐션 마스크를 통해 각 토큰이 상태와 현재 질문 내부만 읽도록 합니다. 위치 ID는 각 질문에서 다시 계산되므로 한 번의 순전파로 서로 관련 없는 여러 질문에 동시에 답할 수 있으며, 상태 계산을 공유하면서 서로 정보를 노출하지 않습니다. Qwen3.5/3.8과 같은 혼합 Gated DeltaNet 모델에서는 질문마다 독립적인 행으로 구성하고 상태 KV 캐시를 재사용하여 더 엄격하게 격리합니다.
학습 및 보정: 정답 레이블에 교차 엔트로피를 적용해 adapter와 포인터 헤드를 학습하며, 기반 모델은 전체 과정에서 동결합니다. 각 checkpoint는 홀드아웃 데이터에서 온도 매개변수를 학습합니다. 추론 시 보정된 확률을 직접 출력하며, 온도는 순위를 바꾸지 않고 신뢰도 수치만 보정합니다.
04Kev 사용 방법
환경 준비: Python 3.12/3.13과 uv를 설치하고 저장소를 클론한 뒤 uv sync --extra serve를 실행해 의존성을 설치합니다.
로컬 서비스 시작: KEV_DTYPE=bf16 uv run --extra serve python -m kev.serve --run jaredpalmer/kev-4b --port 8009를 실행해 모델을 시작합니다. 최초 실행 시 가중치가 자동으로 다운로드됩니다.
의사결정 요청 전송: POST /v1/systemone에 state 텍스트와 questions를 제출하면 각 선택지의 보정된 확률을 반환합니다.
Python SDK 호출: TypeSafe 공식 SDK에서 base_url을 로컬 서비스로 지정하면 기존 Jev 애플리케이션을 수정 없이 전환할 수 있습니다.
브라우저에서 체험: Hugging Face Space에 접속하거나 playground를 로컬에서 실행하면 설치 없이 체험할 수 있습니다.
자체 데이터 파인튜닝: JSONL 형식의 라벨링 데이터를 준비하고 uv run python -m kev.train --init_from jaredpalmer/kev-4b ...를 사용해 공식 checkpoint를 기반으로 계속 학습합니다.
Agent 완전 자동 파인튜닝: npx skills add jaredpalmer/kev@kev-finetune을 실행한 뒤 coding agent가 문제 찾기, 데이터 생성, 학습, 평가, 배포의 전체 과정을 수행하도록 할 수 있습니다. 로컬 GPU가 필요하지 않습니다.
클라우드 배포: pip install modal && modal deploy kev_serve.py를 실행하면 HTTPS 엔드포인트를 한 번에 배포할 수 있습니다. 유휴 상태에서는 자동으로 0으로 축소되어 비용이 발생하지 않습니다.
평가 검증: uv run python -m kev.benchmark --run <모델> --suite evals/v4/transfer-v4를 사용해 동결 평가 세트에서 성능을 검증합니다. 먼저 평가한 후 출시합니다.
05Kev의 핵심 장점
매우 낮은 비용: 한 번의 순전파로 확률을 직접 출력해 토큰 단위 생성을 생략합니다. H100에서 6개 질문에 답하는 데 18ms만 걸리며, 자체 구축 후에는 호출 비용이 없습니다.
저렴하고 재현 가능한 학습: 공식 3개 모델의 이식 학습 비용은 약 95달러에 불과하며, 개인 파인튜닝은 1회 약 1달러입니다. 전체 청구 내역이 공개되어 투명합니다.
개방형 생태계와 제어권: Apache-2.0 라이선스에 따라 가중치, 학습 코드, 동결 평가 세트를 모두 공개합니다. 직접 학습하고 감사할 수 있으며 공급업체 종속이 없습니다.
API 즉시 사용: TypeSafe System One과 완전히 호환되므로 기존 Jev 애플리케이션은 base_url만 변경하면 수정 없이 전환할 수 있습니다.
여러 질문을 한 번에 처리: 입력 상태를 공유하고 블록 인과 어텐션으로 격리하여 한 번의 순전파로 원하는 수의 질문에 동시에 답하며 서로 영향을 주지 않습니다.
06Kev 프로젝트 주소
GitHub 저장소:https://github.com/jaredpalmer/kev
07Kev의 활용 사례
고객 지원 티켓 라우팅: 한 번의 순전파로 “어느 부서로 보낼지, 상담원에게 에스컬레이션할지, 고객의 분노 수준”을 동시에 판단하고, 확률 임계값에 따라 자동으로 분류합니다. 신뢰도가 낮으면 상담원에게 전달합니다.
콘텐츠 안전 검토: UGC 텍스트에 대해 “noul 위반 여부 + choice 위반 유형 + score 심각도”를 병렬로 실행하고, 신뢰도가 높으면 자동으로 처리합니다.
금융/신용 사전 심사: 민원 유형, 상담원 개입 필요 여부, 위험 등급을 판단하며, 확률 분포를 활용해 규정 준수 기록과 수동 검토 우선순위를 지원합니다.
전자상거래 상품/의도 분류: 사용자 검색어를 검색, 추천, 애프터서비스 등 하위 시스템으로 라우팅하고, “하나의 단어가 여러 카테고리에 해당하는” 멀티라벨 분포 문제를 처리합니다.
© 면책 조항: 도메인 및 연결된 콘텐츠는 시간이 지나면서 변경될 수 있습니다. AIEZZ은(는) 제3자 웹사이트를 관리하지 않습니다. 외부 콘텐츠와 위험을 독립적으로 검토하세요.
사용자 리뷰0