
모든 AI 도구
AI 모델 평가
AI 모델 평가 분야의 인기 AI 제품을 모아 창작, 처리 및 효율 향상 등 다양한 사용 사례를 다룹니다.
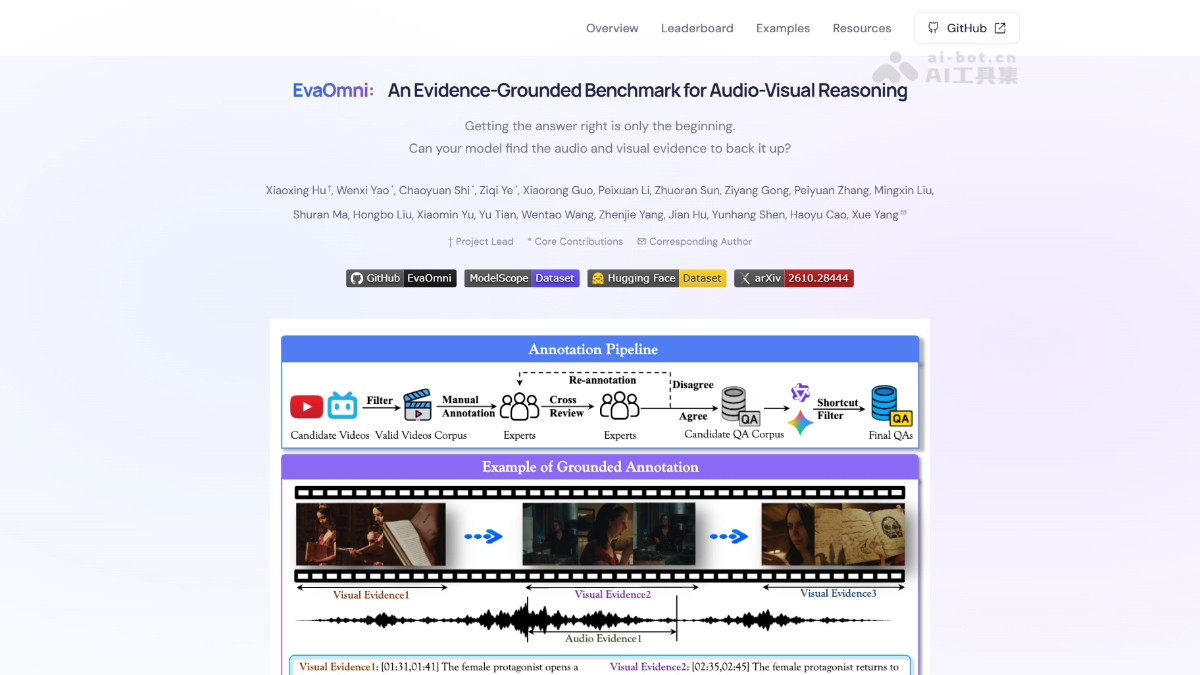 EvaOmniAI 모델 평가EvaOmni는 상하이교통대학교, 푸단대학교, 텐센트 유투 등이 오픈 소스로 공개한 전모달 대규모 모델 평가 벤치마크로, 실제 동영상 392개와 사람이 주석을 단 질의응답 1,027개를 포함하며 15가지 능력과 3개 추론 수준을 다룹니다. EvaOmni는 동...00
 MOSS-LiveAI 모델 평가MOSS-Live는 모쓰 인텔리전스가 출시한 전이중 실시간 상호작용 시스템입니다. MOSS-Live는 AI가 실제 사람처럼 들으면서 말할 수 있도록 하며, 의미 수준에서 언제 응답하고 기다리거나 끼어들기를 받아들일지 판단합니다. 맞장구 소리와 주변 소리에 오작동하지 않으며, 시...00
 Microsoft-Decision-1AI 모델 평가Microsoft-Decision-1은 Microsoft가 출시한 차세대 고속 의사결정 AI 모델로, 구조화된 의사결정 작업을 위해 설계되었습니다. 사전 설정된 선택지에서 최적의 해답을 선택하고 각 대안에 확률 점수를 부여하여 하위 애플리케이션이 실행...00
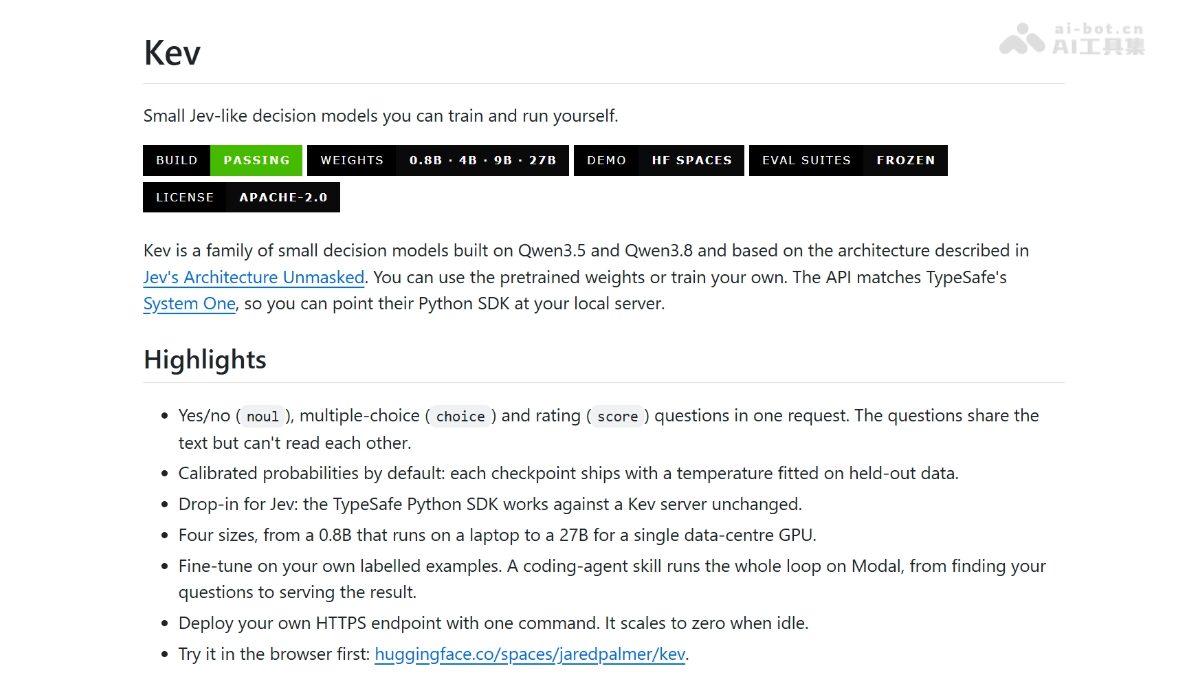 KevAI 모델 평가Kev란 무엇인가 Kev는 Cognition의 엔지니어링 부사장 Jared Palmer가 공개한 의사결정 모델 제품군으로, Qwen3.5/Qwen3.8을 기반으로 하며 0.8B부터 27B까지 여러 모델을 제공합니다. Kev는 텍스트를 생성하지 않고 상태 텍스트와 구조화된 질문을 입력받아...00
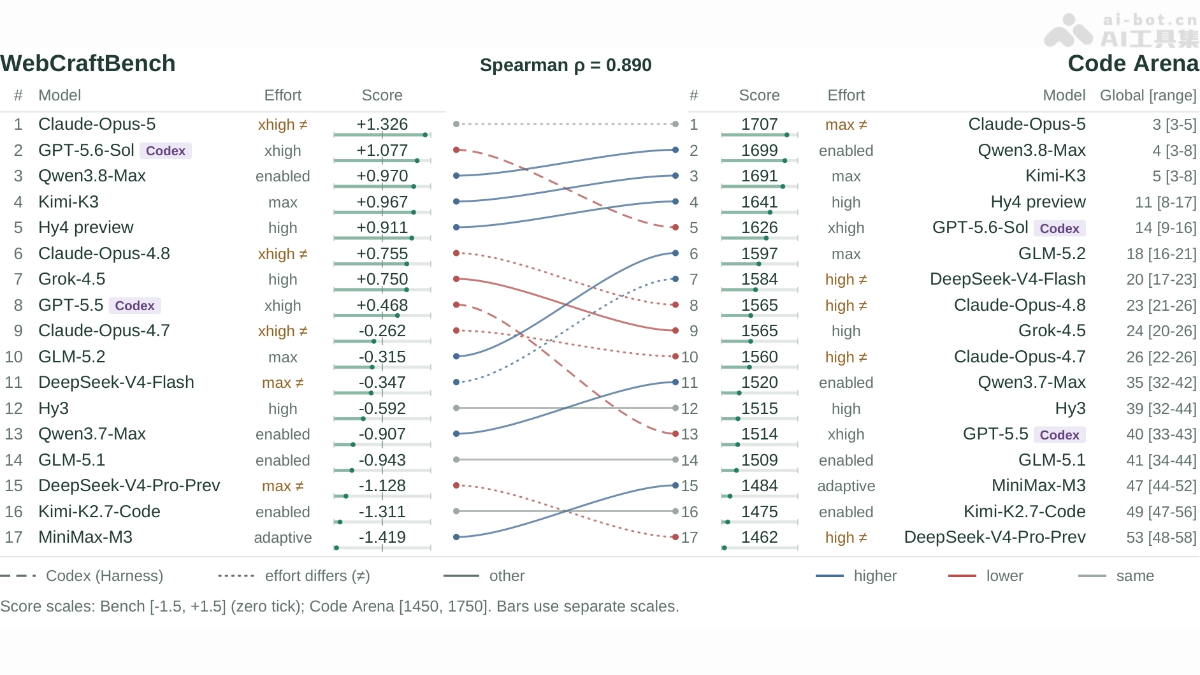 WebCraftBenchAI 모델 평가WebCraftBench는 텐센트 혼위안이 칭화대학교, 베이징대학교와 공동으로 출시한 AI 웹 생성 평가 벤치마크입니다. WebCraftBench는 먼저 생성된 애플리케이션에 자동 계측을 적용하고, 에이전트가 Playwright를 통해 웹페이지를 실제로 조작하며 기능을 탐색하도록 한 뒤,...00
 PixRestoreAI 모델 평가PixRestore는 홍콩 폴리테크닉대학교와 OPPO 연구원이 공동 출시한 통합 이미지 복원 모델입니다. 이 모델은 픽셀 공간 Diffusion Transformer를 사용해 픽셀 수준에서 직접 flow matching을 수행하여 세...00
 E-Bench – 텐센트 위안바오 등이 출시한 에이전트 평가 벤치마크AI 모델 평가E-Bench는 텐센트 위안바오 팀이 칭화대학교 AIR, 동남대학교와 공동으로 출시한 다단계 도구 사용 평가 벤치마크입니다. 왕저룽야오, QQ 뮤직, 텐센트 회의를 기반으로 완전 합성 가상 환경을 구축했으며, 323개의 상태 변경 작업과 7.6만 건 이상의 데이터를 포함합니다. 정보 격차와 도구 격차의 이중 비대칭 설계를 통해 모델이 능동적으로 정보를 수집하고 여러 단계의 도구 호출을 조율하는 능력을 평가하며, 결정론적 데이터베이스 상태 diff 방식으로 점수를 산정해 결과의 안정성과 재현성을 보장합니다. 이 벤치마크는 AI 에이전트 연구자와 모델 개발자를 대상으로 하며, 높은 가성비의 모델을 식별하고 범용 에이전트 평가 표준 수립을 지원합니다.00
이 카테고리의 모든 도구가 표시됩니다.