
- 월간 방문 수
- 0
- 가격
- 설정되지 않음
- 등록일
- —
- 업데이트됨
- 2026-09-16
01Iris란 무엇인가
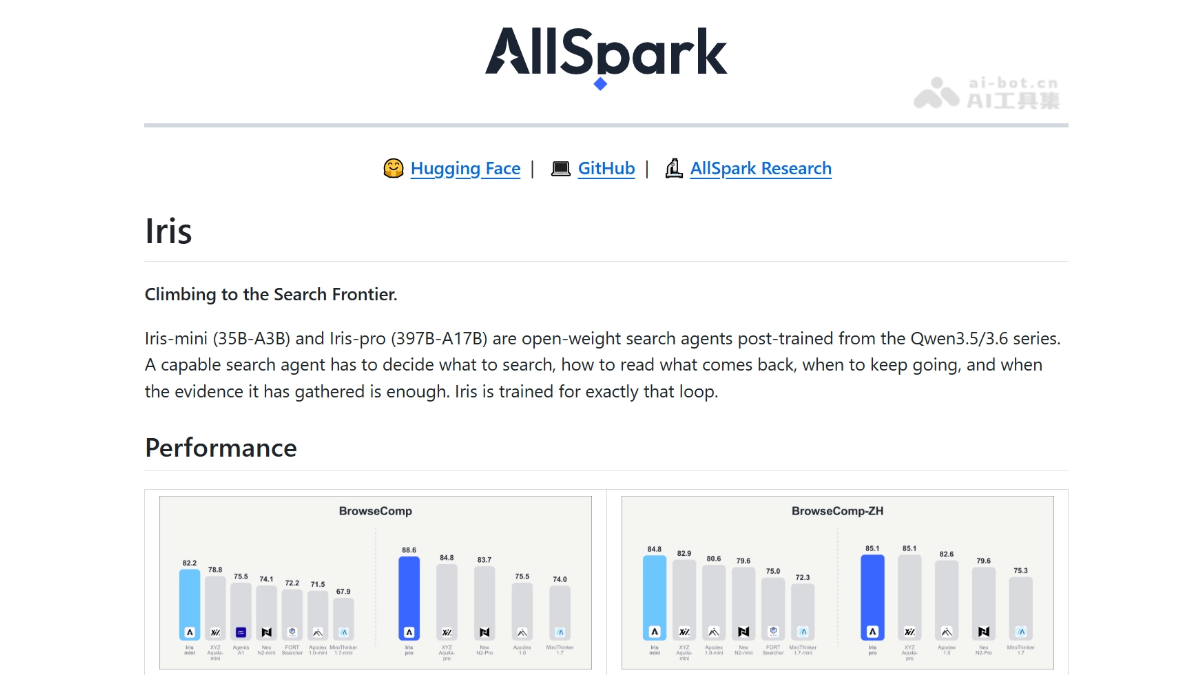
Iris는 샤오홍슈 AllSpark 팀이 오픈 소스로 공개한 검색 에이전트로, 35B(Iris-mini)와 397B(Iris-pro) 두 버전으로 제공됩니다. Iris는 실제 웹에서 무엇을 검색할지, 검색 결과를 어떻게 읽을지, 언제 검색을 멈추고 답변을 수렴할지 자율적으로 결정합니다. 웹페이지의 하이퍼링크에서 충분히 어렵지만 해결 가능한 학습 데이터를 역으로 구성하고, SFT와 강화학습을 교차 적용하는 SFT–RL Climbing 학습 방식을 사용합니다. BrowseComp, DeepSearchQA, HLE 등 4개 주요 벤치마크에서 동급 최강의 오픈 소스 성능을 달성했으며, 35B 버전은 조 단위 파라미터 모델에 근접한 성능을 보여 검색 능력을 범용 도구 호출 등의 작업으로 확장할 수 있습니다.
02Iris의 주요 기능
자율 웹 검색: 무엇을 검색할지, 검색 결과를 어떻게 읽을지, 언제 계속하거나 멈출지를 스스로 결정하며 검색과 추론을 병행해 답변합니다.
다단계·다중 페이지 추론: 키워드 매칭으로 지름길을 택하지 않고 여러 웹페이지를 단계적으로 탐색해 유일한 답을 찾아냅니다.
중국어·영어 복합 검색: BrowseComp, BrowseComp-ZH 등 중국어와 영어 웹 검색 작업에서 모두 동급 최강의 오픈 소스 성능을 달성했습니다.
증거 포괄형 질의응답: 답변 시 증거 사슬을 완전하게 포괄하며, DeepSearchQA에서 앞선 성능을 보입니다.
전문가 수준의 난제 해결: 전문가급 추론이 필요한 HLE와 같은 고난도 문제를 처리할 수 있습니다.
컨텍스트 관리: 절단, 압축 등의 컨텍스트 관리 전략을 지원해 장시간 검색이 중단되지 않으며, 소형 모델에서 특히 효과가 큽니다.
능력 확장: 별도의 전문 학습 없이도 범용 도구 호출과 사무 협업 등의 작업을 수행할 수 있습니다.
03Iris의 기술 원리
WeChat에서 팔로우한 뒤 “开源”로 답장하면 AI 오픈 소스 프로젝트 교류 그룹에 참여할 수 있습니다.
역방향 문제 생성 데이터 구축: 시드 페이지를 정답으로 삼고 하이퍼링크를 따라가 엔터티 그래프를 구성합니다. 그래프에서 반드시 여러 페이지를 거쳐 다단계 추론을 해야 하는 문제를 생성한 뒤, 문제에 포함된 정답 이외의 엔터티를 설명적 지시어로 바꿔 매칭 가능한 단서를 제거합니다. 마지막으로 참조 모델을 사용해 이중 필터링하고, 오픈북 없이 답할 수 없지만 증거를 제공하면 유일하게 정답을 맞힐 수 있는 문제만 남깁니다. 전 과정은 자동화되어 코퍼스 규모에 따라 확장할 수 있습니다.
SFT–RL Climbing 교차 학습: SFT 단계에서는 강력한 교사 모델이 실제 검색 도구에서 생성한 궤적을 결과 필터와 ‘심판’의 단일 단계 필터를 거쳐 학습합니다. RL 단계에서는 모델이 실제 웹에서 검색하며 학습하도록 하고, 각 라운드가 끝나면 가장 풀기 어렵지만 정답을 맞힌 궤적과 가장 효율적으로 해결한 궤적을 다음 SFT 라운드에 다시 투입합니다. 모델이 강해질수록 문제도 자동으로 어려워져 적응형 커리큘럼이 형성됩니다.
학습 엔지니어링의 내재화: 채점과 요약을 자체 구축한 모델로 학습 클러스터 내부에서 처리하므로 외부 API에 의존하지 않고 네트워크 변동이 학습 루프를 방해하는 것을 방지합니다. 또한 학습과 온라인 사용에 동일한 요약기를 사용해 학습과 추론 간 불일치를 없앱니다.
초장문 궤적의 중단 지점부터 재실행: 일부 병목이 되는 초장문 세션을 통째로 폐기하지 않고 요청 단위로 중단한 뒤, 다음 단계에서 이미 제출된 접두부부터 계속 실행합니다. 이를 통해 동기식 스케줄링에서도 GPU의 높은 활용률을 유지합니다.
정렬형 평가 프로토콜: 모든 비교 시스템을 동일한 도구, 컨텍스트, 채점 모델 및 동일한 컨텍스트 관리 전략 아래 단일 ReAct 에이전트로만 평가합니다. 다중 에이전트와 테스트 시 자기 검증 등의 프레임워크 차원의 편법을 배제해 점수가 모델 자체의 능력을 실제로 반영하도록 합니다.
04Iris 사용 방법
코드 저장소 복제: git clone https://github.com/AllSpark-Research/Iris를 실행해 추론 및 평가 코드를 가져옵니다.
모델 가중치 다운로드: HuggingFace 컬렉션 huggingface.co/collections/AllSpark-Research/iris에서 Iris-mini(35B) 또는 Iris-pro(397B) 가중치를 다운로드합니다.
실행 환경 구성: 저장소 요구사항에 따라 의존성(예: vLLM/SGLang 등 추론 프레임워크)을 설치하고 검색 도구 인터페이스를 구성합니다. 네트워크 검색은 Search Agent의 필수 전제입니다.
모델 로드 및 도구 연결: ReAct 에이전트 형식으로 모델을 로드하고 검색 엔진을 모델이 호출할 수 있는 도구로 등록합니다.
질문 입력 후 추론 실행: 질문을 입력하면 모델이 검색 쿼리를 자동으로 계획하고 웹페이지를 읽은 뒤 다단계 추론을 수행해 증거가 포함된 답변으로 수렴합니다.
05Iris의 핵심 강점
동급 최강의 오픈 소스 성능: BrowseComp, BrowseComp-ZH, DeepSearchQA, HLE 등 4개 검색 벤치마크에서 동급 오픈 소스 모델을 전반적으로 앞서며, 397B Iris-pro는 일부 항목에서 조 단위 파라미터 모델을 넘어섭니다.
소형 규모로 초대형 모델에 근접: 35B Iris-mini는 BrowseComp에서 82.2점을 기록해 수십 배 많은 파라미터를 가진 Kimi-K2.6 등의 모델에 근접했습니다. 이를 통해 소형 모델도 특정 분야에서 초대형 모델에 도전할 수 있음을 보여줍니다.
자동화되고 높은 품질의 데이터 구축: 웹페이지 하이퍼링크에서 문제를 역으로 생성하고, 매칭 가능한 단서를 제거한 뒤, ‘충분히 어렵고 해결 가능한’ 문제를 이중 필터링합니다. 전 과정에 사람의 문제 출제가 필요하지 않으며 코퍼스 규모에 따라 무한히 확장할 수 있습니다.
안정적이고 효율적인 학습 엔지니어링: 채점과 요약을 학습 클러스터에 내재화해 외부 API 의존성을 완전히 제거했습니다. 초장문 궤적의 중단 지점부터 재실행하는 방식으로 GPU를 지속적으로 높은 부하로 유지해 학습의 불확실성을 크게 줄입니다.
학습과 온라인 사용의 일관성: 학습 중 검색 내용을 압축하는 요약기와 평가 및 온라인 사용에 쓰이는 요약기가 동일해 학습과 사용 간 불일치가 없습니다.
확장되는 능력과 높은 범용성: 검색 능력이 범용 도구 호출과 사무 협업 등 별도의 전문 학습을 받지 않은 작업으로 일반화됩니다. Search는 재사용 가능한 원자적 능력입니다.
06Iris 프로젝트 주소
GitHub 저장소: https://github.com/AllSpark-Research/Iris
HuggingFace 모델 컬렉션: https://huggingface.co/collections/AllSpark-Research/iris
arXiv 기술 논문: https://arxiv.org/pdf/2609.04304
07Iris의 활용 분야
심층 연구 및 조사 보고서: 자동 다중 라운드 검색, 다중 페이지 추론, 완전한 증거 포괄을 지원해 산업 연구, 경쟁사 분석, 학술 조사 등 Deep Research 유형의 제품에 적합합니다.
복잡한 사실 확인: 여러 웹페이지를 거쳐 다단계로 답을 확정해야 하므로 허위 정보 반박, 사실 확인, 실사 등 ‘출처를 반드시 찾아야 하는’ 상황에 적합합니다.
중국어·영어 이중 언어 검색: BrowseComp와 BrowseComp-ZH에서 모두 우수한 성능을 보여 중국어와 영어가 혼합된 코퍼스의 국경 간 정보 검색에 자연스럽게 적합합니다.
범용 도구 호출 에이전트: BFCL, τ-bench 등의 General Tool Use 작업으로 능력을 확장할 수 있어 Agent 제품의 범용 기반으로 활용할 수 있습니다.
사무 협업(Cowork): OfficeQA, APEX 등의 사무 작업에서 별도의 전문 학습 없이도 사용할 수 있어 문서 질의응답과 업무 프로세스 작업을 처리하는 사무 보조 도구에 적합합니다.
© 면책 조항: 도메인 및 연결된 콘텐츠는 시간이 지나면서 변경될 수 있습니다. AIEZZ은(는) 제3자 웹사이트를 관리하지 않습니다. 외부 콘텐츠와 위험을 독립적으로 검토하세요.
사용자 리뷰0