
- 월간 방문 수
- 0
- 가격
- 무료 및 유료
- 등록일
- 2026-08-07
- 업데이트됨
- 2026-08-07
01SALMONN-2란 무엇인가
SALMONN-2는 칭화대학교, 상하이 인공지능 연구소, 케임브리지대학교가 공동으로 오픈 소스로 공개한 범용 오디오 대규모 언어 모델입니다. 바이트댄스의 SPEAR 통합 자기지도 오디오 인코더와 다층 특징 융합 어댑터를 기반으로 구축되었으며, Qwen3를 텍스트 기반 모델로 사용합니다. 약 1.8만 시간의 지도 데이터만으로 MMAU-Pro, MMAR, MMSU 등 3대 종합 벤치마크에서 동급 오픈 소스 모델 중 최고의 성능을 달성했으며, 범용 ALLM에서 처음으로 음향 이벤트 감지, 오디오 위조 감지, 음성 품질 평가, 멀티모달 컨텍스트 음성 인식 등의 고급 기능을 체계적으로 구현했습니다.
02SALMONN-2의 주요 기능
범용 오디오 이해: 음성 인식, 오디오 설명, 음악 이해, 감정 인식, 화자 검증 등 도메인 간 작업을 지원합니다.
음향 이벤트 감지(SED): 개 짖는 소리, 발걸음 소리 등 환경 음향 이벤트의 시작 및 종료 시간 구간을 찾아 출력할 수 있습니다.
오디오 딥페이크 감지: 음성이 진짜인지 판별하고, 합성 또는 편집이 의심되는 일부 구간의 시간 범위를 찾아냅니다.
음성 품질 평가(SQA): 소음, 왜곡, 선명도 등 저수준 음향 특징을 감지하여 품질 점수와 설명을 제공합니다.
멀티모달 컨텍스트 음성 인식(MICL): 문자 표기와 참고 발음 오디오를 결합하여 희귀 단어와 드문 인명의 인식 정확도를 높입니다.
03SALMONN-2의 기술 원리
WeChat에서 ‘开源’를 입력해 답장하면 AI 오픈 소스 프로젝트交流群에 참여할 수 있습니다.
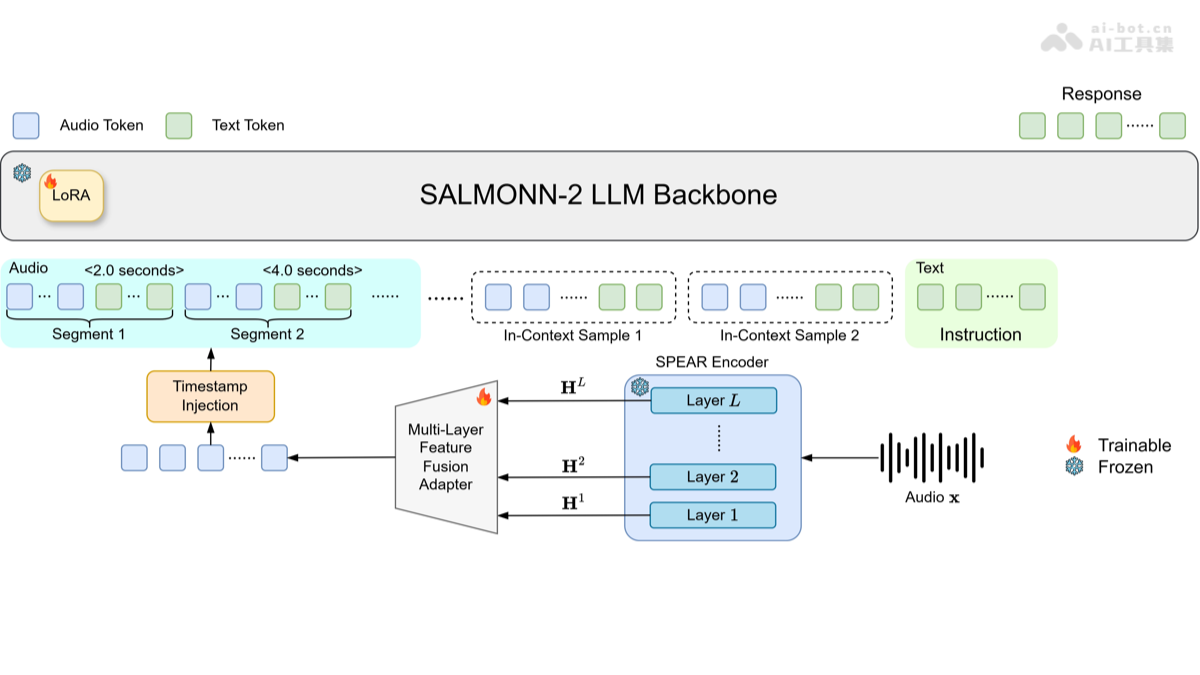
통합 자기지도 오디오 인코더: SALMONN-2는 SPEAR를 단일 오디오 프런트엔드로 사용합니다. 인코더는 대규모 비라벨 오디오 데이터에서 자기지도 학습으로 훈련되어 의미, 발음, 음색, 화자 및 음향 환경 정보를 동시에 포착할 수 있습니다. 이를 통해 기존 Whisper+BEATs 이중 인코더 방식을 대체하면서도 아키텍처를 단순화하고 더욱 균형 잡힌 도메인 간 성능을 유지합니다.
다층 특징 융합(MLF) 어댑터: SPEAR의 각 계층은 서로 다른 수준의 정보를 인코딩합니다. 얕은 계층은 음향 및 발음 세부 정보를 보존하고, 중간 계층은 음색 및 화자 정보를 담으며, 깊은 계층은 의미 개념을 축적합니다. MLF 어댑터는 먼저 각 계층의 은닉 상태를 계층 정규화하고 연결한 다음, 학습 가능한 다운 프로젝션과 프레임 그룹화 압축을 거칩니다. 마지막으로 융합된 계층적 표현을 언어 모델 임베딩 공간으로 매핑하여, 모델이 작업 요구에 따라 서로 다른 수준의 음향 단서를 유연하게 활용할 수 있도록 합니다.
타임스탬프 주입 메커니즘: 모델은 타임스탬프를 자연어 텍스트 형식(예: <2.0 seconds>)으로 오디오 시퀀스에 직접 삽입합니다. 오디오 임베딩과 교차된 형태로 언어 모델에 입력되므로, 별도의 타임스탬프 전용 임베딩 계층 없이 통합 생성 프레임워크에서 시간 위치 지정 작업을 수행할 수 있습니다.
멀티모달 컨텍스트 학습(MICL) 훈련: 컨텍스트 음성 인식 작업에서 모델은 텍스트 편향 단어 목록을 입력받을 뿐 아니라 해당 단어의 참고 발음 오디오도 멀티모달 컨텍스트로 동시에 사용합니다. 훈련 시 방해 단어와 목표 단어를 무작위로 삭제하는 전략을 도입하여 과도한 편향을 방지하고, 음향 증거가 뒷받침될 때 컨텍스트 단서를 합리적으로 활용하도록 학습합니다.
04SALMONN-2 사용 방법
저장소에 접속하여 코드 복제: GitHub 저장소 https://github.com/bytedance/SALMONN/tree/salmonn2에 접속한 뒤 git clone으로 코드를 로컬에 다운로드합니다.
실행 환경 생성: conda create -n salmonn2 python=3.10을 실행하여 가상 환경을 생성하고 활성화한 다음, pip, setuptools, wheel을 업그레이드합니다.
의존성 및 프로젝트 설치: 저장소 루트 디렉터리에서 pip install -r requirements.txt와 pip install -e . --no-deps를 실행하여 SALMONN-2와 런타임 의존성을 설치합니다.
사전 학습 가중치 다운로드: HuggingFace CLI를 통해 모델 체크포인트를 다운로드합니다: hf download marcoyang/SALMONN-2-8B --repo-type model --local-dir /path/to/salmonn-2-hf.
모델 로드 및 추론: AutoProcessor와 AutoModelForCausalLM을 사용해 로컬 가중치를 로드하고, 오디오 파일과 지시문 텍스트를 입력한 뒤 model.generate()를 호출하면 오디오 이해 결과를 얻을 수 있습니다.
05SALMONN-2의 핵심 장점
데이터 효율성: 약 1.8만 시간의 지도 데이터만 사용하여 동급 경쟁 모델에서 흔히 사용하는 수십만~수백만 시간보다 훨씬 적은 데이터로 학습하며, 라벨링 비용을 크게 절감합니다.
더 균형 잡힌 통합 프런트엔드: 단일 SPEAR 자기지도 인코더로 이중 인코더를 대체하여 음성, 환경음, 음악 및 준언어 작업에서 더욱 균형 잡힌 성능을 달성합니다.
계층적 정보의 완전한 활용: MLF 어댑터가 모든 인코더 계층의 특징을 융합하여 마지막 계층만 사용함으로써 음향 및 음색 등 핵심 세부 정보가 손실되는 것을 방지합니다.
확장된 오디오 분석 능력: 범용 ALLM에서 SED, 위조 감지, SQA 등 기존에 간과되었던 음향 분석 작업을 처음으로 체계적으로 지원합니다.
확장 가능한 규모: 텍스트 기반 모델을 8B에서 30B-A3B로 확장한 후 3대 종합 벤치마크 점수가 모두 지속적으로 향상되어, 아키텍처가 우수한 스케일업 잠재력을 갖추었음을 입증했습니다.
06SALMONN-2 프로젝트 주소
GitHub 저장소: https://github.com/bytedance/SALMONN/tree/salmonn2
HuggingFace 모델 저장소: https://huggingface.co/marcoyang/SALMONN-2-8B
arXiv 기술 논문: https://arxiv.org/pdf/2607.17079
07SALMONN-2의 활용 분야
스마트 회의 도우미: 회의 내용을 실시간으로 전사하고, 참석자의 발음 예시를 결합하여 외국인 이름과 전문 용어를 정확하게 인식합니다.
오디오 콘텐츠 검수: 라이브 방송이나 팟캐스트에서 비정상적인 음향 이벤트를 자동으로 감지하고 딥페이크 음성을 식별하여 사기를 예방합니다.
음성 품질 모니터링: 고객 서비스 통화와 녹음 스튜디오 자료의 품질을 자동으로 평가하고, 소음 및 왜곡 구간을 찾아냅니다.
멀티미디어 아카이브 검색: 과거 오디오와 라디오 프로그램에 타임스탬프가 포함된 이벤트 설명을 생성하여 콘텐츠 기반의 정밀 검색을 구현합니다.
청각장애인 보조 기기: 환경 음향 이벤트(예: 초인종, 경보)를 텍스트와 타임스탬프 형식으로 실시간 안내하여 청각장애인 사용자에게 제공합니다.
© 면책 조항: 도메인 및 연결된 콘텐츠는 시간이 지나면서 변경될 수 있습니다. AIEZZ은(는) 제3자 웹사이트를 관리하지 않습니다. 외부 콘텐츠와 위험을 독립적으로 검토하세요.
사용자 리뷰0