
오픈 소스
AIEZZ 도구 태그
“오픈 소스” 태그가 지정된 AI 제품을 탐색 중이며, 일치하는 결과는 29개입니다.
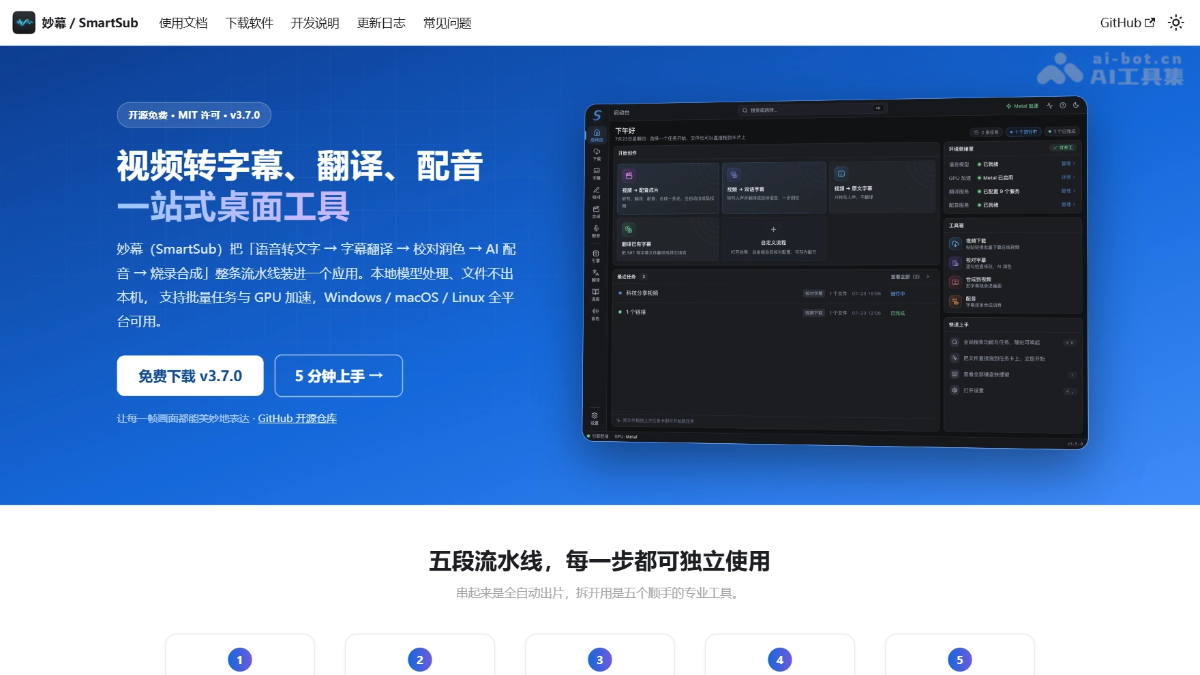 SmartSub – 오픈 소스 올인원 오디오·비디오 자막 처리 데스크톱 도구AI 음성 인식SmartSub(妙幕)는 오픈 소스 올인원 오디오·비디오 자막 처리 데스크톱 도구입니다. 전체 작업 과정을 하나의 애플리케이션으로 통합했으며, Whisper, FunASR, Qwen3-ASR 등의 로컬 모델을 기반으로 오프라인 음성 인식을 지원합니다. 20가지 이상의 번역 서비스와 다중 화자 AI 더빙을 제공하며, Bilibili, YouTube 등 플랫폼과 호환되는 온라인 동영상 다운로더를 내장하고 있습니다. NVIDIA CUDA, Apple Core ML 등의 하드웨어 가속을 지원하며 Windows, macOS, Linux 세 플랫폼에서 로컬로 실행됩니다.00
 InstructAV2AV – 즈위안과 베이징대학교가 공동 오픈소스로 공개한 음영상 통합 편집 모델이미지 편집InstructAV2AV – 즈위안과 베이징대학교가 공동 오픈소스로 공개한 음영상 통합 편집 모델은 베이징 즈위안 인공지능 연구원과 베이징대학교가 공동으로 선보인 음영상 통합 편집 모델입니다. 사용자는 자연어 명령 한 문장만으로 엔드투엔드 생성 과정에서 영상 화면과 해당 음성을 동시에 편집할 수 있으며, 수동 마스크나 단계별 처리도 필요하지 않습니다. 이 모델은 대사 수정, 인물 교체, 객체 삽입 및 삭제를 지원하고 배경음과 환경음을 그대로 유지하면서 영상과 음성의 시간적 동기화를 유지할 수 있습니다. 핵심 기능으로는 정체성 보존 음성 수정, 음영상 인스턴스 교체, 인스턴스 삽입, 인스턴스 제거 및 속성 조합 편집이 있으며, 영화·영상 후반 작업, 숏폼 제작, 가상 인간 운영, 광고 기획 및 인터랙티브 콘텐츠 제작 등의 분야에 활용할 수 있습니다.00
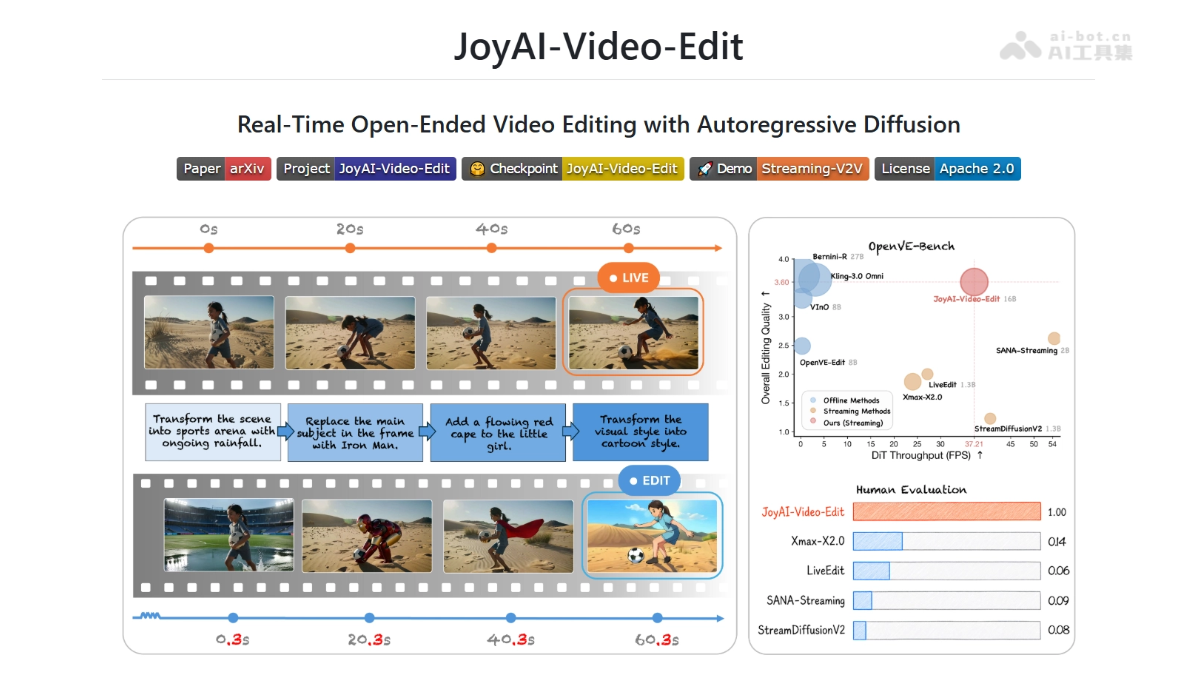 JoyAI-Video-EditAI 동영상 편집JoyAI-Video-Edit – 징둥이 오픈 소스로 공개한 실시간 스트리밍 동영상 편집 모델은 징둥이 자체 개발해 오픈 소스로 공개한 실시간 스트리밍 동영상 편집 모델입니다. 16B 파라미터 자기회귀 확산 아키텍처를 기반으로 720P 해상도에서 30FPS 추론 속도를 구현하며, 길이에 제한 없이 안정적인 스트리밍 편집을 지원합니다. 사용자는 자연어 명령을 통해 동영상 재생 중 인물, 장면, 스타일 및 사물을 실시간으로 수정할 수 있어 전체 동영상 생성이 완료될 때까지 기다릴 필요가 없습니다. 이 모델은 OpenVE-Bench 평가에서 모든 스트리밍 편집 방법을 앞서며 전 지표에서 종합적으로 우수한 성능을 보였고, 동시에 체화 지능을 위한 대규모 데이터 합성 경로를 제공할 수 있습니다.00
 Orchard – Microsoft Research가 오픈 소스로 공개한 Agentic AI 모델링 프레임워크AI 에이전트Orchard – Microsoft Research가 오픈 소스로 공개한 Agentic AI 모델링 프레임워크입니다. 이 프레임워크는 Kubernetes 기반 Orchard Env 환경 서비스를 핵심으로 하며, 여러 도메인에서 샌드박스를 재사용해 데이터 증류, 강화학습 rollout 및 평가를 수행할 수 있도록 지원합니다. 소프트웨어 엔지니어링, 브라우저 탐색, 개인 비서의 세 가지 주요 시나리오를 아우르며, 완전한 SFT + RL 학습 레시피와 107K개의 SWE 트레이스 및 3,070개의 GUI 멀티모달 rollout 데이터를 제공합니다. 또한 Codex, OpenClaw와 같은 실제 harness에서 엔드투엔드 학습을 직접 수행할 수 있습니다. Agent 연구개발을 수행하는 학계 및 산업 연구팀을 대상으로 Orchard는 더 낮은 컴퓨팅 및 호스팅 비용을 제공하며, harness 간 일반화 능력을 통해 더 작은 모델로도 최첨단 성능에 근접하도록 지원합니다.00
 Alpamayo 2 Super – NVIDIA가 오픈 소스로 공개한 자율주행 AI 추론 모델AI 코딩Alpamayo 2 Super는 NVIDIA가 오픈 소스로 공개한 자율주행 AI 추론 모델로, NVIDIA Cosmos 3 Super Reasoner를 기반으로 구축되었으며 360° 환경 인식, 고급 주행 의사 결정 및 자동 추론 라벨 생성 기능을 제공합니다. 이 모델은 LingoQA 자율주행 추론 벤치마크에서 1위를 차지했으며, 허용적인 OpenMDW-1.1 라이선스를 적용해 미세 조정, 파생 모델 개발 및 상업적 재배포를 지원합니다. 또한 클라우드 개발과 차량 내 증류 배포를 위한 Alpamayo 1.5 / 1 버전도 제공하며, Robotaxi와 자율주행 자동차 분야를 대상으로 합니다.00
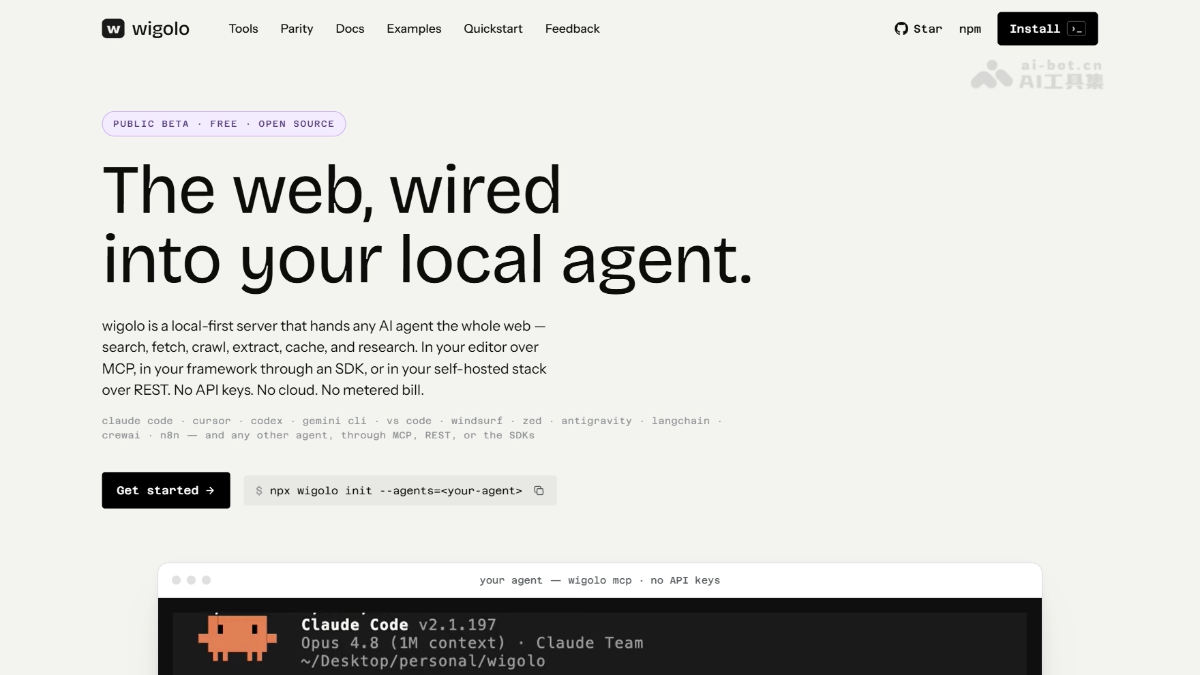 wigoloAI 에이전트wigolo는 MCP를 통해 Claude Code, Cursor 등의 프로그래밍 Agent에 연결할 수 있는 오픈 소스 로컬 검색 도구입니다. API Key 없이 무료로 로컬에서 검색, 웹페이지 가져오기, 전체 사이트 크롤링, 구조화된 데이터 추출,...00
 MemHarness – 상하이 AI Lab 등이 공개한 에이전트 메모리 재구성 프레임워크AI 에이전트MemHarness는 상하이 AI Lab이 저장대학교, 푸단대학교, 상하이교통대학교 등 여러 대학과 공동으로 공개한 LLM Agent 메모리 재구성 프레임워크입니다. 검색과 행동 사이에 비판 및 재구성 단계를 삽입하고, 현재 컨텍스트를 바탕으로 과거 경험을 유지·수정·폐기합니다. 또한 추가적인 수작업 라벨링 없이 GRPO를 통해 엔드투엔드로 학습합니다. 이 프레임워크는 메모리 검색, 비판적 재구성, 행동 생성, 경험 기록 및 가지치기 등 전체 프로세스를 지원하며, 5단계 의사결정 흐름을 제공합니다. 7B 파라미터 모델은 ALFWorld와 WebShop에서 각각 Gemini-2.5-Pro를 23.1%와 39.7% 앞섰으며, 분포 외 시나리오에서 평균 성공률 85.9%를 달성했습니다. 체화 지능 가사 작업, 자율 온라인 쇼핑, 지능형 고객 서비스, 코드 보조 개발 등의 시나리오에 적합합니다.10
 ForgeStencil – 면벽지능이 선보이는 Stencil 완전 자동 연구·배포 시스템AI 에이전트ForgeStencil – 면벽지능이 선보이는 Stencil 완전 자동 연구·배포 시스템은 면벽지능과 OpenBMB 커뮤니티가 공동 개발했으며, Kernel Agent와 App Agent로 구성된 이중 에이전트 폐쇄 루프 아키텍처를 채택했습니다. 최적화 전략 발견, 고성능 CUDA Kernel 합성, 운영 수준 애플리케이션 통합 검증에 이르는 전 과정을 사람의 개입 없이 자율적으로 수행합니다. 이 시스템은 일주일 만에 100개가 넘는 산업·과학 계산 소프트웨어를 엔드투엔드 최적화했으며, 중간 가속비는 1.41배에 달했습니다. 석유·가스 탐사, 전자기 시뮬레이션, 의료 영상 등 8개 주요 산업 분야와 5개 과학 분야를 지원해 HPC 전문가에 대한 의존도와 연구개발 주기를 크게 줄입니다.00
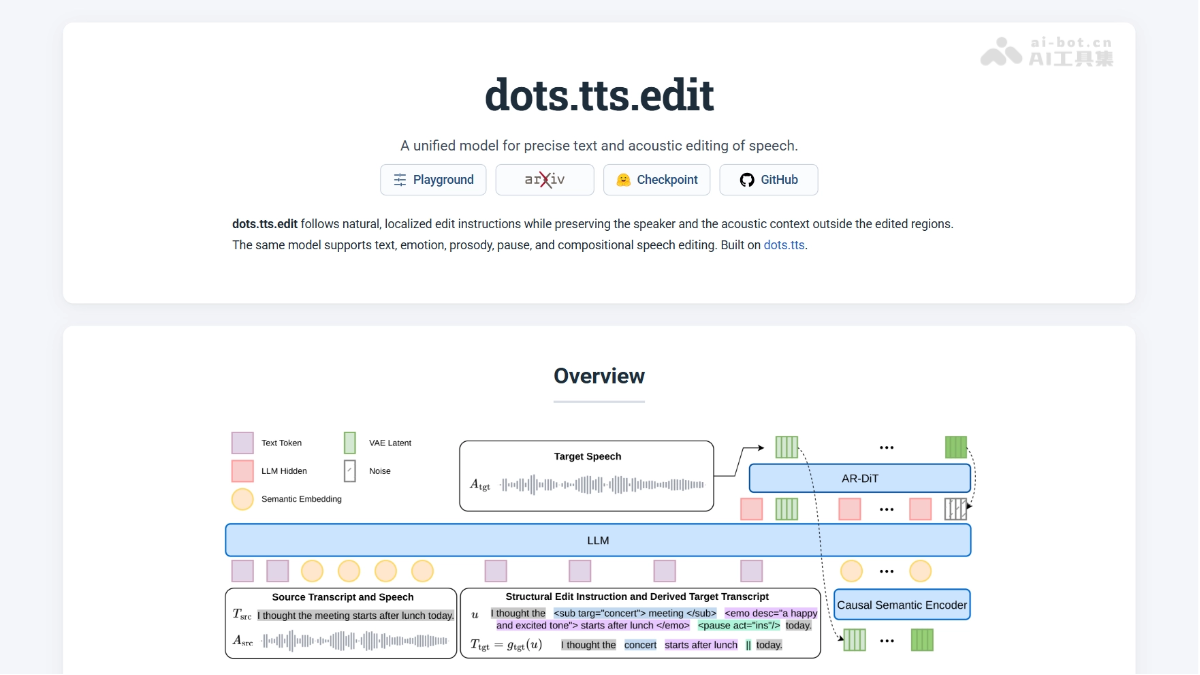 dots.ttsAI 음성 합성dots.tts는 샤오홍슈 dots 팀과 상하이교통대학교 X-LANCE 연구실이 공동 오픈소스한 20억 파라미터 규모의 완전 연속 자기회귀 음성 합성 기반 모델입니다. 모델은 연속 잠재 공간에서 48kHz 오디오를 블록 단위로 직접 생성하며, ...00
 ShieldstralAI 지능형 질의응답Shieldstral – Mistral AI의 오픈 소스 멀티모달 콘텐츠 안전 분류 모델은 Mistral AI가 출시한 30억 개 파라미터의 오픈 소스 멀티모달 콘텐츠 안전 분류 모델로, Ministral-3B를 기반으로 구축되었습니다. 이 모델은 기존의 고정된 카테고리 기반 콘텐츠 심사를 이진 질의응답 작업으로 재정의하며, 자연어 질의를 통해 심사 정책을 실시간으로 정의할 수 있어 재학습 없이도 다양한 시나리오에 적용할 수 있습니다. 텍스트 안전 벤치마크에서 평균 F1 84.9%, 멀티모달 안전 F1 83.8%로 모두 SOTA를 달성했으며, 16GB GPU 한 장만으로 배포할 수 있고 12개 언어를 지원합니다. 핵심 기능으로는 정책 적응형 심사, 멀티모달 통합 탐지, 세분화된 위반 식별, 보정된 안전 점수, 경량 엣드 디바이스 배포가 있으며, 소셜 플랫폼 콘텐츠 위험 관리, AI 대화 안전 보호, 광고 및 마케팅 규정 준수, 온라인 교육 콘텐츠 필터링, 기업 문서 보안 감사 등의 시나리오에 활용할 수 있습니다.00
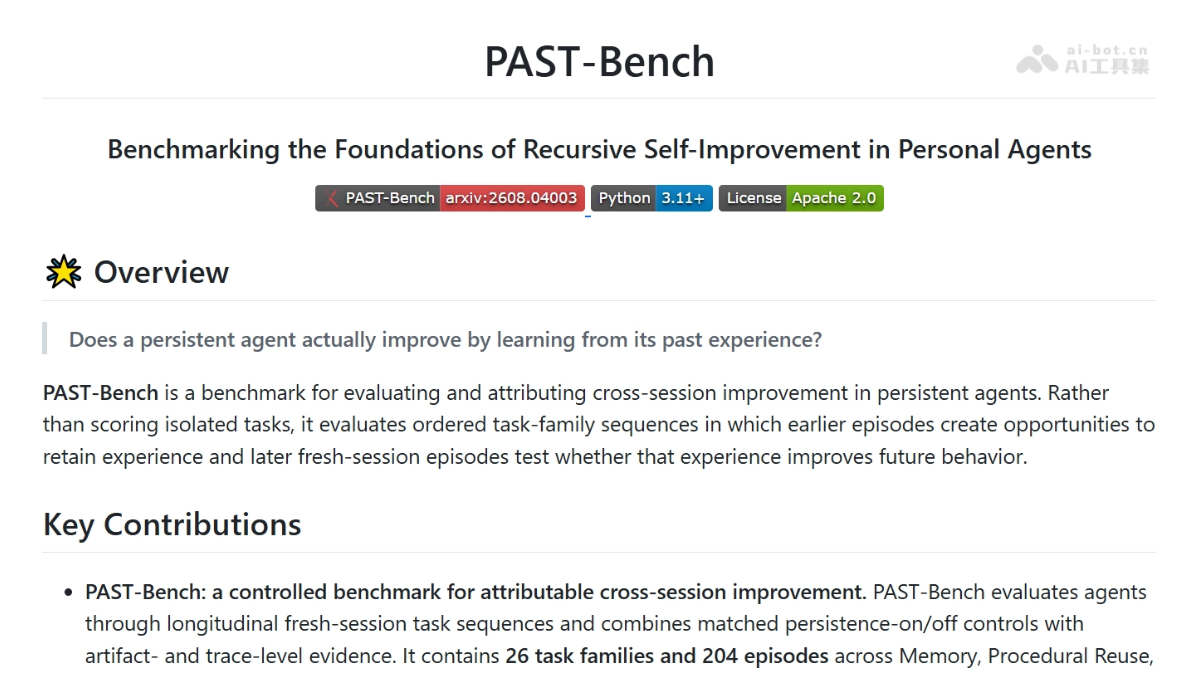 PAST-BenchAI 에이전트PAST-Bench는 프린스턴대학교 왕멍디 연구팀이 출시한 벤치마크로, 개인 AI Agent의 재귀적 자기 개선 능력을 검증합니다. PAST-Bench는 기억이 있는 조건과 없는 조건에서의 과제 수행을 비교하여, 판...00
 PixelRAG개발 플랫폼PixelRAG는 버클리 SkyLab/BAIR에서 오픈 소스로 공개한 비전 네이티브 RAG 프레임워크입니다. 웹페이지를 순수 텍스트로 추출한 뒤 검색하는 기존 방식에서 벗어나, 브라우저로 웹페이지와 PDF를 스크린샷 타일로 렌더링하고 LoRA로 미세 조정한...00
 LTX-2.5AI 동영상 생성LTX-2.5는 LTX가 오픈 소스로 공개한 AI 동영상 생성 기반 모델로, 22B 파라미터를 보유하며 출시와 동시에 가중치를 공개했습니다. 기본 멀티샷 생성, 4K HDR 및 RAW/EXR 전문 워크플로를 지원하고 오디오를 동기화해 생성할 수 있으며, 정밀한 동영상 편집 기능을 갖...00
 HOMIEAI 동영상 생성HOMIE는 홍콩과학기술대학교가 오픈소스로 공개한 디지털 휴먼 영상 생성 프레임워크로, Wan2.1-T2V-14B 백본 네트워크를 기반으로 Qwen3-VL 멀티모달 대규모 언어 모델을 통합합니다. 디지털 휴먼+상품+Logo+텍스트의 네 가지 요소를 통합적으로 처리하여 ...00
 Palmier ProAI 동영상 편집Palmier Pro는 AI 시대를 위해 제작된 macOS 네이티브 동영상 편집기로, Swift로 처음부터 개발되었으며 오픈 소스이고 기본 기능을 무료로 제공합니다. 생성형 AI를 타임라인에 직접 통합하고 Seedance, Kling ...을 지원합니다.00
 MindMemOS – 화웨이 노아 아크 오픈소스 AI Agent 메모리 운영체제AI 에이전트MindMemOS – 화웨이 노아 아크가 오픈소스로 공개한 AI Agent 메모리 운영체제로, 장기 메모리 관리가 필요한 에이전트에 개방적이고 재사용 가능한 메모리 계층을 제공합니다. 엔터티‑속성‑시간의 3차원 구조를 채택해 메모리를 단일 Agent에서 분리된 프레임워크 간 독립 자산으로 전환하며, Dreaming 오프라인 정리, Feedback 오류 보정, Skill Evolution 자동 진화 등의 메커니즘을 통해 메모리를 지속적으로 최적화합니다. 시스템은 이중 모드 메모리 기록(MindVanilla, MindSchema)과 다중 경로 Compact Search 검색을 제공하며, Docker 로컬 배포, 클라우드 API, Python SDK, CLI 등 다양한 연동 방식을 지원합니다. 94% 이상의 구조화 검색 정확도와 압축 메모리 적용 후 질의응답 정확도 10% 향상 효과를 바탕으로, 개인화 어시스턴트, 멀티 Agent 협업, 복잡한 업무 자동화 등의 시나리오에서 개발자가 세션 간 정보 공유와 작업 효율 향상을 실현할 수 있도록 지원합니다.00
 Nemotron 3.5 LightningAI 에이전트Nemotron 3.5 Lightning은 NVIDIA가 출시한 30B 파라미터 오픈 소스 MoE 모델로, 멀티 에이전트 시스템에 최적화되었습니다. 동급 모델 대비 출력 속도는 4배 향상되었고 에이전트 작업 완료 속도는 30% 빨라졌으며,...00
 Wan-Animate-2 – Wan-Animate 팀이 오픈 소스로 공개한 차세대 캐릭터 애니메이션 모델애니메이션 제작Wan-Animate-2는 Wan-Animate 팀이 오픈 소스로 공개한 차세대 캐릭터 애니메이션 모델입니다. Wan-Animate의 대규모 아키텍처 업그레이드 버전으로, 엔드투엔드 이중 분기 DiT를 사용해 명시적인 포즈 골격 없이도 참조 영상에서 동작 사전 정보를 포착합니다. 구동 영상의 캐릭터 애니메이션 변환, 정체성 및 외관 유지, 텍스트 기반 시점 제어를 지원하며, 고품질 Base 모드와 저스텝 Distillation 모드라는 두 가지 추론 모드를 제공합니다. 또한 실시간 스트리밍 캐릭터 애니메이션을 위해 Lite 변형 모델도 출시되었습니다. 이 모델은 버추얼 스트리머, 숏폼 영상 제작, 디지털 휴먼 등 다양한 애플리케이션에 적합하며, 동작 충실도와 정체성 일관성을 동시에 높이고 생성 지연 시간을 줄이는 것을 목표로 합니다.00
 SenseNova U1.5-Lite-Preview – 상탕이 오픈소스로 공개한 경량 멀티모달 모델AI 대규모 모델SenseNova U1.5-Lite-Preview – 상탕이 오픈소스로 공개한 경량 멀티모달 모델은 NEO-Unify 아키텍처를 기반으로 하며, 8B-MoT 파라미터로 시각적 이해, 추론, 생성 및 편집을 기본적으로 통합합니다. 이 모델은 4K 초고화질 이미지의 네이티브 생성을 지원하고, 정교한 텍스처와 사실적인 질감, 중·영문 복잡 레이아웃 텍스트 렌더링 기능을 제공합니다. Prompt Enhance Skill을 내장해 창작 진입장벽을 낮추며, 매우 긴 자연어와 구조화된 시각 지시를 정확히 수행하고 지속적인 반복 편집을 지원합니다. 디자이너, 개발자 및 콘텐츠 제작자를 대상으로 낮은 배포 비용과 높은 지시 준수율을 갖춘 상용급 시각 창작 도구를 제공합니다.10
 IndexTTS-2.5AI 음성 합성IndexTTS-2.5는 Bilibili가 오픈 소스로 공개한 산업级 제로샷 음성 복제 모델로, 매개변수规模는仅 0.8B이며 중국어, 영어, 일본어, 스페인어, 아랍어 5개 언어 간 음성 전이를 지원합니다.00
 MAGI-2-preview – Sand.ai 오픈 소스 멀티모달 동영상 생성 모델AI 동영상 생성MAGI-2-preview – Sand.ai 오픈 소스 멀티모달 동영상 생성 모델은 Sand.ai가 오픈 소스로 공개한 세계 최초의 1,000억 개 매개변수 규모 MoE 멀티모달 동영상 생성 모델입니다. 전체 매개변수는 114B이며 활성화되는 매개변수는 6B에 불과합니다. 이 모델은 단일 스트림 아키텍처를 계승해 텍스트, 동영상, 오디오를 하나의 Transformer에서 통합적으로 공동 모델링하며, 네이티브 멀티모달 생성을 구현합니다. 핵심 기능으로는 텍스트·이미지·동영상 간 생성과 동영상 간 변환을 지원하고 오디오 이해를 네이티브로 통합하는 기능이 있으며, MoE 희소 활성화를 통해 추론 비용을 크게 줄입니다. 주요 대상 사용자는 AI 연구자, 개발자 및 기업 기술팀이며, 학술 연구, 프라이빗 배포, 멀티모달 영상 사전 시각화 등의 시나리오에 적합합니다. 상업적 이용이 가능한 오픈 소스 기반의 효율적인 동영상 생성 솔루션을 제공합니다.00
 Qwen-CUA – 알리바바 Qwen 등이 출시한 네이티브 Computer Use AgentAI 에이전트Qwen-CUA – 알리바바 Qwen 등이 출시한 네이티브 Computer Use Agent는 397B-A17B 혼합 전문가 아키텍처를 기반으로 하며, 스크린샷만으로 인터페이스 상태를 인식합니다. DOM 트리나 접근성 메타데이터에 의존하지 않고 키보드 및 마우스 이벤트를 직접 출력해 브라우저, 데스크톱 및 전문 소프트웨어를 조작할 수 있습니다. OSWorld-Verified 벤치마크에서 86.2점을 기록했으며, 더 큰 버전인 Qwen-CUA-Max는 87.6점을 달성해 오픈 소스 CUA 분야의 선도적인 수준에 도달했습니다. 엔드투엔드 비전-액션 학습을 적용해 크로스 플랫폼 범용성과 높은 안정성을 갖추었으며, 기술 보고서와 Demo를 공개해 자동화 테스트, RPA, 접근성 지원 및 과학 연구 소프트웨어 조작 등의 시나리오에 활용할 수 있습니다.00
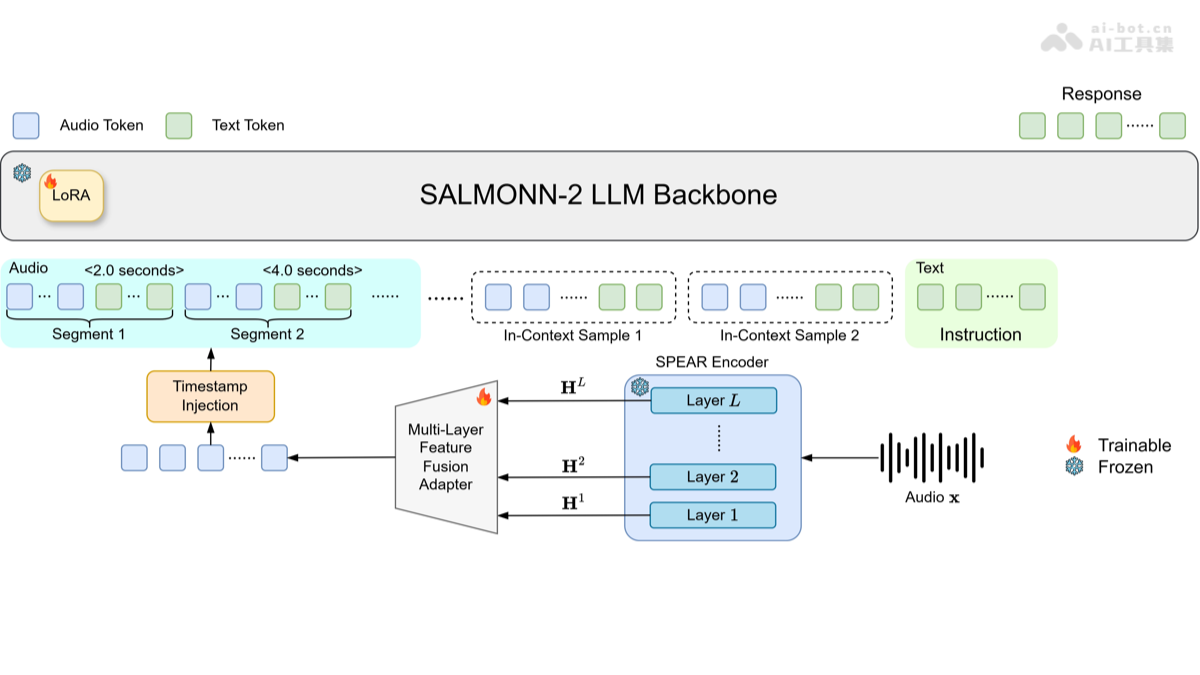 SALMONN-2 – 칭화대 등이 오픈 소스로 공개한 범용 오디오 대규모 언어 모델AI 코딩SALMONN-2 – 칭화대 등이 오픈 소스로 공개한 범용 오디오 대규모 언어 모델은 바이트댄스의 SPEAR 통합 자기지도 오디오 인코더와 다층 특징 융합 어댑터를 기반으로 구축되었으며, Qwen3를 텍스트 기반 모델로 사용하는 범용 오디오 대규모 언어 모델입니다. 음성 인식, 오디오 설명, 음악 이해, 감정 인식, 화자 검증 등 도메인 간 작업을 지원하며, 범용 ALLM에서 처음으로 음향 이벤트 감지, 오디오 위조 감지, 음성 품질 평가, 멀티모달 컨텍스트 음성 인식 등의 고급 기능을 체계적으로 구현했습니다. 이 모델은 기존의 이중 인코더 방식을 단일 SPEAR 인코더로 대체하고, MLF 어댑터를 통해 다층 음향 특징을 융합하여 더욱 균형 잡힌 도메인 간 성능을 구현합니다. 약 1.8만 시간의 지도 데이터만으로 효율적으로 학습한 SALMONN-2는 MMAU-Pro, MMAR, MMSU 등 3대 종합 벤치마크에서 동급 오픈 소스 모델 중 최고의 성능을 달성했으며, 스마트 회의 도우미, 오디오 콘텐츠 검수, 음성 품질 모니터링 등의 분야에 활용할 수 있습니다.00
 Muse Glimmer – Meta가 오픈 소스로 공개한 300억 매개변수 대규모 언어 모델AI 에이전트Muse Glimmer는 Meta가 오픈 소스로 공개한 300 억 매개변수 대규모 언어 모델로, 24시간 로컬 상주 Agent 워크플로에 맞춰 심층 최적화되었습니다. 4비트 양자화 기술을 통해 24 GB VRAM의 단일 GPU 또는 32 GB 통합 메모리의 Apple Silicon(M4/M5 Max)에서 원활하게 실행할 수 있으며, 성능 저하도 거의 없습니다. DFlash 추측 디코딩을 통합해 RTX 5090과 같은 고급 하드웨어에서 최대 3.1배의 속도 향상을 실현하며, 실시간 대화, 도구 호출, 코드 생성, 다단계 추론 등 멀티모달 작업을 지원합니다. 개인 개발자와 중소기업은 물론 데이터 프라이버시 요구가 높은 의료·금융 업계에 적합하며, 낮은 VRAM 요구 사항으로 효율적인 로컬 AI 기능을 제공하고 모든 데이터를 기기 내부에 보관합니다.00
 Hunyuan3D-Buffalo 1.0 – 텐센트 혼위안이 출시한 3D 멀티모달 프레임워크3D 디자인Hunyuan3D-Buffalo 1.0 – 텐센트 혼위안이 출시한 3D 멀티모달 프레임워크는 공유 Hunyuan3D-VLM 백본을 통해 3D 질의응답, 공간 위치 지정, 텍스트 기반 3D 생성, 지시 기반 편집, 부품 생성을 하나의 흐름으로 통합한 프레임워크입니다. 자연어로 3D 모델 구조를 이해하고 부품을 식별하며, 지시에 따라 국소 형상을 수정하고, 의미 단위의 부품을 추출할 수 있습니다. 3D 이해·생성·편집의 선순환을 구축하여 게임, 애니메이션, 산업 디자인에 조합 가능한 3D 자산 제작 방식을 제공하는 것을 목표로 합니다. 핵심 기능은 3D 이해, 텍스트 기반 3D 생성, 지시 기반 편집, 부품 생성이며, 네 가지 작업은 동일한 3D 의미 표현과 처리 파이프라인을 공유합니다. 게임 개발자, 애니메이션 제작자, 산업 디자이너 및 3D 콘텐츠 크리에이터에게 적합하며, 자연어 상호작용으로 전문 지식의 진입 장벽을 낮추고 자산 재사용 및 반복 작업의 효율을 높입니다.00
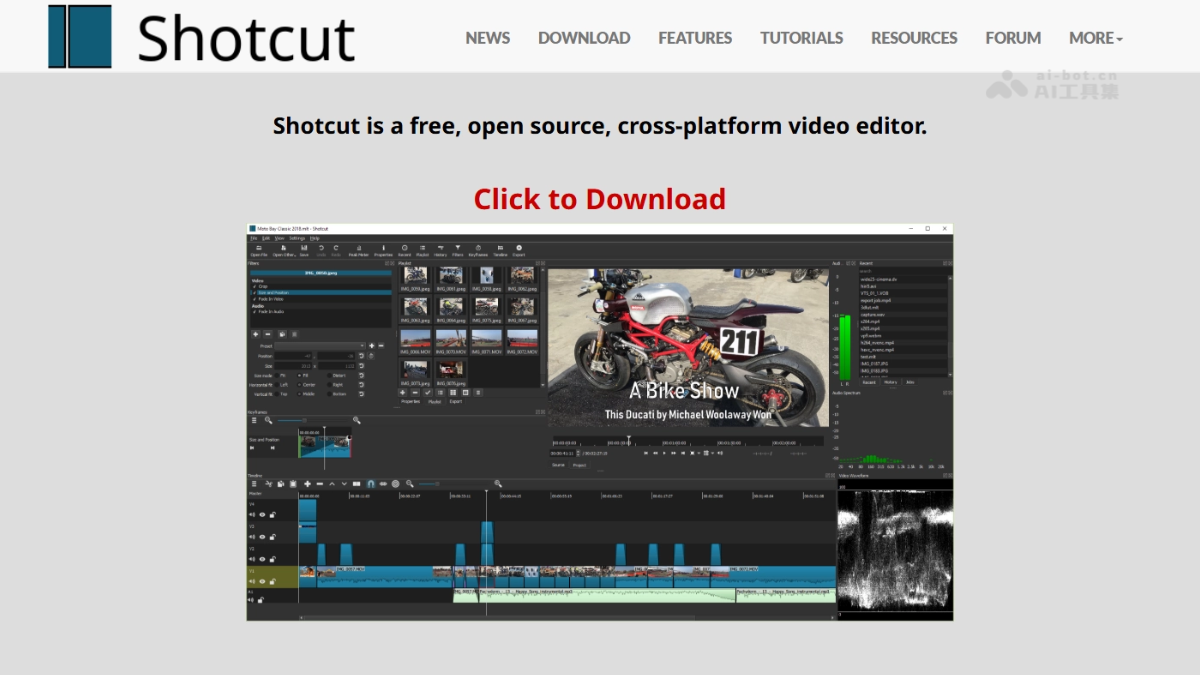 ShotcutAI 동영상 편집Shotcut은 FFmpeg 기반의 오픈 소스 동영상 편집 소프트웨어로, 완전 무료이며 워터마크와 길이 제한이 없습니다. 수백 가지 오디오·동영상 형식을 가져오지 않고 바로 편집할 수 있으며, 다중 트랙 타임라인, 키프레임 애니메이션, 다양한...00
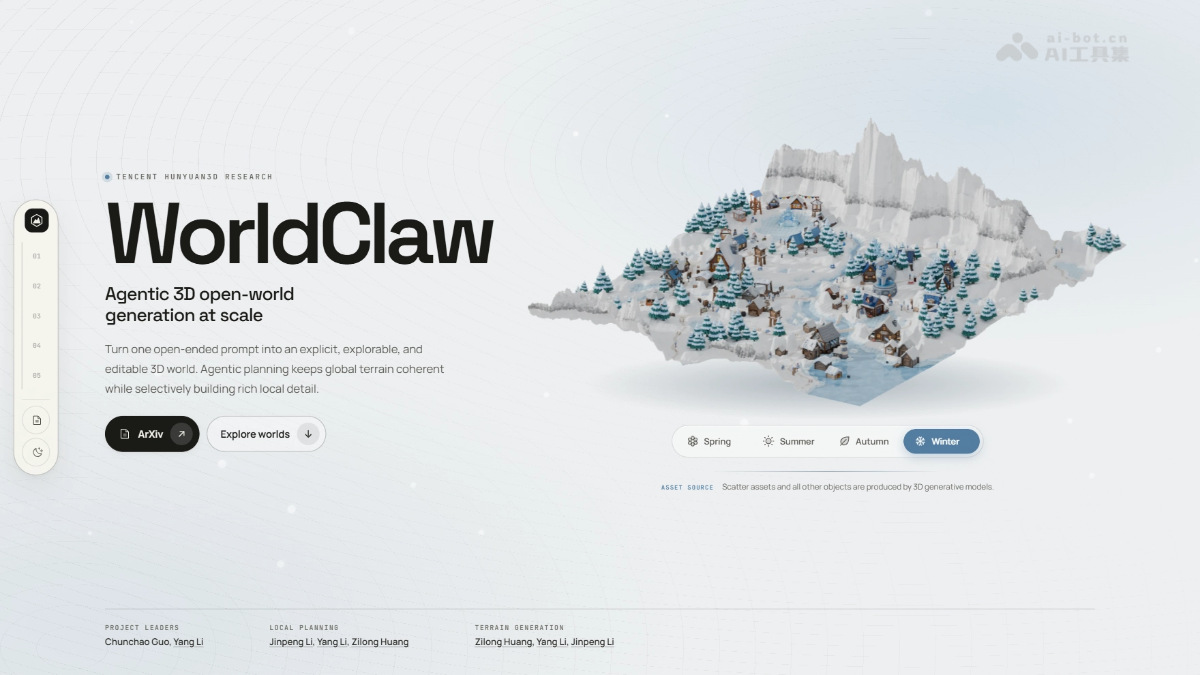 WorldClaw – 텐센트 훈위안 팀이 개발한 3D 월드 생성 프레임워크3D 디자인WorldClaw는 텐센트 훈위안 팀이 개발한 에이전트 기반 오픈 월드 3D 생성 프레임워크입니다. 사용자가 자연어로 설명을 입력하면 시스템이 지형, 구역, 건축물, 오브젝트 및 공간 관계를 자동으로 계획하고, 전역에서 지역으로 이어지는 생성 전략을 사용해 Blender에서 자유롭게 탐색하고 오브젝트별 편집이 가능한 완전한 3D 장면을 구축합니다. 이 프레임워크는 Claude Opus, GPT-Image-2, SAM3, Hunyuan3D 등 여러 모델의 협업으로 구동되며, 비전 에이전트의 자체 점검 및 복구 기능을 통해 오브젝트가 공중에 뜨거나 서로 관통하는 등의 접촉 문제를 자동으로 수정할 수 있습니다.00
 PyTorchAI 코딩 도구PyTorch는 Meta AI 연구팀이 시작하고 현재는 Linux Foundation이 관리하는 오픈 소스 머신러닝 프레임워크로, 인공지능 연구자, 머신러닝 엔지니어, 데이터 과학자 및 학생을 주요 대상으로 합니다. 사용자는 일반적으로 Python으로 모델과 순전파 계산 과정을 정의한 다음, 텐서 연산, 자동 미분 및 신경망 모듈을 활용해 학습을 진행하고 관련 생태계 라이브러리와 함께 컴퓨터 비전, 오디오 또는 텍스트 작업을 처리합니다. 동적 계산 그래프는 실험과 디버깅을 용이하게 하며, 연구 프로토타입을 모델 배포 단계로 발전시키는 것도 지원합니다. 실제 사용을 위해서는 Python, 텐서 연산 및 딥러닝의 기본 지식을 갖춰야 하며, 실험 코드를 프로덕션 환경으로 전환할 때는 엔지니어링 배포와 리소스 구성도 직접 처리해야 합니다.057.6
 Qwen 3.8-Max – 알리바바 클라우드 Qwen 팀이 출시한 플래그십 대규모 모델AI 대규모 모델Qwen 3.8-Max는 알리바바 클라우드 Qwen 팀이 출시한 플래그십 대규모 모델로, Qwen 3.5 아키텍처를 기반으로 2.4조 개 파라미터까지 확장되었으며 기업 및 연구용 초대규모 언어 모델을 지향합니다. 장기간 자동 프로그래밍, 논문 재현, 대회 실전, 업무 효율 향상, 퀀트 전략 개발, 칩 자율 설계 등 다양한 고부가가치 시나리오를 지원합니다. 이 모델은 실제 세계 강화학습과 자기 진화형 피드백 루프를 통해 수일에서 수십 일 동안 자율적으로 실행되며, 사람의 개입 없이도 복잡한 작업을 완료할 수 있습니다. 사용자는 천문AI 플랫폼에서 OpenAI 또는 Anthropic 프로토콜과 호환되는 API를 호출하거나, 오픈소스 가중치를 로컬에 배포하여 Claude Code, Codex, Qoder 등의 에이전트 프레임워크에 편리하게 통합할 수 있습니다. 따라서 연구개발팀, 법률·컴플라이언스 담당자, 디자이너 등 전문 사용자는 업무 효율을 크게 높이고, 장기간이 필요한 프로젝트를 한 번의 대화 안에서 완료할 수 있습니다.10
이 태그가 지정된 모든 도구가 표시됩니다.