
- 월간 방문 수
- 0
- 가격
- 설정되지 않음
- 등록일
- —
- 업데이트됨
- 2026-10-30
01Nemotron 3.5 Transcribe란
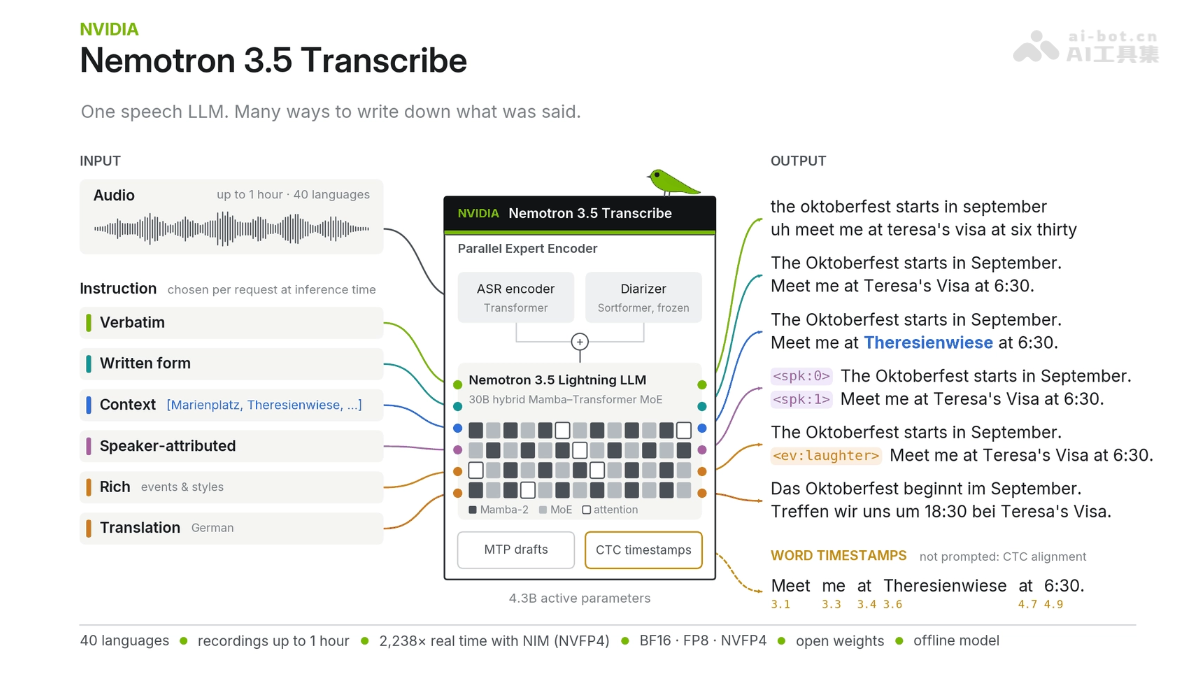
Nemotron 3.5 Transcribe는 NVIDIA가 출시한 오픈 소스 음성 대규모 언어 모델로, 음성 인코더와 MoE 아키텍처를 사용하며 약 43억 개의 활성 파라미터를 갖췄습니다. 40개 언어를 지원하고 최대 1시간 길이의 녹음과 최대 8명의 화자를 처리할 수 있으며, 축어 전사, 화자 구분, 번역 등의 기능을 제공합니다. Nemotron 3.5 Transcribe는 자연어 지시를 통해 출력 형식을 맞춤 설정할 수 있고, 미세 조정으로 전문 분야에 맞게 적용할 수 있으며, 상업적 사용이 무료입니다.
02Nemotron 3.5 Transcribe의 주요 기능
다국어 전사: 40개 언어를 지원하며 녹음을 텍스트로 전사하고 음성에 사용된 언어를 식별할 수 있습니다.
화자 구분: 최대 8명의 화자를 구분하고 각 문장에 화자를 표시해 회의와 다자간 인터뷰에 적합합니다.
장시간 오디오 처리: 한 번에 최대 약 1시간 길이의 녹음을 처리할 수 있습니다.
지시 기반 전사: 자연어로 출력 형식을 지정할 수 있습니다. 축어록, 문어체 정리, 추임새 제거, 전문 용어 표기 등을 재학습 없이 처리합니다.
음성 번역: 31개 언어와 영어 간 상호 번역을 지원합니다.
단어 단위 타임스탬프: 각 단어에 해당하는 오디오 위치를 반환해 다시 듣기와 검색을 편리하게 합니다.
도메인 미세 조정: NeMo Speech 툴킷을 기반으로 단일 GPU에서 적은 데이터만 사용해 전문 분야에 빠르게 적용할 수 있습니다.
03Nemotron 3.5 Transcribe의 기술 원리
WeChat에서 팔로우한 뒤 “오픈 소스”라고 답장하면 AI 오픈 소스 프로젝트交流群에 참여할 수 있습니다.
음성 증강 언어 모델(SALM): 모델은 세 부분으로 구성됩니다. Transformer 음성 인코더가 오디오 특징을 추출하고, 동결된 Nemotron 3 화자 분리 모델이 화자 활동 정보를 제공하며, 두 출력이 함께 Nemotron 3.5 Lightning 30B-A3B 혼합 Mamba-Transformer MoE 대규모 언어 모델에 입력됩니다. 총 파라미터는 약 340억 개지만 추론마다 약 43억 개만 활성화해 성능과 효율을 모두 확보합니다.
병렬 전문가 인코더: 동결된 분리 모델이 출력한 화자 활동 신호를 ASR 인코더의 표현에 주입합니다. 이를 통해 단일 LLM 아키텍처를 변경하지 않고도 화자 표시가 포함된 전사를 수행하며, 직렬화된 출력 방식으로 학습합니다.
감독 데이터 균형 혼합: 학습 데이터는 샘플 수가 아니라 정답 토큰 수를 기준으로 샘플링합니다. 각 ASR 샘플에 여러 작업 지시를 조합할 수 있어 새로운 기능을 1% 미만의 샘플링 비율로 추가할 수 있습니다. 전체 학습은 지도 미세 조정과 짧은 강화 학습의 두 단계로 구성되며, 후자는 전사 정확도를 직접 최적화합니다.
MTP 추측 디코딩: 학습 과정에서 다중 토큰 예측(MTP) 목표를 공동 최적화하므로, 모델 자체의 MTP 계층을 vLLM 추측 디코딩의 초안 모델로 바로 사용할 수 있습니다. 또한 별도의 DFlash2 초안 모델도 대안으로 제공합니다. 두 방식을 함께 사용하면 단일 RTX PRO 6000 Blackwell GPU에서 초당 2238초 분량의 오디오를 전사할 수 있습니다.
CTC 타임스탬프 어댑터: 디코딩 후 경량 CTC 어댑터가 생성된 텍스트와 오디오를 정렬합니다. 이를 통해 장시간 오디오와 겹쳐 말하는 대화에서도 화자 표시가 포함된 단어 단위 타임스탬프를 생성하며, 주 모델에 부담을 추가하지 않습니다.
04Nemotron 3.5 Transcribe 사용 방법
하드웨어 준비: BF16 버전에는 약 80GB의 VRAM이 필요합니다. FP8/NVFP4 또는 GGUF 버전을 선택하면 요구 사양을 낮출 수 있습니다.
모델 받기: Hugging Face 또는 ModelScope에서 NVIDIA-Nemotron-3.5-Transcribe-30B-A4B를 검색하고 OpenMDW-1.1 라이선스에 따라 가중치를 다운로드합니다.
환경 설치: Nemotron Transcribe NIM(공식 컨테이너), vLLM(MTP 가속 지원), NeMo-Speech.cpp(GGUF 로컬 실행) 중 한 가지 방식으로 배포합니다.
오디오 준비: 최대 1시간 길이의 녹음 파일을 업로드하고 사용하는 프레임워크의 요구 사항에 맞게 형식을 변환합니다.
프롬프트 작성: “축어 원문을 유지하고 화자를 표시해 줘”, “추임새를 제거하고 영어로 번역해 줘”처럼 자연어로 작업을 설명합니다.
추론 실행: 인터페이스를 호출해 오디오와 프롬프트를 제출하면 모델이 전사 텍스트를 반환하며, 필요한 경우 화자 태그와 단어 단위 타임스탬프도 함께 제공합니다.
(선택 사항) 빠른 체험: 직접 배포하지 않으려면 Hugging Face의 nvidia/nemotron-transcribe 데모 공간에서 온라인으로 먼저 사용해 볼 수 있습니다.
(선택 사항) 도메인 미세 조정: NeMo Speech 툴킷으로 주석 데이터를 준비하면 단일 GPU에서 약 0.5–2.3시간 내에 고유한 억양, 용어, 형식에 맞게 조정할 수 있습니다.
05Nemotron 3.5 Transcribe의 핵심 장점
지시 기반 출력: 자연어 한 문장으로 축어록, 정리본, 번역 등 다양한 형식으로 전환할 수 있어 재학습이나 여러 모델 설정이 필요하지 않습니다.
높은 전사 정확도: 영어 Open ASR 벤치마크의 평균 WER은 4.71%, 다국어 벤치마크는 4.62%로, 모두 오픈 웨이트 모델 중 1위입니다.
뛰어난 화자 구분: 여러 사람의 음성이 겹치는 화자 표시 전사 작업에서 처음으로 전용 연결 시스템을 넘어섰으며, 최대 1시간 및 8명 환경을 지원합니다.
강력한 문맥 오류 수정: 용어와 인명 등의 엔터티 목록을 제공하면 명명된 엔터티 오류율을 6배 낮출 수 있어 전문 용어를 추측에 의존하지 않습니다.
화자 표시가 포함된 단어 단위 타임스탬프: 경량 CTC 정렬을 통해 전사 결과를 다시 듣고 검색할 수 있어 강의 재생, 회의 검색 등의 애플리케이션을 직접 지원합니다.
높은 추론 효율: 기본 MTP 추측 디코딩과 DFlash2 초안 모델을 사용해 단일 RTX PRO 6000에서 초당 2238초 분량의 오디오를 처리할 수 있습니다.
06Nemotron 3.5 Transcribe 프로젝트 주소
Hugging Face 모델 저장소:https://huggingface.co/nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B
기술 보고서:https://research.nvidia.com/labs/nemotron/files/NVIDIA-Nemotron-3.5-Transcribe-Technical-Report.pdf
07Nemotron 3.5 Transcribe의 활용 분야
회의록 및 의사 결정 추출: 발언자를 자동으로 구분하고 논의 내용을 원문 그대로 보존하며, 지시에 따라 회의 결론과 할 일을 정리합니다.
미디어 인터뷰 및 뉴스 편집: 인터뷰 대상자의 발언을 그대로 보존하고 화자를 표시해 인용의 정확성을 보장하며, 필요에 따라 추임새를 제거할 수 있습니다.
수업 및 교육 재생: 단어 단위 타임스탬프가 포함된 전사본을 생성해 학습자가 키워드를 직접 검색하고 교사가 해당 내용을 설명한 시점으로 이동할 수 있습니다.
의료 및 전문 분야 기록: 용어 목록과 도메인 미세 조정을 결합해 의사와 환자의 대화를 규격화된 형식의 의료 기록으로 전사하고 전문 용어 오류율을 낮춥니다.
다국어 콘텐츠 현지화: 40개 언어의 녹음을 영어 원고로 직접 번역해 국제 회의, 인터뷰 또는 동영상 자막 제작에 활용할 수 있습니다.
© 면책 조항: 도메인 및 연결된 콘텐츠는 시간이 지나면서 변경될 수 있습니다. AIEZZ은(는) 제3자 웹사이트를 관리하지 않습니다. 외부 콘텐츠와 위험을 독립적으로 검토하세요.
사용자 리뷰0