

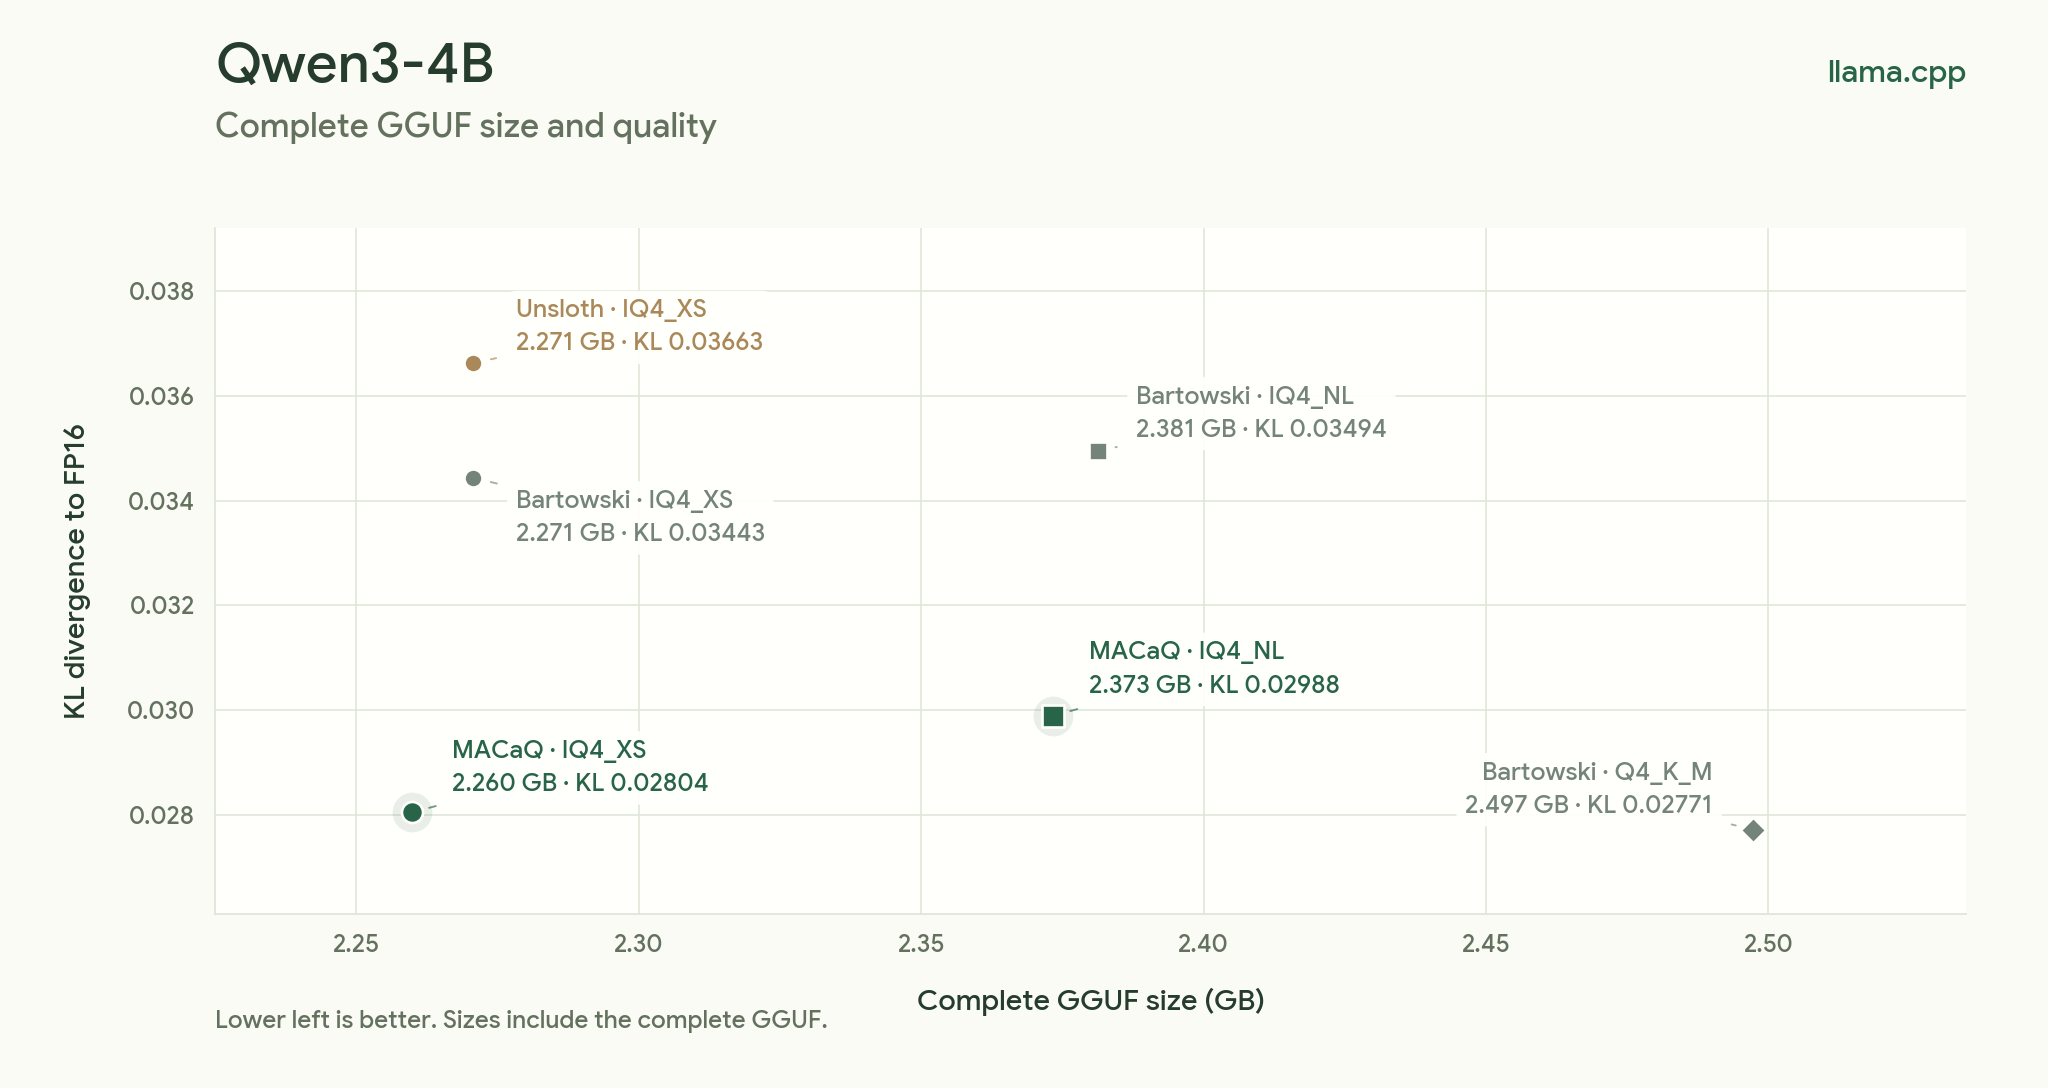
MACaQ는 최신 AI 모델의 메모리 및 연산 요구 사항을 줄이기 위한 모델 독립적 보정 양자화 프로젝트입니다. llama.cpp, vLLM, Diffusers, PyTorch를 통해 텍스트, 이미지, 비디오, 오디오 워크플로를 지원합니다.
이 프로젝트는 실제 추론 호환성을 유지하면서 보정된 저정밀도 가중치와 활성화 값에 중점을 둡니다. README에 따르면 MACaQ는 32.5 GB의 장치 메모리를 사용해 1,220억 개 매개변수 모델을 64분 만에 양자화할 수 있습니다. 또한 일부 비교에서 MR-GPTQ 및 DuQuant++보다 낮은 퍼플렉서티를 기록하거나, 양자화 시간은 크게 줄이면서 Llama-3-8B와 비슷한 퍼플렉서티를 달성한다고 보고합니다.
적합한 MACaQ 백엔드 선택
먼저 모델과 배포 대상에 맞는 백엔드를 선택합니다. 각 백엔드마다 별도의 환경과 Python 3.12를 사용하세요.
- Diffusers: 이미지, 비디오, 오디오 생성 모델을 W4A4 safetensors 체크포인트로 양자화합니다.
- llama.cpp: 텍스트 모델을 2비트, 3비트 또는 4비트 GGUF 파일로 양자화하고 CPU를 포함한 로컬 환경에서 실행합니다.
- vLLM: W4A4 또는 가중치 전용 형식을 사용해 생성 또는 HTTP 서빙을 위한 텍스트 모델을 양자화합니다.
- PyTorch: 음성 생성 모델을 W4A4 체크포인트로 양자화하고 WAV 오디오를 생성합니다.
저장소에는 백엔드별 설치, 보정, 양자화 및 생성 지침이 포함되어 있습니다. 시작하기 전에 선택한 백엔드의 가이드를 확인하세요.
환경 준비
Python 3.12를 사용하고, 사용하려는 백엔드 전용 격리 환경을 만드세요. 환경을 분리하면 llama.cpp, vLLM, Diffusers 및 PyTorch 간의 종속성 충돌을 방지하는 데 도움이 됩니다.
MACaQ 저장소를 복제하고 해당 디렉터리로 이동합니다.
선택한 백엔드를 위한 Python 3.12 가상 환경을 만듭니다.
해당 백엔드의 README에 따라 종속성과 필요한 런타임을 설치합니다.
백엔드 가이드에 지정된 원본 모델, 보정 데이터 및 출력 디렉터리를 준비합니다.
정확한 설치 명령은 백엔드와 모델 제품군에 따라 다르므로 모든 워크플로에 하나의 일반 설치 명령을 적용하지 말고 링크된 README를 사용하세요.
Diffusers로 생성 모델 양자화
Diffusers 백엔드는 확산 트랜스포머를 처리하고 양자화된 safetensors 체크포인트를 저장합니다. 이미지, 비디오, 이미지-비디오 및 오디오 생성을 지원합니다.
저장소는 black-forest-labs/FLUX.2-klein-4B, Wan-AI/Wan2.2-TI2V-5B-Diffusers, ylacombe/stable-audio-1.0을 포함한 모델의 워크플로를 제공합니다. 이미지-비디오 모델의 경우 조건 이미지를 사용해 보정할 수 있으므로 양자화 과정에 의도한 입력 패턴이 반영됩니다.
Diffusers 가이드를 열고 이미지, 비디오 또는 오디오 워크플로를 선택합니다.
전용 Python 3.12 환경에 백엔드 요구 사항을 설치합니다.
원본 모델을 다운로드하거나 확인하고, 선택한 레시피에 필요한 보정 입력을 준비합니다.
문서화된 양자화 명령을 실행해 W4A4 safetensors 체크포인트를 저장합니다.
해당 생성 명령을 사용해 이미지, 비디오 또는 오디오 결과를 생성합니다.
llama.cpp로 텍스트 모델 양자화
llama.cpp 백엔드는 텍스트 생성을 위한 소형 GGUF 파일을 생성합니다. 2비트, 3비트 및 4비트 GGUF 형식을 지원하며, 결과 모델에서 텍스트를 생성할 수 있는 런타임을 포함합니다.
저장소에는 Qwen/Qwen3-4B와 같은 밀집 모델, Qwen/Qwen3.8-27B와 같은 하이브리드 모델, Qwen/Qwen3-30B-A3B 및 Qwen/Qwen3-Coder-30B-A3B-Instruct와 같은 혼합 전문가 모델이 문서화되어 있습니다. 또한 Qwen3.6-35B-A3B 및 Qwen3.8-Flash-Next용 레시피도 포함되어 있습니다.
표준 양자화 워크플로
llama.cpp 가이드를 열고 모델 아키텍처에 맞는 레시피를 선택합니다.
전용 Python 3.12 환경에 llama.cpp 백엔드와 종속성을 설치합니다.
선택한 레시피에 설명된 원본 Hugging Face 모델과 보정 텍스트를 준비합니다.
문서화된 MACaQ 양자화 워크플로를 실행하고 GGUF 출력을 저장합니다.
번들로 제공된 런타임 또는 호환되는 llama.cpp 설치를 사용해 텍스트를 생성합니다.
모델별 세부 정보는 backend README의 dense, hybrid, mixture-of-experts 또는 Flash-Next 섹션을 참조하세요. 이러한 레시피는 모델 아키텍처 간 차이를 반영합니다.
GGUF 모델 실행
GGUF 파일이 생성되면 llama.cpp 명령줄 클라이언트로 실행합니다.
llama cli -m models/model-macaq-r.ggufllama.cpp를 통해 모델을 서비스할 수도 있습니다.
llama serve -m models/model-macaq-r.ggufMACaQ-R로 기존 GGUF 파일 개선
MACaQ-R은 기존 양자화 GGUF 파일의 가중치 코드를 개선하면서 기본 형식과 블록 스케일을 유지합니다. 결과 파일은 표준 llama.cpp 설치 환경과 계속 호환됩니다.
이미 양자화된 모델이 있고 GGUF 형식을 변경하지 않은 채 품질을 개선하거나 특정 작업에 맞게 조정하려는 경우 유용합니다. README는 Hugging Face에서 Qwen3.6-35B-A3B MACaQ-R 모델을 제공하며, 같은 표시 크기의 비교 대상 Unsloth UD-Q4_K_XL 파일보다 낮은 KL 발산을 보고합니다.
양자화된 MoE GGUF를 개선하려면 양자화 모델, 이에 대응하는 원본 Hugging Face 모델, FP16 교사 파일, 보정 텍스트, 출력 경로 및 작업 디렉터리를 지정합니다.
.venv-llamacpp/bin/python llamacpp/macaq.py refine \
  --model models/model-q4.gguf --hf models/original \
  --teacher models/original-f16.gguf --calibration data/calibration.txt \
  --output models/model-macaq-r.gguf --work-dir work/refinement
개선이 완료되면 표준 llama.cpp로 출력을 불러옵니다.
llama cli -m models/model-macaq-r.gguf활성화 변환을 포함한 전체 MACaQ 워크플로는 번들 런타임 가이드를 참조하세요.
vLLM으로 모델 양자화 및 서비스
vLLM 백엔드는 생성 또는 HTTP 서비스를 위한 소형 텍스트 모델 체크포인트를 생성합니다. W4A4가 기본 추론 모드이며, 백엔드는 가중치 전용 양자화도 지원합니다.
vLLM 가이드를 열고 hybrid 텍스트 모델 또는 텍스트 mixture-of-experts 모델에 해당하는 워크플로를 선택합니다.
별도의 Python 3.12 환경에 vLLM 백엔드를 설치합니다.
선택한 레시피에 필요한 소스 모델과 보정 데이터를 준비합니다.
문서에 설명된 양자화 명령을 실행하여 소형 체크포인트를 생성합니다.
로컬 생성을 위해 체크포인트를 불러오거나 문서에 설명된 HTTP 서버를 시작합니다.
README는 Qwen3.8-27B 비교 결과를 보고합니다. MACaQ W4A4의 perplexity는 2.8994로 BF16의 2.8463과 비교되며, 명시된 테스트 설정에서 더 빠른 프리필 및 디코드 측정 결과도 보고되었습니다.
PyTorch로 음성 생성기 양자화
PyTorch 백엔드는 음성 생성을 대상으로 하며 W4A4 체크포인트를 저장합니다. 체크포인트를 저장한 후에는 보정을 반복하지 않고 불러올 수 있습니다.
문서화된 워크플로는 Qwen3-TTS와 Chatterbox Turbo를 다룹니다.
PyTorch 가이드를 열고 음성 모델을 선택합니다.
별도의 Python 3.12 환경에 필요한 PyTorch 종속 항목을 설치합니다.
모델별 지침에 따라 보정과 양자화를 실행합니다.
W4A4 체크포인트를 저장합니다.
저장한 체크포인트를 불러오고 재보정 없이 WAV 오디오를 생성합니다.
Ascend 하드웨어에서 MACaQ 사용
MACaQ W4A4 dense 및 grouped 행렬 곱셈 커널은 CANN 관련 pull request를 통해 사용할 수 있습니다. README는 ops-nn pull request 12568의 PTO-ISA 커널과 ops-tilelang pull request 44의 CCE 백엔드 기반 TileLang 커널을 안내합니다.
호환되는 CANN, PyTorch 및 torch_npu 버전을 사용하려면 해당 프로젝트의 빌드 지침을 따르세요. 전체 모델을 실행하려면 Ascend 추론 런타임과 통합해야 합니다.
더 나은 워크플로를 위한 실용적인 팁
- 배포 대상에 맞는 백엔드를 선택하세요. 이식 가능한 로컬 텍스트 추론에는 GGUF와 llama.cpp를, 텍스트 서비스에는 vLLM을, 멀티모달 생성에는 Diffusers를, 음성 모델에는 PyTorch를 선택하세요.
- 모델별 레시피를 사용하세요. Dense, hybrid 및 mixture-of-experts 모델에는 서로 다른 준비 및 양자화 단계가 필요할 수 있습니다.
- 사용 방식에 맞는 보정 데이터를 사용하세요. 예를 들어 Diffusers 이미지-비디오 변환 워크플로는 보정 중 조건 이미지를 사용합니다.
- 환경을 분리하세요. README는 각 백엔드와 Python 3.12에 대해 별도의 환경을 사용할 것을 명시적으로 권장합니다.
- 파일 크기뿐 아니라 품질도 비교하세요. 이 프로젝트는 perplexity 및 KL 발산 비교를 사용하여 양자화 모델을 FP16 또는 다른 양자화 방법과 비교 평가합니다.
- 이미 GGUF가 있다면 MACaQ-R을 사용하세요. 표준 llama.cpp 호환성을 유지하면서 기존 양자화 파일을 개선할 수 있습니다.
결론
MACaQ는 GGUF 텍스트 모델부터 Diffusers 이미지, 비디오, 오디오 모델, vLLM 서빙 체크포인트, PyTorch 음성 생성기까지 여러 AI 워크로드에 하나의 양자화 접근 방식을 제공합니다. 백엔드별 README에서 시작하고, 격리된 환경에서 Python 3.12를 사용하며, 캘리브레이션을 위해 모델 레시피를 따르고, 사용하려는 런타임에서 생성된 체크포인트를 검증하세요.
연구 또는 기술 문서는 MACaQ 논문을 참조하세요. 이 프로젝트는 Apache License 2.0에 따라 배포됩니다.