
- Ziara za kila mwezi
- 0
- Bei
- Haijawekwa
- Imeorodheshwa
- —
- Imesasishwa
- 2026-10-08
01VoxMem ni nini
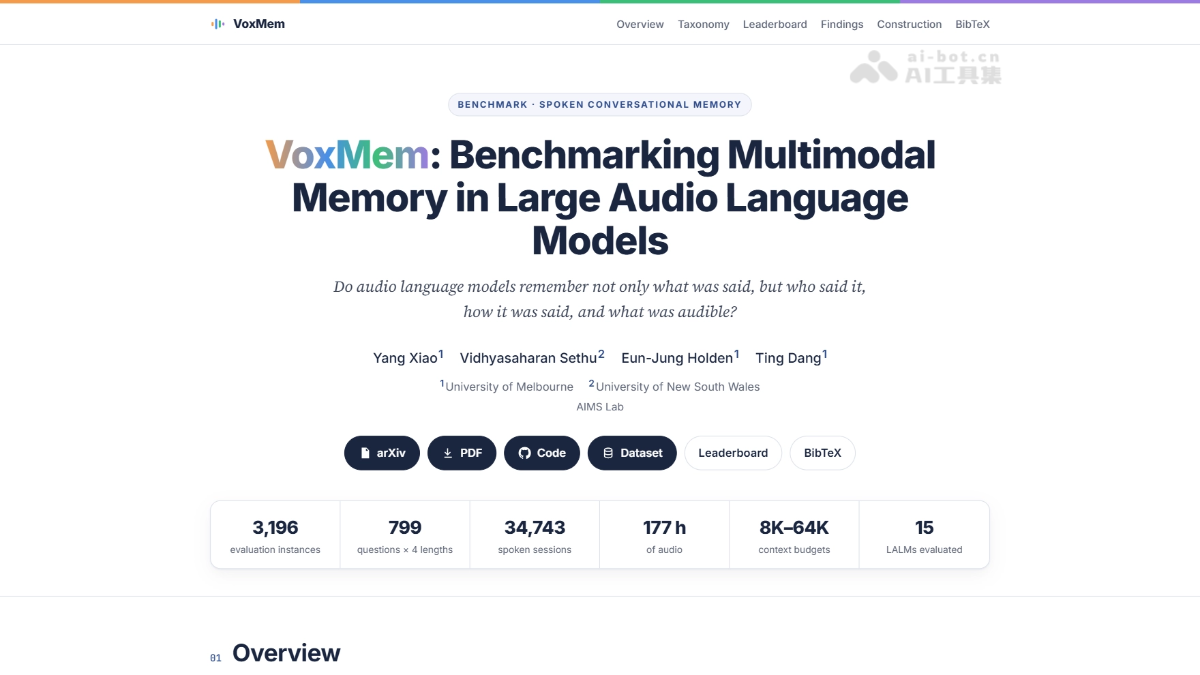
VoxMem ni kipimo cha kumbukumbu cha miundo mikubwa ya sauti kilichozinduliwa na timu kutoka Chuo Kikuu cha Melbourne na Chuo Kikuu cha New South Wales. Kinaanzisha kwa mara ya kwanza aina 4 za ushahidi wa akustika: maana, mzungumzaji, toni na sauti za mazingira × aina 4 za shughuli za kumbukumbu: uchimbaji, hoja kati ya vipindi, ufuatiliaji wa mfululizo wa wakati na kukataa kujibu, katika mfumo wa tathmini wa vipimo viwili unaofunika historia ya vipindi vingi yenye tokeni 8K hadi 64K. Majaribio ya miundo 15 yanaonyesha kuwa chini ya 32K hakuna muundo uliofikia usahihi wa jumla unaozidi 40%. Miundo inaweza kukumbuka kilichosemwa, lakini hupata ugumu kukumbuka nani aliyesema na jinsi alivyosema; kuongeza tu muktadha wa sauti hakutoshi kufanikisha mwingiliano endelevu wa sauti.
02Vipengele vikuu vya VoxMem
Tathmini ya kumbukumbu ya sauti ya vipindi vingi: Katika mipangilio ya historia ya sauti yenye vipindi vingi na muda tofauti, mfumo hujaribu kama miundo mikubwa ya lugha ya sauti inaweza kukumbuka na kurejelea maudhui ya mazungumzo yaliyotangulia.
Ufunikaji wa aina nne za ushahidi wa akustika: Huchunguza kwa pamoja maana ya usemi, utambulisho wa mzungumzaji, vidokezo vya para-lugha na sauti za mazingira. Aina tatu za mwisho ni taarifa za “asili ya sauti” ambazo haziwezi kurejeshwa kutoka kwenye unukuzi.
Uainishaji wa shughuli nne za kumbukumbu: Unajumuisha uchimbaji wa taarifa, hoja kati ya vipindi vingi, ufuatiliaji wa mabadiliko ya hali kwa wakati na kukataa kujibu ushahidi hautoshi. Kila jozi huunda seli 15 halali za tathmini.
Udhibiti wa urefu wa historia: Swali lilelile huwa na ushahidi usiobadilika katika urefu wa historia wa tokeni 8K/16K/32K/64K; huongezwa tu vipindi vya kuvuruga, hivyo athari ya urefu kwenye kumbukumbu inaweza kutengwa.
Mfumo wa tathmini ulio wazi: Msimbo na data zote ni za chanzo huria, pamoja na hati sanifu za uendeshaji, hati za ukadiriaji na Leaderboard. Mfumo huu unaunga mkono miundo ya API na ya ndani.
03Kanuni ya kiufundi ya VoxMem
Mfuate WeChat na ujibu “开源” ili ujiunge na kundi la mawasiliano la miradi ya AI ya chanzo huria
Muundo wa uainishaji wa vipimo viwili: Kiini cha VoxMem ni jedwali la uainishaji lenye vipimo viwili: ushahidi wa akustika × shughuli ya kumbukumbu. Ushahidi wa akustika hujibu kile kinachopaswa kukumbukwa; taarifa ya sauti hugawanywa katika maana, mzungumzaji, para-lugha na sauti za mazingira. Shughuli ya kumbukumbu hujibu jinsi taarifa inavyotumiwa, ikijumuisha kurejesha taarifa kutoka kwenye kipindi kimoja (IE), kuunganisha ushahidi kutoka vipindi vingi (MSR), kufuatilia mabadiliko ya hali kwa mpangilio wa wakati (TET), na kukataa kujibu ushahidi hautoshi (AR). Mchanganyiko wa maana × IE umeondolewa kwa makusudi kwa kuwa unadidimia na kuwa utafutaji wa maandishi pekee. Seli 15 zilizobaki huunda nafasi kamili ya tathmini, na kuhakikisha uwezo wa kumbukumbu ya akustika unachunguzwa kwa utaratibu badala ya vipande vilivyotawanyika.
Uundaji wa data katika hatua tatu: Uzalishaji wa data hufuata mchakato wa “kupanga—kuandika mazungumzo—kuunganisha sauti”: kwanza, mpango uliopangwa huzalishwa kwa kila swali, ukibainisha swali, jibu, usambazaji wa ushahidi na masharti ya uhalali (; kisha maandishi ya mazungumzo ya upande wa mtumiaji na msaidizi huzalishwa kando. Hakuna upande unaotaja mzungumzaji, toni au sauti ya mazingira, ili kuzuia jibu kuvuja kupitia maandishi; hatimaye sauti huunganishwa kwa TTS. Kila mtumiaji hupewa sauti thabiti, vidokezo vya toni huongezwa kupitia udhibiti wa mtindo, sauti za mazingira huingizwa kwa uwiano wa ishara kwa kelele wa 10dB, na kwa kila zamu yenye kidokezo huhifadhiwa toleo pacha lililoondolewa kidokezo kwa ajili ya ukaguzi wa ubora.
Vipindi vya kuvuruga na udhibiti wa urefu: Kila historia huundwa na vipindi vya ushahidi, vipindi vya kuvuruga na vipindi vya kujaza. Vipindi vya kuvuruga vina mada zinazofanana na mada ya ushahidi lakini thamani tofauti. Kichanganuzi kinachoangalia maandishi pekee, chenye usahihi wa 51–56%, hutumika kuthibitisha kuwa muundo hauwezi kupata jibu kwa kulinganisha mada za juu juu. Kwa udhibiti wa urefu, viwango vinne vya historia vimepangwa kwa ujumuishaji mkali; vipindi vya kujaza visivyohusiana pekee ndivyo huongezwa, huku swali, jibu na ushahidi vikibaki vilevile katika viwango vyote. Kwa hiyo, mabadiliko ya usahihi yanaweza kuhusishwa tu na kuongezeka kwa urefu wa historia, bila kuchanganywa na ugumu wa swali.
04Jinsi ya kutumia VoxMem
Klonisha hazina: Vuta msimbo kutoka GitHub kwa kutumia git clone https://github.com/swagshaw/voxmem kisha uingie kwenye saraka ya mradi.
Sakinisha vitegemezi: Endesha pip install -r requirements.txt; kwa hiari sakinisha pip install "datasets" ili sauti zisimbuliwe kiotomatiki kuwa safu.
Sanidi funguo za API: Ikiwa unatathmini muundo wa API, sakinisha SDK inayohusika na uweke ufunguo, kwa mfano pip install openai kisha export OPENAI_API_KEY=.
Endesha jaribio la moshi: Kwanza tumia python run_voxmembench.py --config 8k_speaker_information --model abstain --allow-abstention --limit 25 --out predictions_smoke.jsonl kuthibitisha mchakato, kisha tumia score_voxmembench.py --judge exact-match kukadiria. Thibitisha kuwa safu ya kukataa inapata 1.0 kwenye maswali ya kukataa na 0.0 kwenye maswali yanayoweza kujibiwa.
Tathmini rasmi: Chagua usanidi, kama seti kamili ya 32k au sehemu ya 32k_speaker_information, pamoja na muundo lengwa, kwa mfano python run_voxmembench.py --config 32k --model openai:gpt-4o-audio-preview --allow-abstention --out predictions_32k.jsonl; miundo ya ndani inahitaji --adapter kubainisha kitendakazi maalum cha urekebishaji na --model-dir kuelekeza kwenye saraka ya uzani.
Ukadiriaji na mwamuzi wa LLM: Endesha python score_voxmembench.py --predictions predictions_32k.jsonl --judge openai:gpt-4o-mini --out metrics_32k.json. Mwamuzi huangalia tu swali, jibu la kawaida na jibu lililotolewa, kisha huamua usawa wa majibu ya wazi.
05Faida kuu za VoxMem
Kipimo cha kwanza kinachofunika kwa utaratibu kumbukumbu asilia ya sauti: Kinavuka kizuizi cha vipimo vilivyopo vinavyochunguza maudhui ya maneno pekee, na kwa mara ya kwanza kinajumuisha taarifa zisizo za maandishi kama nani alisema, jinsi alivyosema na alichosikia katika mfumo mmoja wa tathmini.
Muundo thabiti wa uainishaji wa vipimo viwili: Seli 15 halali za aina 4 za ushahidi wa akustika × aina 4 za shughuli za kumbukumbu hubadilisha uteuzi wa maswali uliotawanyika, na kufanya uwezo wa kumbukumbu ya sauti uweze kugawanywa na kuchunguzwa kikamilifu na kwa kujitegemea.
Mipangilio ya vipindi vingi iko karibu na hali halisi: Huiga vipindi vingi vya mwingiliano wa sauti kati ya binadamu na mashine vinavyotenganishwa na wakati, badala ya monolojia moja ndefu, na hujaribu kumbukumbu ya muda mrefu ya miundo kuhusu mzungumzaji anayejirudia na masasisho ya hali.
Athari ya urefu imetenganishwa kikamilifu: Swali lilelile lina ushahidi uliopachikwa kwa uthabiti na usiobadilika katika urefu wa historia wa 8K hadi 64K. Kwa mara ya kwanza, athari ya “historia kuwa ndefu” imetenganishwa cleanly na ugumu wa swali na aina ya ushahidi.
Uundaji unaozuia uvujaji na ukaguzi wa ubora wa mara mbili: Pande zote za mazungumzo hazitaji vidokezo vya akustika, matoleo pacha hulinganishwa, na ukaguzi wa ngazi mbili huondoa maswali yanayoweza kujibiwa kwa unukuzi pekee. Hii huhakikisha kuwa swali linahitaji “kusikiliza” badala ya “kusoma”.
Muundo wa kuvuruga unaozuia njia za mkato: Vipindi vya kuvuruga vyenye mada zinazofanana lakini thamani tofauti, pamoja na uthibitishaji wa kichanganuzi cha maandishi chenye usahihi wa 51–56%, huzuia kutafuta jibu kwa kulinganisha maneno muhimu.
06Anwani za mradi wa VoxMem
Tovuti rasmi ya mradi: https://swagshaw.github.io/voxmem/
Hazina ya GitHub: https://github.com/swagshaw/voxmem
Hazina ya miundo ya HuggingFace: https://huggingface.co/datasets/AudioMemory/voxmembench
Makala ya kiufundi ya arXiv: https://arxiv.org/pdf/2609.32607
07Matukio ya matumizi ya VoxMem
Uteuzi wa uwezo wa kumbukumbu ya muda mrefu wa wasaidizi wa sauti/spika mahiri: Watengenezaji wanaweza kutumia VoxMem kujaribu kwa usawa kama miundo lengwa inaweza kukumbuka mapendeleo ya mtumiaji, sauti za wanafamilia na ahadi za awali kati ya vipindi, ili kuzuia hali ya “kusahau mara moja alichosema wiki iliyopita” baada ya kuzinduliwa.
Tathmini ya mwingiliano wa sauti kwenye magari na vifaa vinavyovaliwa: Sauti za ndani ya gari huwa na kelele na toni za watumiaji hubadilika. Vipimo vya sauti za mazingira na vidokezo vya para-lugha vya VoxMem vinaweza kupima uaminifu wa kumbukumbu ya muundo katika mazingira halisi yenye kelele.
Ukaguzi wa ubora wa mifumo ya huduma kwa wateja na mikutano yenye wazungumzaji wengi: Vituo vya huduma kwa wateja na muhtasari wa mikutano vinahitaji kuhusisha kwa usahihi “sentensi gani ilisemwa na nani”. Kipimo cha VoxMem cha makosa ya kuhusisha mzungumzaji kinaweza kutumika moja kwa moja kutambua tatizo la “kumchanganya mtu na mwingine” katika mifumo hii.
Uthibitishaji wa kumbukumbu ya hisia kwa roboti wasaidizi na bidhaa za kuwajali wazee: Jambo alilolisema mzee wiki iliyopita huku akihema, au uchovu uliojitokeza katika toni yake, unaweza kubebwa na vidokezo vya para-lugha pekee. Kipimo cha ufuatiliaji wa mfululizo wa wakati cha VoxMem kinaweza kujaribu kama bidhaa inaweza kutambua mabadiliko ya hali kadiri muda unavyopita.
© Kanusho: vikoa na maudhui yaliyounganishwa vinaweza kubadilika kadiri muda unavyopita. AIEZZ haidhibiti tovuti za wahusika wengine. Kagua maudhui na hatari za nje kwa kujitegemea.
Ukaguzi wa watumiaji0