
- Ziara za kila mwezi
- 0
- Bei
- Haijawekwa
- Imeorodheshwa
- —
- Imesasishwa
- 2026-10-09
01Naive-N0.5-Flash ni nini
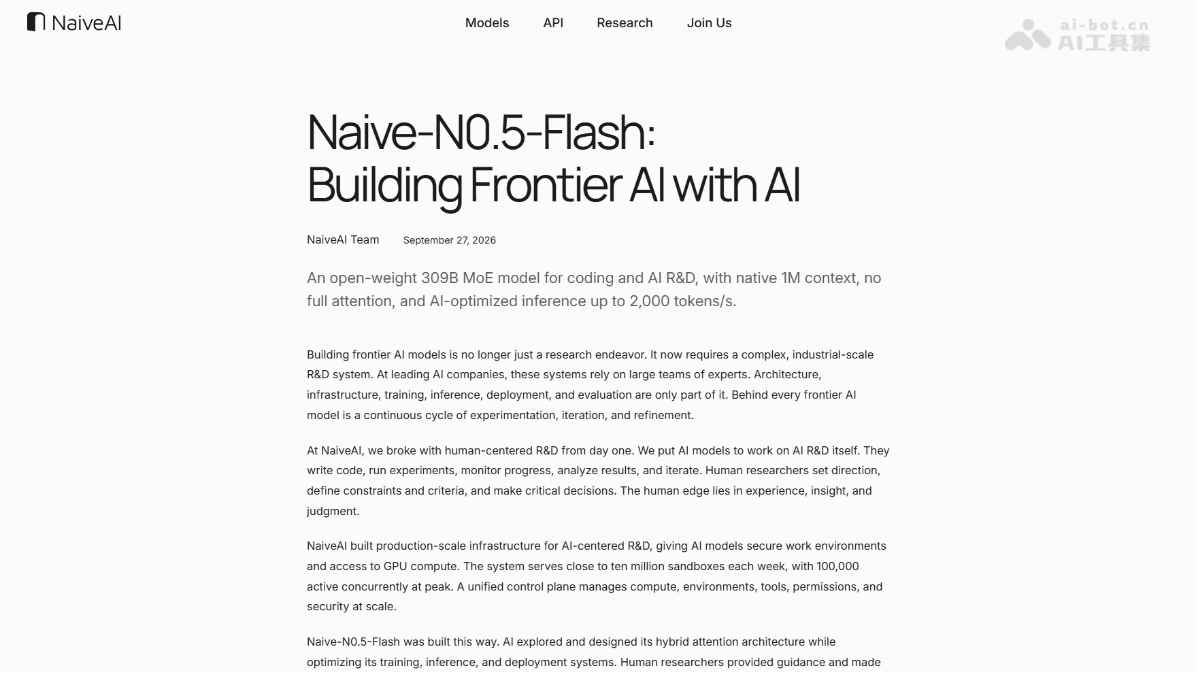
Naive-N0.5-Flash ni modeli kubwa ya kwanza ya MoE iliyowaziwa na NaiveAI, inayolenga programu na utafiti na uundaji wa AI. Naive-N0.5-Flash imeboreshwa kutoka modeli msingi ya Xiaomi MiMo-V2.5, ikiwa na usanifu wa 309B MoE, ikitumia umakini mseto wa SWA+DSA wenye uchache, inasaidia asili muktadha wa 1M bila safu yoyote ya umakini kamili. Modeli hii imetengenezwa kwa ushiriki mkubwa wa AI, huku mfumo wa uelekezaji NaiveRT ukifikia kilele cha tokens/s 2122 katika usimbuaji wa mkondo mmoja.
02Vipengele vikuu vya Naive-N0.5-Flash
Programu yenye muktadha mrefu: Inasaidia asili muktadha wa token 1M, na inaweza kushughulikia hazina ndefu za msimbo pamoja na kazi za uhandisi wa programu za muda mrefu.
Msaada wa utafiti na uundaji wa AI: Inaweza kusoma karatasi za utafiti, kurudia mbinu, kuendesha majaribio na kuchanganua matokeo, ikishiriki moja kwa moja katika mchakato mzima wa utafiti wa modeli.
Uharakishaji wa uelekezaji: Mfumo wa uelekezaji NaiveRT una kasi ya kawaida ya tokens/s 50, na kilele cha tokens/s 2,122 katika usimbuaji wa mkondo mmoja katika hali ya kasi ya juu.
Utafiti unaojitegemea: Baada ya kupewa lengo, bajeti ya rasilimali za kompyuta na itifaki ya tathmini, inaweza kuendeleza utafiti kwa kujitegemea kutoka mwanzo hadi mwisho.
03Kanuni ya kiteknolojia ya Naive-N0.5-Flash
Fuata WeChat na ujibu “开源” ili kujiunga na kikundi cha mawasiliano cha miradi huria ya AI
Umakini mseto wa SWA–DSA wenye uchache: Modeli hii inategemea modeli msingi ya MiMo-V2.5, ikibadilisha safu za umakini wa kimataifa zenye gharama kubwa kuwa umakini wa uchache wa DeepSeek, na kuzipanga kwa kupishana kwa uwiano wa 5:1 na umakini wa dirisha linaloteleza. Mtandao mzima hauna safu yoyote ya umakini kamili. SWA hushughulikia dirisha la ndani la tokeni 128, huku DSA ikitumia kiashiria chepesi kukadiria historia yote na kuchagua tokeni 2048 za juu kwa ajili ya kukokotoa kwenye mtandao mkuu.
Muundo wa kiashiria chepesi: MLA ya awali ya DSA imebadilishwa kuwa GQA, na vichwa vya hoja vya kiashiria vimepunguzwa kutoka 64 hadi 16. Hii hupunguza muda wa njia ya uteuzi wa kiashiria kwa 44%, huku utendaji ukiendelea bila kupungua kwenye kazi za Agent zenye muktadha wa 1M.
Mchakato wa mafunzo wa hatua tatu: Kwanza, mtandao mkuu hugandishwa kwenye tokeni 50B, na usambazaji wa kiashiria hupatanishwa na usambazaji wa umakini kamili kwa kutumia hasara ya KL divergence; kisha umakini wa uchache huwashwa na mafunzo ya awali yanaendelea kwa tokeni 3T ili kuzoea mbinu mpya ya kuchagua taarifa na kuimarisha uwezo wa programu na utafiti; hatimaye, urekebishaji unaosimamiwa hufanywa kwa tokeni 200B huku kiwango cha kujifunza kikishushwa. Muktadha wa 1M hudumishwa katika mchakato mzima, huku AI ikikamilisha kiotomatiki uchanganuzi wa urejeshaji wa top-k na marekebisho ya uthabiti wa nambari.
Usambazaji mseto wa mfuatano na uboreshaji wa kumbukumbu ya video: Kwa kuzingatia tofauti kwamba SWA inahitaji dirisha la ndani pekee, ilhali DSA inahitaji historia yote, usambazaji wa mfuatano wa Halo hutumiwa kwa kila moja. Kwa upande wa kumbukumbu ya video, uzibaji wa uamilisho hufanywa kwa kiwango cha opereta, na faharasa za top-k huhifadhiwa wazi ili kuepuka ukokotoaji upya kubadilisha uteuzi. Kadi 512 zinaweza kutoa mafunzo kwa tokeni 1T ndani ya takriban siku 4.
Uboreshaji wa uelekezaji wa NaiveRT: Kupitia muunganiko mkubwa wa opereta, PDL inayowezesha kernel za mkondo wa juu na wa chini kutekelezwa kwa kuingiliana, pamoja na kuendesha mzunguko wa usimbuaji wa kubahatisha kikamilifu kwenye GPU, muda wa kusubiri wa usimbuaji wa kila mzunguko hupunguzwa kutoka 12.3ms hadi 3.4ms. Pia inasaidia sampuli yenye uamuzi wa biti kwa biti kulingana na mbegu ya nasibu, kuhakikisha kuwa sampuli na logprob ya mafunzo zinalingana wakati wa mafunzo ya RL. Maboresho yote hupimwa kwa njia halisi ya modeli kutoka mwanzo hadi mwisho.
04Jinsi ya kutumia Naive-N0.5-Flash
Thibitisha maunzi: Inahitaji GPU ya NVIDIA inayotumia FP8. Uzito wa modeli ni takriban 315GB, hivyo kumbukumbu ya ziada ya video inapaswa kutengwa.
Pata uzito wa modeli: Pakua hazina ya NaiveAI/Naive-N0.5-Flash-FP8 kutoka Hugging Face.
Sakinisha vitegemezi: Tekeleza pip install "transformers[torch,kernels]>=5.17.0".
Pakia modeli: Tumia AutoTokenizer na AutoModelForCausalLM kupakia modeli kwa trust_remote_code=True na device_map="auto".
Unda ingizo: Tumia apply_chat_template kupitisha ujumbe wa mazungumzo na kuzalisha tenzari za ingizo.
Zalisha matokeo: Ita model.generate() ili kuzalisha jibu, kisha tumia tokenizer.decode() kusimbua matokeo.
Weka vigezo: Kwa matumizi ya jumla, inapendekezwa temperature=1.0 na top_p=0.95.
Rudia uelekezaji wa utendaji wa juu: Ili kufikia kasi ya tokens/s 2,122, unaweza kupata msimbo huria wa NaiveRT, mazingira ya Docker Compose na hati za kipimo zinazohusiana, kisha kuvisambaza mwenyewe.
05Faida kuu za Naive-N0.5-Flash
Muktadha mrefu sana: Inasaidia asili muktadha wa token 1M, na mtandao mzima hauna safu ya umakini kamili, hivyo gharama ya kusimbua mfuatano mrefu ni ndogo sana kuliko usanifu wa kawaida.
Kasi bora ya uelekezaji: Mfumo wa NaiveRT una kilele cha tokens/s 2,122 katika usimbuaji wa mkondo mmoja, huku muda wa kusubiri wa usimbuaji wa kubahatisha ukiwa umepunguzwa kwa 72.4% ikilinganishwa na SGLang.
Uwezo bora wa utafiti na uundaji: PaperBench 63.2, MLE-bench-30 73.7%, NanoGPT SpeedRun 73.8s; katika tathmini kadhaa za utafiti na uundaji wa AI, inazidi modeli za kiwango sawa.
Utafiti na uundaji wa asili wa AI: AI ilishiriki katika kubuni usanifu na kuboresha mfumo wa modeli hii, ikitekeleza kwa vitendo dhana ya “AI inayotafiti na kuunda AI,” ambapo binadamu huweka malengo na AI hutekeleza marudio.
Uwezo wa utafiti unaojitegemea: Baada ya kupewa lengo na bajeti, inaweza kukamilisha utafiti kwa kujitegemea kutoka mwanzo hadi mwisho, ikitoa modeli ya ulimwengu ya AutoWM kwa mafunzo ya saa 400 na kushika nafasi ya kwanza kwenye WorldArena.
06Anwani za mradi wa Naive-N0.5-Flash
Tovuti rasmi ya mradi: https://naive.ai/en/research/
Hazina ya GitHub: https://github.com/NaiveAI-Labs/Naive-N0.5-Flash
Hazina ya modeli ya HuggingFace: https://huggingface.co/NaiveAI/Naive-N0.5-Flash
07Matukio ya matumizi ya Naive-N0.5-Flash
Msaidizi wa utafiti na uundaji wa AI: Huwasaidia watafiti kusoma karatasi za utafiti, kurudia mbinu, kuendesha majaribio na kuchanganua matokeo, kama katika kazi za utafiti za aina ya PaperBench na MLE-bench.
Uhandisi wa programu wa muda mrefu: Kwa kutumia muktadha wa asili wa 1M, hushughulikia hazina kubwa za msimbo, ikikamilisha uelewa wa faili mbalimbali, urekebishaji wa hitilafu na uzalishaji wa msimbo wa kiwango cha hazina.
Kazi za Agent zenye muktadha mrefu: Huhifadhi historia kamili ya kazi katika matukio marefu ya mwingiliano, kama vile uendeshaji wa terminal na miito ya zana za mizunguko mingi.
Miundombinu ya mafunzo ya RL: Ikiunganishwa na kasi ya juu ya usimbuaji wa mkondo mmoja ya NaiveRT na sampuli yenye uamuzi wa biti kwa biti, huharakisha rollout za ujifunzaji wa kuimarisha wa muda mrefu na kupunguza sampuli zinazobaki nyuma.
© Kanusho: vikoa na maudhui yaliyounganishwa vinaweza kubadilika kadiri muda unavyopita. AIEZZ haidhibiti tovuti za wahusika wengine. Kagua maudhui na hatari za nje kwa kujitegemea.
Ukaguzi wa watumiaji0