

WeMM-Embedding ni Nini?
WeMM-Embedding ni familia ya miundo ya jumla ya embeddings za aina mbalimbali iliyoundwa na timu ya WeChat Vision. Hubadilisha maandishi, picha, video, hati zinazoonekana, na ingizo za aina mbalimbali zilizochanganywa kuwa vielelezo vya vekta vilivyounganishwa. Vekta hizi zinaweza kusaidia michakato inayohitaji kuwakilisha na kulinganisha maudhui kutoka kwa aina tofauti.
Kila modeli hupata embedding yake kutoka kwenye hali fiche ya safu ya mwisho katika nafasi maalum ya tokeni ya <embedding>, kisha hutumia urekebishaji wa L2. Ingizo la sauti halitumiki kwa sasa.
Sifa Muhimu
- Vielelezo vilivyounganishwa vya aina mbalimbali: Familia hiyo hiyo ya modeli hushughulikia maandishi, picha, video, hati zinazoonekana na miingizo iliyochanganywa.
- Ukubwa mbalimbali wa modeli: Chagua kati ya vibadala vyenye vigezo 2B, 4B na 9B.
- Matokeo ya kujifunza kwa uwakilishi wa Matryoshka: Tumia vipimo vifupi vya vekta vinavyotumika wakati ufanisi wa uhifadhi au urejeshaji ni muhimu.
- Miingiliano miwili ya inference: Mifano imetolewa kwa Transformers na Sentence Transformers.
- Utoaji wa huduma katika uzalishaji: Hazina inajumuisha usanidi na hati za wrapper za vLLM na SGLang.
- Zana za tathmini: Bomba la MMEB-v3 lililojumuishwa linaunga mkono inference ya nodi moja na nodi nyingi.
Chagua Modeli na Kipimo
Hifadhi ya modeli ina vibadala vitatu kwenye Hugging Face. Chagua modeli kulingana na rasilimali zako za kompyuta na ukubwa kamili wa embedding unaohitajika.
- WeMM-Embedding-2B: Inatumia vipimo 64, 128, 256, 512, 1024 na 2048.
- WeMM-Embedding-4B: Inatumia vipimo 64, 128, 256, 512, 1024 na 2560.
- WeMM-Embedding-9B: Inatumia vipimo 64, 128, 256, 512, 1024, 2048 na 4096.
Kipimo kidogo kinachotumika hupunguza uhifadhi wa vekta na ukokotoaji wa baadaye. Kwa mfano, README inaripoti kuwa modeli ya 2B yenye vipimo 256 huhifadhi 98.7% ya utendaji wake wa picha na video wa vipimo kamili kwenye MMEB-v2.
Usakinishaji na Usanidi
1. Pata hazina na modeli
Fanya kazi kutoka kwenye nakala ya ndani ya hazina, kisha pakua modeli kutoka kwenye ukurasa wake wa Hugging Face au sanidi mfano husika ili utumie kitambulisho cha modeli ya Hugging Face inapowezekana.
2. Sakinisha vitegemezi
Sakinisha matoleo yaliyotangazwa na mradi:
pip install -r requirements.txt3. Weka toleo maalum la Transformers
Mradi unapendekeza transformers==5.2.0 kwa inference na uweza wa kurudia matokeo, kwa sababu matoleo mapya yanaweza kutofautiana katika tabia ya uchakataji wa awali.
pip install transformers==5.2.0Andaa njia za modeli yako, picha ya majaribio na video ya majaribio kabla ya kuendesha mifano.
Matumizi ya Msingi kwa Transformers
Mfano wa Transformers huzalisha embeddings huru kwa miingizo ya maandishi, picha na video. Iendeshe kwa njia ya modeli ya ndani na kipimo kinachotumika:
python examples/transformers_inference.py \
  --model /path/to/WeMM-Embedding-2B \
  --image /path/to/image.jpg \
  --video /path/to/video.mp4 \
  --dimension 2048
Badilisha njia za mfano kwa faili zilizo kwenye mfumo wako. Kwa modeli ya 2B, 2048 ni ukubwa kamili wa vekta. Ili kuomba kipimo kamili cha embedding cha modeli bila kukitaja wazi, ondoa --dimension:
python examples/transformers_inference.py \
  --model /path/to/WeMM-Embedding-2B \
  --image /path/to/image.jpg \
  --video /path/to/video.mp4
Matumizi ya Msingi kwa Sentence Transformers
Mfano wa Sentence Transformers hupitisha miingizo ya maandishi, picha na video kupitia SentenceTransformer.encode(). Pia unaunga mkono uteuzi wa kipimo cha Matryoshka kupitia --dimension.
python examples/sentence_transformers_inference.py \
  --model /path/to/WeMM-Embedding-2B \
  --image /path/to/image.jpg \
  --video /path/to/video.mp4 \
  --dimension 2048
Kwa kuwa SentenceTransformer inaweza kupakia modeli moja kwa moja, unaweza kubadilisha njia ya ndani na kitambulisho cha modeli ya Hugging Face:
python examples/sentence_transformers_inference.py \
  --model tencent/WeMM-Embedding-2B \
  --image /path/to/image.jpg \
  --video /path/to/video.mp4 \
  --dimension 2048
Tumia Embeddings za Matryoshka kwa Usahihi
Embeddings za Matryoshka hukuruhusu kufupisha vekta kamili hadi kwenye mojawapo ya vipimo vinavyotumiwa na modeli iliyochaguliwa. Kata mhimili wa mwisho kisha urekebishe tena vekta iliyofupishwa:
embedding = torch.nn.functional.normalize(
    embedding[..., :d],
    dim=-1
)
Weka d kuwa kipimo kilichoorodheshwa kwa modeli yako pekee. Hatua ya pili ya urekebishaji ni muhimu kwa sababu ukataji hubadilisha norm ya vekta. Unapotumia mifano ya mstari wa amri iliyotolewa, chagua kipimo cha Matryoshka unachotaka kwa kutumia --dimension.
Toa Huduma ya Modeli kwa vLLM
Hazina inaripoti majaribio yaliyofanywa kwa vLLM 0.27.0. Anzisha seva ya pooling na utoe templeti ya mazungumzo ya embedding ya modeli:
MODEL_PATH=/path/to/WeMM-Embedding-2B
vllm serve "$MODEL_PATH" \
  --runner pooling \
  --chat-template "$MODEL_PATH/embedding_chat_template.jinja"
Wrapper sawa inapatikana kwenye scripts/serve_vllm.sh.
Toa Huduma ya Modeli kwa SGLang
SGLang 0.5.9 ndiyo toleo lililojaribiwa na kuandikwa na mradi. Tumia kiraka cha video kilichotolewa kabla ya kuanzisha seva ya embedding:
MODEL_PATH=/path/to/WeMM-Embedding-2B
python scripts/patch_sglang_video.py
python -m sglang.launch_server \
  --model-path "$MODEL_PATH" \
  --is-embedding \
  --enable-precise-embedding-interpolation
Hifadhi hii pia hutoa scripts/serve_sglang.sh kama kifuniko cha kuendesha kwa amri moja.
Endesha Tathmini ya MMEB-v3
Saraka ya mmeb_v3_eval/ ina msimbo wa tathmini uliotumika kupata matokeo yaliyoripotiwa ya MMEB-v3. Unategemea mchakato rasmi wa VLM2Vec na unaongeza mfumo wa WeMM-Embedding, maelekezo yaliyolinganishwa ya seti za data, uelekezaji wa makundi, utekelezaji wa nodi nyingi na GPU nyingi, pamoja na sampuli za video za fremu 64.
Kwanza ingia kwenye saraka ya tathmini na upakue data:
cd mmeb_v3_eval
DATA_ROOT=/path/to/MMEB-V3 bash scripts/download_data.sh
Kisha endesha tathmini ukitumia njia za modeli, seti ya data na matokeo yako:
MODEL_PATH=/path/to/WeMM-Embedding-2B \
DATA_BASEDIR=/path/to/MMEB-V3 \
OUTPUT_DIR=exps/wemm_embedding \
bash scripts/run_eval.sh
Angalia mmeb_v3_eval/README.md kwa usanidi wa data ulioandikwa na amri za nodi moja au nodi nyingi.
Vidokezo vya Juu
- Linganishia vipimo na modeli: Usiombe vipimo 2560 kutoka kwa modeli ya 2B au vipimo 4096 kutoka kwa modeli ya 4B. Tumia vipimo vilivyoorodheshwa kwa checkpoint iliyochaguliwa pekee.
- Fanya urekebishaji wa kawaida wa vekta zilizopunguzwa: Ukifupisha mwenyewe embedding kamili, tumia urekebishaji wa L2 kila mara baadaye.
- Weka uchakataji wa awali unaoweza kurudiwa: Tumia toleo linalopendekezwa la Transformers unapojaribu tena kupata matokeo, kwa sababu uchakataji wa awali unaweza kubadilika kati ya matoleo.
- Tumia njia inayofaa ya upakiaji: Amri iliyoandikwa ya Transformers hutumia njia ya modeli, huku mfano wa Sentence Transformers ukiweza pia kupakia
tencent/WeMM-Embedding-2Bmoja kwa moja. - Zingatia sauti isiyoungwa mkono: Kwa sasa modeli hazipokei sauti, hivyo alama iliyoripotiwa ya sauti ya MMEB-v3 ni sifuri.
- Tumia vifuniko vya kuhudumia kwa urahisi: Skripti za shell katika
scripts/hujumuisha usanidi wa kuanzisha vLLM na SGLang ulioandikwa.
Muktadha wa Utendaji
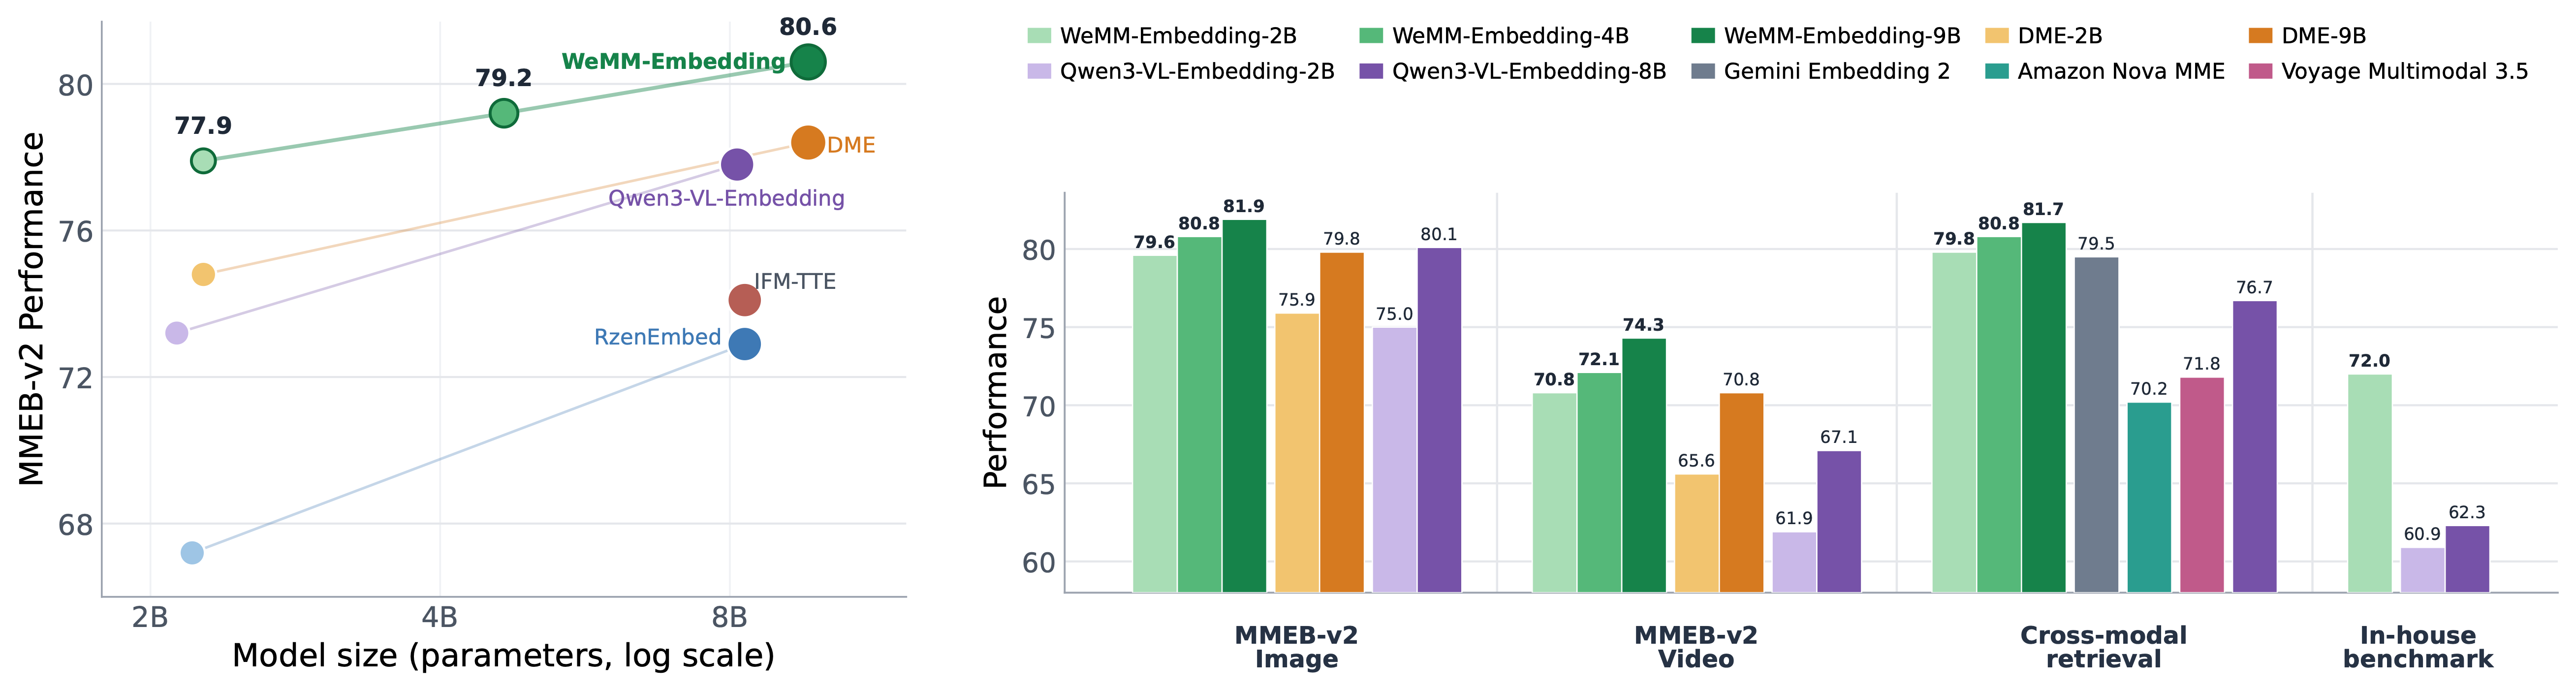
README inaripoti matokeo katika seti za data 78 za MMEB-v2 na kazi zote 190 za MMEB-v3. Kwenye MMEB-v2, matoleo ya 2B, 4B na 9B yanaripoti wastani wa alama 77.9, 79.2 na 80.6 mtawalia. Kwenye MMEB-v3, alama zao za jumla zilizoripotiwa ni 56.0, 58.2 na 59.5. Vipimo hutofautiana kulingana na kundi la kazi: kazi za picha na video hutumia Hit@1, kazi za hati za kuona na maandishi hutumia NDCG@5, na kazi za wakala, MCMR na sauti hutumia Hit@1.
Alama za ulinganishaji zinapaswa kutafsiriwa kwa kuzingatia ufunikaji wa kazi ulioandikwa. MMEB-v3 hutoa alama sifuri kwa kazi zisizoungwa mkono, ikiwemo sauti kwa WeMM-Embedding.
Hitimisho
WeMM-Embedding hutoa familia moja ya modeli kwa kutengeneza uwakilishi uliorekebishwa wa kawaida kutoka kwa aina kadhaa za ingizo la kuona na maandishi. Anza na checkpoint ya 2B na mfano wa uelekezaji uliotolewa, chagua kipimo cha Matryoshka kinachoungwa mkono pale vekta fupi zinapokuwa muhimu, kisha hamia kwenye vLLM, SGLang au mchakato wa MMEB-v3 unapohitaji kuhudumia au kutathmini. Msimbo wa hifadhi ulioandikwa na Tencent umetolewa chini ya Leseni ya Apache 2.0 isipokuwa imeelezwa vinginevyo.