
LLaMA Factory (ambayo sasa imepewa jina jipya la LlamaFactory) ni mfumo wa pamoja wa kufanya fine-tuning kwa miundo mikubwa ya lugha. Mradi huu ulianzishwa na timu ya Dkt. Zheng Yaowei kutoka Chuo Kikuu cha Beihang, na unaungwa mkono kitaaluma na makala ya ACL 2024. Mfumo huu unatumia muundo wa “CLI isiyohitaji msimbo + Web UI” kwa lengo la kurahisisha mchakato wa fine-tuning. LlamaFactory imepata zaidi ya Stars 72 000 kwa jumla kwenye GitHub, na imekuwa utekelezaji wa marejeo katika eneo la fine-tuning ya miundo mikubwa.
>
I. Muhtasari wa mradi
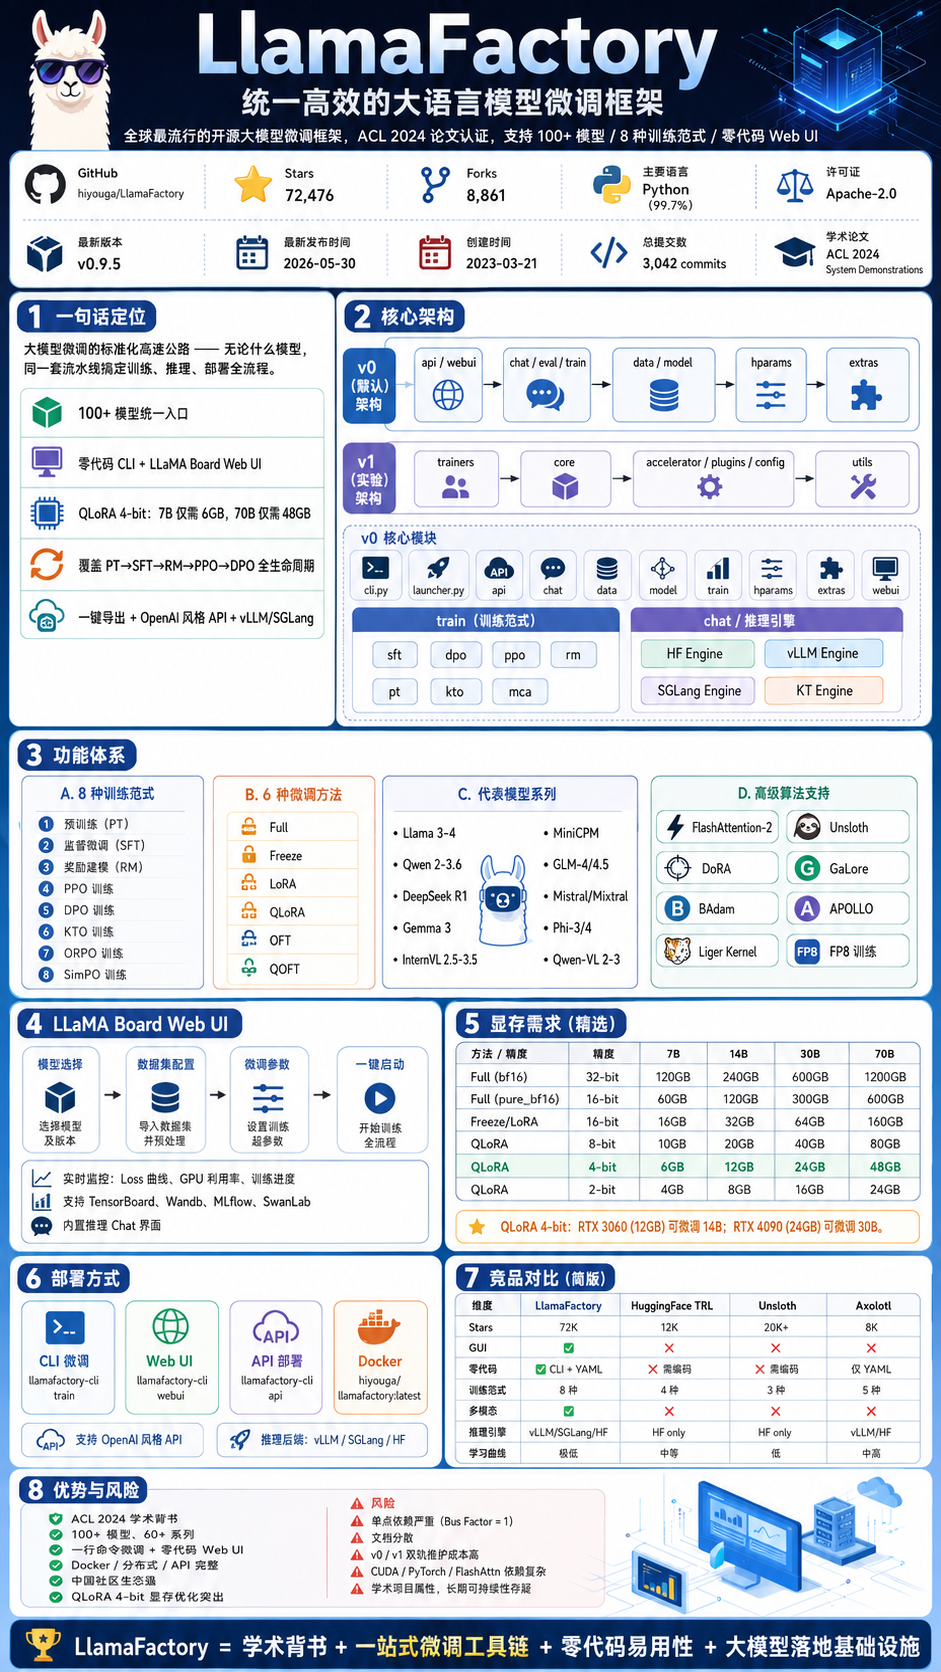
Kipengele|Maelezo
Jina kamili la mradi|LlamaFactory (zamani LLaMA-Factory)
Anwani ya GitHub|github.com/hiyouga/LlamaFactory
Stars|72,476 ⭐
Forks|8,861
Lugha kuu|Python (99.7%)
Leseni|Apache-2.0
Tarehe ya kuundwa|2023-03-21
Toleo jipya zaidi|v0.9.5 (2026-05-30)
Jumla ya commits|3,042 commits
Mtengenezaji mkuu|hiyouga (Zheng Yaowei, commits 2,188, sawa na 72% ya commits zote)
Makala ya kitaaluma|ACL 2024 System Demonstrations
Ukubwa wa hazina|~412.9 MB
Issues zilizo wazi|57
Mwanzilishi Zheng Yaowei (hiyouga) ni mwanafunzi wa uzamivu katika Chuo Kikuu cha Beihang. Akiwa mwandishi wa kwanza, amewahi kuchapisha makala nyingi katika mikutano ya kimataifa ya kiwango cha juu kama ACL, CVPR na WWW, na pia amewahi kuwa mhakiki wa mikutano kama AAAI na EMNLP. Tuzo alizopata zinajumuisha Huawei Cup, tuzo ya kwanza ya kitaifa ya Blue Bridge Cup, Beihang Student of the Year na tuzo ya Ascend Ecosystem Open Source Outstanding Contribution. Washiriki wa timu ya ushirikiano ni pamoja na maprofesa wa Beihang Zhang Richong, Zhang Junhao, Ye Yanhan, Luo Zheyan, Feng Zhangchi na Ma Yongqiang.
II. Nafasi ya mradi na thamani yake kuu
2.1 Nafasi kwa sentensi moja
Mchakato sanifu wa fine-tuning ya miundo mikubwa: mtiririko wa pamoja unaofaa kwa modeli yoyote, unaojumuisha hatua zote kuanzia utayarishaji wa data, mafunzo ya modeli, uthibitishaji wa inference hadi deployment.
2.2 Changamoto kuu zinazotatuliwa
Changamoto|Suluhisho la LLaMA Factory
Michakato ya fine-tuning hutofautiana kati ya modeli, hivyo gharama ya kubadilisha ni kubwa|Muundo wa “kutenganisha” algorithm-model-data, wenye kiingilio kimoja cha zaidi ya modeli 100
Kuandika msimbo wa fine-tuning kunahitaji ujuzi wa kina wa deep learning|CLI isiyohitaji msimbo + LLaMA Board Web UI (Gradio)
Kumbukumbu ya GPU haitoshi, hivyo GPU za kiwango cha mtumiaji haziwezi kufundisha modeli kubwa|QLoRA 4-bit: 7B inahitaji 6GB pekee, na 70B inahitaji 48GB pekee
Jamii ya open source inakosa toolchain ya kila kitu katika sehemu moja|Inashughulikia mzunguko mzima wa maisha wa PT→SFT→RM→PPO→DPO
Deployment ya inference ni changamano|Export kwa hatua moja + API ya mtindo wa OpenAI + vLLM/SGLang
2.3 Falsafa ya muundo: “kutenganisha” algorithm-model-data
Katika mahojiano maalum, Zheng Yaowei alilinganisha mchakato wa inference ya modeli na gari linalosafiri kwenye barabara kuu sanifu. Modeli yenyewe ni sawa na aina tofauti za magari, huku data ikiwa sawa na mizigo iliyobebwa kwenye magari hayo. Mradi tu modeli inaweza kufanya kazi vizuri kwenye barabara hii kuu, mchakato wa fine-tuning unaweza kukamilishwa kwa kurekebisha vigezo pekee.
III. Uchambuzi wa kina wa usanifu wa kiteknolojia
3.1 Muundo wa usanifu wa pande mbili unaofanya kazi sambamba
LLaMA Factory hutoa kwa wakati mmoja usanifu wa v0 (toleo thabiti) na v1 (toleo la majaribio), na unaweza kubadilisha kati yao kwa kuweka environment variable USE_V1.
v0 (chaguo-msingi): api/webui → chat/eval/train → data/model → hparams → extras
v1 (majaribio): trainers → core → accelerator/plugins/config → utils
Usanifu wa v0 ndio utekelezaji mkuu kwa sasa, ukiwa na vipengele kamili na nyaraka za kutosha. Usanifu wa v1 bado uko katika hatua ya majaribio na unatumia muundo wa tabaka wenye moduli zaidi.
3.2 Maelezo ya kina ya moduli kuu za v0
src/llamafactory/
├── cli.py              # Kiingilio cha CLI, usambazaji wa amri ya llamafactory-cli
├── launcher.py          # Kianzishaji, husambaza kulingana na USE_V1
├── api/                 # REST API ya mtindo wa OpenAI
│   ├── app.py           # Programu ya FastAPI
│   ├── chat.py          # Endpoint ya mazungumzo
│   └── protocol.py      # Ufafanuzi wa itifaki
├── chat/                # Tabaka la inference engine
│   ├── base_engine.py   # Darasa msingi la kufikirika
│   ├── hf_engine.py     # Inference asilia ya HuggingFace
│   ├── vllm_engine.py   # Inference yenye utendaji wa juu ya vLLM
│   └── sglang_engine.py # Inference ya SGLang
├── data/                # Tabaka la uchakataji wa data
│   ├── template.py      # Usajili wa violezo vya Prompt vya modeli 100+
│   ├── mm_plugin.py     # Uchakataji wa multimodal (picha/video/sauti)
│   ├── loader.py        # Kipakiaji cha dataset
│   ├── processor/       # Vichakataji kulingana na hatua ya mafunzo
│   └── converter.py     # Ubadilishaji wa miundo (Alpaca/ShareGPT)
├── model/               # Tabaka la modeli
│   ├── loader.py        # Upakiaji wa modeli+tokenizer, quantization, LoRA
│   └── patcher.py       # Viraka vya ulinganifu wa modeli
├── train/               # Tabaka la mafunzo
│   ├── sft/             # Fine-tuning inayosimamiwa
│   ├── dpo/             # Uboreshaji wa mapendeleo wa DPO
│   ├── ppo/             # Reinforcement learning ya PPO
│   ├── rm/              # Uundaji wa modeli ya zawadi
│   ├── pt/              # Pre-training
│   ├── kto/             # Mafunzo ya KTO
│   └── mca/             # Ubadilishaji wa Megatron-Core
├── hparams/              # Tabaka la usanidi wa vigezo
│   ├── model_args.py    # Vigezo vya modeli
│   ├── data_args.py     # Vigezo vya data
│   ├── finetuning_args.py # Vigezo vya fine-tuning
│   └── training_args.py # Vigezo vya mafunzo (hurithi HF TrainingArguments)
├── extras/               # Vifurushi vya zana
│   ├── constants.py     # Constants/enumerations za jumla
│   └── packages.py      # Ukaguzi wa dependencies
└── webui/                # Kiolesura cha wavuti cha LLaMA Board
    ├── interface.py     # Ujenzi wa kiolesura cha Gradio
    ├── runner.py        # Uanzishaji wa kazi za mafunzo
    └── components/      # Vipengele vya UI
3.3 Mtiririko wa mafunzo (v0 Training Flow)
llamafactory-cli train xxx.yaml
  → run_exp() [tuner.py]
    → read_args() → Kuchanganua usanidi wa YAML/JSON
    → get_train_args() → Kuunda dataclass 4 zenye aina:
        ModelArguments + DataArguments + FinetuningArguments + TrainingArguments
    → Kuelekeza kwenye function maalum ya mafunzo:
        run_sft / run_dpo / run_ppo / run_rm / run_pt / run_kto
    → (Si lazima) export_model() → Kuunganisha na ku-export uzito wa LoRA
3.4 Matrix ya inference engines
Engine|Sifa|Matukio yanayofaa
HF Engine|HuggingFace asilia, ulinganifu bora zaidi|Maendeleo, utatuzi na inference ya kiwango kidogo
vLLM Engine|Kuongeza kasi ya inference kwa 270%, PagedAttention|Inference ya mtandaoni yenye utendaji wa juu
SGLang Engine|RadixAttention, uzalishaji uliopangwa|Inference ya kundi, uzalishaji changamano
KT Engine|Maalum kwa uhamishaji wa maarifa|Knowledge distillation ya modeli
IV. Mfumo wa vipengele
4.1 Paradigm za mafunzo zinazoungwa mkono (aina 8 × mbinu 6 za fine-tuning = mchanganyiko 48)
Paradigm ya mafunzo|Full|Freeze|LoRA|QLoRA|OFT|QOFT
Pre-training (PT)|✅|✅|✅|✅|✅|✅
Fine-tuning inayosimamiwa (SFT)|✅|✅|✅|✅|✅|✅
Uundaji wa modeli ya zawadi (RM)|✅|✅|✅|✅|✅|✅
Mafunzo ya PPO|✅|✅|✅|✅|✅|✅
Mafunzo ya DPO|✅|✅|✅|✅|✅|✅
Mafunzo ya KTO|✅|✅|✅|✅|✅|✅
Mafunzo ya ORPO|✅|✅|✅|✅|✅|✅
Mafunzo ya SimPO|✅|✅|✅|✅|✅|✅
4.2 Mfululizo wa modeli unaoungwa mkono (mfululizo 60+, variants 100+)
Baadhi ya modeli zilizochaguliwa:
Mfululizo wa modeli|Kiwango cha vigezo|Sifa
Llama 3-4|1B–402B|Modeli kuu ya Meta ya chanzo huria
Qwen 2-3.6|0.5B–397B|Mfululizo kamili wa Tongyi Qianwen wa Alibaba
DeepSeek R1|1.5B–671B|Toleo lililopunguzwa la modeli ya kufikiri
Gemma 3|270M–27B|Modeli nyepesi ya Google
InternVL 2.5-3.5|1B–241B|Modeli ya lugha yenye uwezo wa kuona ya aina nyingi
MiniCPM|0.5B–9B|Imeboreshwa kwa ajili ya kuendesha kwenye vifaa vya pembeni
GLM-4/4.5|9B–355B|Mfululizo wa智谱 ChatGLM
Mistral/Mixtral|7B–8x22B|Mchanganyiko wa wataalamu wa MoE
Phi-3/4|3.8B–14B|Modeli ndogo zenye utendaji wa juu za Microsoft
Qwen-VL 2-3|2B–235B|Modeli ya lugha yenye uwezo wa kuona
4.3 Usaidizi wa Algoriti za Juu
Algoriti|Kazi|Toleo la kuanzishwa
FlashAttention-2|Uharakishaji wa ukokotoaji wa attention|2023-09
Unsloth|Uharakishaji wa mafunzo kwa 170% + kuokoa 50% ya kumbukumbu ya GPU|2023-12
DoRA|Utenganishaji wa uzani wa LoRA|2024-02
GaLore|Uboreshaji wa gradient wa low-rank|2024-03
BAdam|Uboreshaji wa kushuka kwa kuratibu za vitalu|2024-04
APOLLO|Optimizer ya hali ya juu|2025-Q1
Liger Kernel|Uharakishaji wa kernel za Triton|2025
Mafunzo ya FP8|Usaidizi wa Transformer Engine|2025
4.4 Kiolesura cha Wavuti cha LLaMA Board
Kiolesura cha kuona kisichohitaji kuandika msimbo, kilichojengwa kwa Gradio
Chagua modeli → Sanidi seti ya data → Weka vigezo vya fine-tuning → Anzisha mafunzo kwa mbofyo mmoja
Ufuatiliaji wa wakati halisi: mkondo wa Loss, matumizi ya GPU, maendeleo ya mafunzo
Inaauni kumbukumbu za nyuma za TensorBoard, Wandb, MLflow na SwanLab
Kiolesura cha Chat cha inference kilichojengwa ndani; unaweza kujaribu mara tu baada ya mafunzo
4.5 Mbinu za Usambazaji
# Fine-tuning kupitia CLI (amri ya mstari mmoja)
llamafactory-cli train examples/train_lora/qwen3_lora_sft.yaml

# Kiolesura cha Wavuti
llamafactory-cli webui

# Usambazaji wa API yenye mtindo wa OpenAI
API_PORT=8000 llamafactory-cli api examples/inference/qwen3.yaml

# Docker
docker run -it --rm --gpus=all hiyouga/llamafactory:latest
Tano. Mahitaji ya Vifaa (Makadirio ya Kumbukumbu ya GPU)
Mbinu|Usahihi|7B|14B|30B|70B
Full (bf16)|32-bit|120GB|240GB|600GB|1200GB
Full (pure_bf16)|16-bit|60GB|120GB|300GB|600GB
Freeze/LoRA|16-bit|16GB|32GB|64GB|160GB
QLoRA|8-bit|10GB|20GB|40GB|80GB
QLoRA|4-bit|6GB|12GB|24GB|48GB
QLoRA|2-bit|4GB|8GB|16GB|24GB
Quantization ya QLoRA 4‑bit inaweza kutumika kufanyia fine-tuning modeli yenye vigezo 14 B kwenye RTX 3060 moja (12 GB ya kumbukumbu ya GPU), na modeli yenye vigezo 30 B kwenye RTX 4090 moja (24 GB ya kumbukumbu ya GPU).
Sita. Mageuzi ya Matoleo
Toleo|Tarehe|Mabadiliko muhimu
v0.1.0|2023-03|Toleo la awali, linalounga mkono fine-tuning ya LLaMA
Marudio ya awali|2023|SFT + LoRA/QLoRA, DPO, Kiolesura cha Wavuti, FlashAttention-2, Unsloth
Marudio ya awali|2024 Q1-Q3|DoRA, GaLore, BAdam, FSDP+QLoRA, vLLM, LLaVA ya aina nyingi, uchapishaji wa makala ya utafiti
v0.9.1|2025 Q1|Llama 3.2 Vision, LLaVA-NeXT, Pixtral, Video-LLaVA
v0.9.2|2025 Q1|MiniCPM-o, SwanLab, optimizer ya APOLLO
v0.9.3|2025 Q2|Llama 4, Gemma 3, Qwen3, InternVL3, Qwen2.5-Omni
v0.9.4|2025-12|🔄 Jina la hifadhi lilibadilishwa kuwa LlamaFactory, Python 3.9-3.10 ikaacha kutumika
v0.9.5|2026-05-30|Uoanifu na Qwen3.5/3.6, Gemma 4, Transformers v5
v1.x (ya majaribio)|2026|Usanifu mpya trainers → core → accelerator, uandishi upya wa kimoduli
Ufafanuzi wa Hatua Muhimu
Uchapishaji wa makala ya ACL 2024 —— Uthibitisho wa kitaaluma uliwezesha Stars kupanda kutoka 10,000 hadi zaidi ya 30,000
Nusu ya pili ya 2024 —— Usaidizi wa modeli za aina nyingi (LLaVA/Video/sauti) ulifungua soko jipya
Mwaka wa 2025 —— Iliendelea kutoa masasisho ya kila mwezi, ikaunga mkono Qwen3/DeepSeek/Llama4, na kuwa chaguo la kwanza katika jumuiya ya chanzo huria ya China
Mabadiliko ya jina la hifadhi —— LLaMA-Factory → LlamaFactory, kuondoa utegemezi wa chapa ya Meta
Usanifu wa majaribio wa v1 —— Unadokeza kuwa uandishi upya mkubwa uko karibu
Nane. Mfumo wa Ikolojia wa Jumuiya
7.1 Matrix ya Ikolojia ya Mradi
Mradi|Maelezo|Stars
LlamaFactory|Mfumo mkuu wa fine-tuning|72K+
EasyR1|Ujifunzaji wa kuimarisha wa VLM (GRPO/DAPO/Reinforce++)|Unaochipuka
FastEdit|Uhariri bora wa ukweli wa modeli|Umehifadhiwa
llamafactory-community|Kituo cha mawasiliano ya jumuiya|-
Easy Dataset|Zana ya kutengeneza data sintetiki|Mhusika wa tatu
DataFlow|Bomba la kuchakata data|Mhusika wa tatu
7.2 Umaarufu wa Jumuiya
Jumuiya ya AI ya China: CSDN, Zhihu na Bokee zina mamia ya mafunzo na uzoefu wa utekelezaji
Matumizi ya kibiashara: Alibaba Cloud, Huawei Ascend, Amazon AWS na NVIDIA zinapendekeza rasmi
Mazingira ya elimu: Imetumiwa na Chuo Kikuu cha Fudan na vyuo vingine vingi kama zana ya kufundishia kozi za modeli kubwa
Uoanifu wa Kichina: Inaunga mkono moja kwa moja ModelScope (jumuiya ya Modeng) na upakuaji wa vioo vya OpenMind Hub
LLaMA Factory Online: Iliwahi kutoa huduma ya jukwaa la mtandaoni, lilifungwa 2026-06-20
7.3 Ulinganisho na Washindani
Mfumo|Stars|Sifa kuu|Usaidizi wa modeli|Urahisi wa matumizi
LlamaFactory|72K|GUI/CLI ya kila kitu, uthibitisho wa makala ya ACL|100+|⭐⭐⭐⭐⭐
HuggingFace TRL|12K|Mlolongo rasmi wa zana za HF, uliounganishwa kwa kina na ikolojia|Modeli zote za HF|⭐⭐⭐
Axolotl|8K|Unaoendeshwa na YAML, ubinafsishaji kwa watumiaji wa juu|Modeli kuu|⭐⭐⭐
Unsloth|20K+|Uboreshaji wa juu kabisa wa utendaji (kuongeza kasi mara 2-5)|LLaMA/Mistral na nyinginezo|⭐⭐⭐⭐
Firefly|5K|Uboreshaji wa modeli kubwa za Kichina|Hasa modeli za Kichina|⭐⭐⭐
LLaMA-Adapter|6K|Unaolenga utafiti wa kitaaluma|Mfululizo wa LLaMA|⭐⭐
Faida Kuu za LlamaFactory:
Mfumo pekee unaochanganya makala ya ACL + Stars 70,000 + mifano ya matumizi ya kibiashara + GUI isiyohitaji msimbo
Una wigo mpana zaidi wa modeli (kutoka GPT-2 hadi Llama 4, na kutoka maandishi tupu hadi modeli za aina nyingi)
Ikolojia imara zaidi ya jumuiya ya China (kioo cha HuggingFace + muunganisho wa ModelScope)
Tisa. Uchambuzi wa SWOT
8.1 Nguvu (Strengths)
Nguvu|Maelezo
🔬 Mamlaka ya kitaaluma|Makala ya ACL 2024, ilipata zaidi ya marejeo 500 ya kitaaluma
🎯 Kizingiti cha chini sana|Fine-tuning kwa amri ya mstari mmoja, uendeshaji wa GUI bila msimbo
🌐 Wigo mpana zaidi wa modeli|Modeli 100+, mfululizo 60+, maandishi/maono/video/sauti
🇨🇳 Ikolojia ya jumuiya ya China|Vioo vya ModelScope/OpenMind, mafunzo mengi ya Kichina
🔧 Mlolongo wa zana wa kiwango cha viwandani|Docker/usambazaji uliosambazwa/API vyote vinapatikana
💾 Uboreshaji wa juu kabisa wa kumbukumbu ya GPU|QLoRA 4-bit inaweza kuendesha 70B kwenye GPU ya kiwango cha watumiaji
8.2 Udhaifu (Weaknesses)
Udhaifu|Maelezo
👤 Utegemezi mkubwa kwa mtu mmoja|hiyouga anachangia 72% ya commit (2,188/3,042), Bus Factor = 1
📚 Nyaraka zimetawanyika|README ni ndefu sana (68KB), na taarifa zimegawanyika kati ya Wiki/ReadTheDocs/makala za jumuiya
🐛 Mkusanyiko wa Issue|Kuna Open Issues 57 pekee, lakini kiwango cha majadiliano katika sehemu ya Issue ni kikubwa
🏗️ Mgawanyiko wa njia mbili wa v0/v1|Gharama kubwa ya kudumisha usanifu miwili, v1 haijatulia kwa muda mrefu
📦 Utegemezi changamano wa vifurushi|Matrix ya matoleo ya CUDA/PyTorch/FlashAttn hukosewa kwa urahisi sana
🔒 Sifa ya mradi wa kitaaluma|Haina timu ya uendeshaji ya muda wote, hivyo uendelevu wa muda mrefu unatiliwa shaka
8.3 Fursa (Opportunities)
Fursa|Maelezo
🚀 Mazingira ya fine-tuning ya Agent|Mahitaji ya fine-tuning ya Function Calling / Tool Use yanaongezeka kwa kasi
🎥 Upanuzi wa modeli za aina nyingi|Soko jipya la fine-tuning ya modeli za Video/Audio/3D
☁️ SaaS ya asili ya wingu|Ingawa LLaMA Factory Online ilifungwa, mahitaji ya upangishaji wa kiwango cha biashara bado yapo
🏢 Soko la mafunzo ya biashara|Kozi za mafunzo ya fine-tuning ya modeli kubwa na mifumo ya uidhinishaji
🔗 Muunganisho wa MCP|Backend ya fine-tuning kama miundombinu ya AI Agent
8.4 Vitisho (Threats)
Vitisho|Maelezo
🏢 Mifumo ya ndani ya makampuni makubwa|Alibaba PAI na Huawei ModelArts zinatoa suluhisho zilizounganishwa
🔄 Ushindani kutoka kwa HF rasmi|Ikolojia ya HuggingFace TRL/peft inaendelea kukamilika
📉 Kupungua kwa mahitaji ya fine-tuning|Prompt Engineering + RAG vinachukua nafasi ya baadhi ya matumizi ya fine-tuning
👨🎓 Kuhitimu kwa mwanzilishi|Baada ya Dkt. Zheng Yaowei kuhitimu, kiwango cha udumishaji wa mradi kinaweza kupungua
Kumi. Tathmini ya Hatari
Aina ya hatari|Kiwango cha hatari|Maelezo
Bus Factor|🔴 Hatari kubwa|Msanidi mkuu mmoja anawajibika kwa 72% ya michango; akiondoka, hatari ya mradi kusimama ni kubwa sana
Deni la kiufundi|🟡 Hatari ya wastani|Miundo miwili ya v0/v1, README ya 68KB, na nyaraka zilizotawanyika
Mnyororo wa utegemezi|🟡 Hatari ya wastani|Gharama kubwa ya kudumisha matriki ya matoleo ya CUDA/PyTorch/FlashAttn
Utafutaji wa kibiashara|🟢 Hatari ndogo|Leseni ya Apache-2.0, bila vikwazo vya kibiashara
Afya ya jumuiya|🟢 Nzuri|Stars 72,000, jumuiya hai ya kimataifa, na matumizi mapana na makampuni
Kumi, Mambo Muhimu ya Kiufundi na Ubunifu
10.1 Muundo wa "barabara kuu ya kasi iliyosanifishwa"
Katika urekebishaji wa kawaida, kila modeli huhitaji kuwekewa ulinganifu kivyake. LLaMA Factory hutumia mfumo wa kusajili templeti pamoja na teknolojia ya monkey‑patch, hivyo kupunguza kwa kiasi kikubwa gharama ya ulinganifu.
# Kuongeza modeli mpya kunahitaji hatua 3 tu:
# 1. Sajili templeti ya Prompt katika kamusi ya TEMPLATES kwenye template.py
# 2. Ongeza kiraka cha ulinganifu wa modeli kwenye patcher.py (ikihitajika)
# 3. Ongeza usaidizi wa multimodality kwenye mm_plugin.py (ikihitajika)
10.2 Mfumo wa usanidi wa vigezo wa tabaka nne
Faili ya usanidi ya YAML/JSON
  → parser.py huichanganua
    → ModelArguments (uchaguzi wa modeli, quantization)
    → DataArguments (seti ya data, templeti, uchakataji wa awali)
    → FinetuningArguments (LoRA rank/target, mbinu ya mafunzo)
    → TrainingArguments (hurithi HF, distributed/logging/checkpoint)
10.3 Usanifishaji wa bomba la data
Chombo hiki kinaunga mkono miundo miwili maarufu ya data, Alpaca na ShareGPT, kinaweza kubadilisha kiotomatiki zaidi ya seti 50 za data zilizowekwa tayari, na kinaoana na miundo ya faili ya JSON, JSONL, CSV, Parquet na Arrow.
10.4 Usaidizi wa quantization wa hatua kwa hatua
Kinaunga mkono viwango sita vya usahihi, kuanzia usahihi kamili wa biti 16 hadi QLoRA ya biti 2, na kinaweza kutumika katika mazingira tofauti ya maunzi, kuanzia makundi ya seva za A100 hadi kompyuta mpakato za kawaida.
Kumi na Moja, Matriki ya Ulinganisho wa Washindani
Kipengele|LlamaFactory|HuggingFace TRL|Unsloth|Axolotl
Stars|72K|12K|20K+|8K
Usaidizi wa modeli|Mfululizo 100+|HF yote|LLaMA/Qwen/Mistral|Mfululizo maarufu
GUI|✅ LLaMA Board|❌|❌|❌
Bila msimbo|✅ CLI + YAML|❌ Inahitaji kuandika msimbo|❌ Inahitaji kuandika msimbo|YAML pekee
Mbinu za mafunzo|8|4 (SFT/DPO/PPO/GRPO)|3|5
Uwezo wa quantization|Biti 2-16|Biti 4-16|Biti 4-16|Biti 4-16
Multimodality|✅ Picha/video/sauti|❌|❌|❌
Ekolojia ya Kichina|✅ ModelScope + 魔搭|⚠️ Inahitaji VPN|⚠️ Inahitaji VPN|❌
Makala ya kitaaluma|ACL 2024|-|-|-
Injini ya uelekezaji|vLLM/SGLang/HF|HF pekee|HF pekee|vLLM/HF
Mwinuko wa kujifunza|Chini sana|Wastani|Chini|Wastani hadi juu
Kumi na Mbili, Mambo Muhimu ya Utekelezaji
12.1 Kuanza haraka (hatua 3)
# Hatua ya 1: Sakinisha
git clone --depth 1 github.com/hiyouga/LlamaFactory.git
cd LlamaFactory
pip install -e ".[torch,metrics]"

# Hatua ya 2: Anzisha Web UI
llamafactory-cli webui

# Hatua ya 3: Fungua localhost:7860 katika kivinjari, chagua modeli → seti ya data → anza mafunzo!
12.2 Mapendekezo ya mazingira ya uzalishaji
# Utekelezaji wa Docker (unapendekezwa)
docker run -it --rm --gpus=all \
    -v ./hf_cache:/root/.cache/huggingface \
    -v ./data:/app/shared_data \
    -v ./output:/app/output \
    -p 7860:7860 -p 8000:8000 \
    hiyouga/llamafactory:latest

# Utekelezaji wa API (unaooana na OpenAI)
API_PORT=8000 llamafactory-cli api \
    examples/inference/qwen3.yaml \
    infer_backend=vllm
12.3 Mambo ya kuzingatia kwa watumiaji wa Windows
Inahitajika kusakinisha mwenyewe toleo la PyTorch GPU:
pip install torch torchvision torchaudio --index-url download.pytorch.org/whl/cu126QLoRA inahitaji kusakinisha toleo la bitsandbytes lililokusanywa tayari kwa Windows
FlashAttention-2 inahitaji kukusanywa mwenyewe kwenye Windows
Weka
dataloader_num_workers: 0ili kuepuka hitilafu za serialization
Kumi na Tatu, Mtazamo wa Baadaye
Kuimarishwa kwa muundo wa v1: Tawi la majaribio linatarajiwa kuwa muundo mkuu ifikapo 2026-2027, likiwa na kiwango cha juu zaidi cha modularity
Kukuza zaidi urekebishaji wa Agent: Urekebishaji wa Tool Use / Function Calling utakuwa kipengele cha kawaida
Urekebishaji wa modeli za uelekezaji (Reasoning): Distillation ya DeepSeek-R1 + urekebishaji wa GRPO (mradi wa EasyR1)
Ukaribishaji wa cloud-native: Baada ya LLaMA Factory Online kusitishwa, huenda kukatokea suluhisho za ukaribishaji kutoka wahusika wengine
Kuunganisha mafunzo ya multimodality: Urekebishaji wa maandishi/picha/video/sauti ndani ya mfumo mmoja
Kumi na Nne, Alama na Muhtasari
Kipengele|Alama|Tathmini
Muundo wa kiufundi|9.5/10|Muundo wa modularity, mageuzi ya miundo miwili, na matriki pana ya injini
Ukamilifu wa vipengele|10/10|Mbinu 8 za mafunzo × mbinu 6 za urekebishaji × modeli 100+
Urahisi wa matumizi|10/10|Urekebishaji kwa amri ya mstari mmoja + Web UI bila msimbo, bora zaidi katika sekta
Ubora wa nyaraka|7.5/10|README ina maelezo mengi lakini ni ndefu kupita kiasi na imegawanyika sana
Uhai wa jumuiya|9.5/10|Stars 72K na umaarufu wa kiwango cha kipekee katika jumuiya ya China
Utayari wa uzalishaji|9.0/10|Docker/API/distributed zimekamilika, na imethibitishwa kwa kina na makampuni
Uendelevu|6.5/10|Bus Factor=1, sifa ya mradi wa kitaaluma, na mashaka kuhusu muda mrefu
Ubunifu|8.5/10|Makala ya ACL, mfumo wa kusajili templeti, na mfumo wa vigezo wa tabaka nne
Alama ya jumla: 9.
Muhtasari wa sentensi moja
LLaMA Factory ni mfumo wa chanzo huria wa kurekebisha modeli kubwa za lugha, uliotekelezwa kwa msingi wa makala ya ACL 2024 na kupata takriban stars 72,000 za kutambuliwa na jumuiya kwenye GitHub. Mfumo huu hufuata dhana ya muundo ya "kutenganisha algoriti, modeli na data", na hutoa kiolesura cha mstari wa amri (CLI) pamoja na Web UI bila msimbo. Unaunga mkono urekebishaji wa zaidi ya modeli 100, hivyo kupunguza kwa kiasi kikubwa kizingiti cha kiufundi cha urekebishaji wa modeli kubwa za lugha. Unaweza kutumika kama miundombinu ya kutekeleza matumizi ya modeli kubwa za lugha.