

DeepSelect ni Nini?
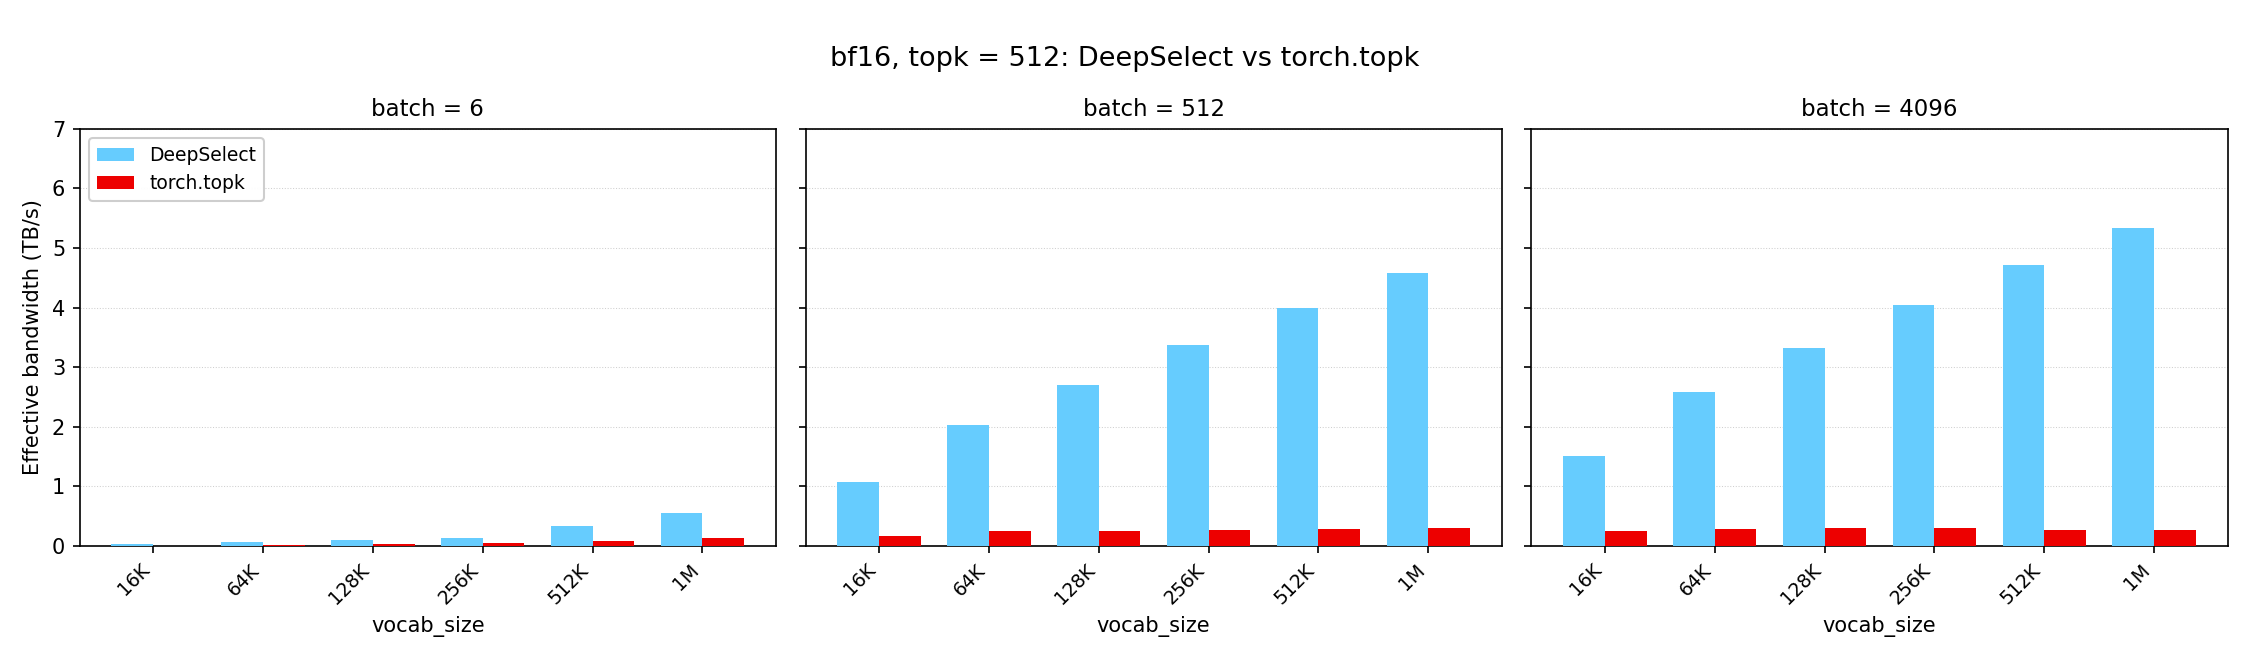
DeepSelect ni utekelezaji wa utendaji wa juu wa kernel ya TopK inayotumika katika DeepSeek Sparse Attention na sampuli. Kulingana na README ya mradi, inaweza kutoa kasi iliyo juu mara 2–20 ikilinganishwa na torch.topk ya kawaida kwa mizigo ya kazi inayoungwa mkono na maktaba.
Badala ya kujaribu kuboresha kila usanidi unaowezekana wa TopK, DeepSelect inalenga hali mbili: mzigo wa kazi wa Lightning Indexer unaotumia ingizo za torch.bfloat16 na mzigo wa kazi wa sampuli unaotumia ingizo za torch.float32.
Mizigo ya Kazi Inayoungwa Mkono
Hali ya Lightning Indexer
- Aina ya ingizo:
torch.bfloat16 - Ukubwa wa kundi: kuanzia 1 na kuendelea, ikiwa na uboreshaji kwa makundi madogo na makubwa
- Ukubwa wa msamiati: kuanzia 1 na kuendelea, ikiwa na uboreshaji kwa misamiati midogo na mikubwa
- Ukubwa wa TopK: mdogo na usiozidi
4096
Kwa utendaji bora, acha sorted_index ikiwa imezimwa isipokuwa matokeo yahitaji kupangwa. Ikiwa thamani hazihitajiki, weka return_value=False ili kuruka utoaji wake.
Hali ya sampuli
- Aina ya ingizo:
torch.float32 - Ukubwa wa kundi: kuanzia 1 na kuendelea
- Ukubwa wa msamiati: takriban 128K
- Ukubwa wa TopK: mdogo na usiozidi
4096
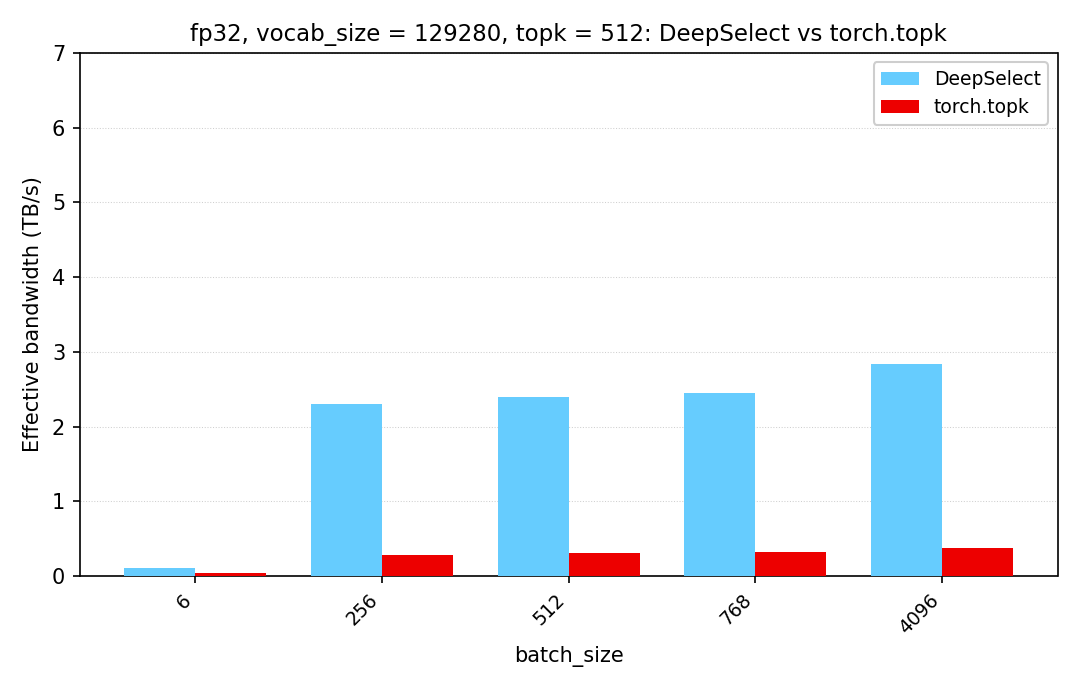
Hifadhi ya msimbo hupima utendaji kwa kutumia kipimo cha ufanisi wa kipimo data cha kumbukumbu badala ya upitishaji wa hesabu za nukta zinazoelea, kwa sababu TopK haifanyi hesabu za nukta zinazoelea. Kipimo chake cha utendaji huripoti utendaji ukilinganishwa na torch.topk kwa ingizo lilelile.
Sifa Muhimu
- Kernel maalum za TopK kwa mizigo ya kazi ya DeepSeek Sparse Attention na sampuli
- Usaidizi wa ingizo za
torch.bfloat16natorch.float32katika hali zao husika zinazolengwa - Utoaji wa faharasa wa
torch.int32autorch.int64unaoweza kusanidiwa - Utoaji wa thamani wa hiari ili kupunguza gharama ya ziada wakati faharasa pekee zinahitajika
- Safu zenye urefu unaobadilika kupitia kikomo cha juu cha kipekee kwa kila safu
- Vihifadhi vya matokeo vya faharasa vinavyodhibitiwa na mtumiaji
- Ukaguzi wa NaN uliojengewa ndani
Usakinishaji
Nakili hifadhi ya msimbo, anzisha moduli zake ndogo, kisha sakinisha kifurushi kutoka kwenye saraka ya mradi:
git clone https://github.com/deepseek-ai/DeepSelect.git
cd DeepSelect
git submodule update --init --recursive
pip install -v .
Mifano hutumia tenzori za CUDA, kwa hiyo unda maingizo kwenye device="cuda".
Matumizi ya Msingi ya TopK
Leta PyTorch na DeepSelect, unda tenzori ya ingizo yenye vipimo viwili, kisha uite deep_select.topk:
import torch
import deep_select

batch_size = 4
vocab_size = 204800
topk = 1024

x = torch.randn(
    batch_size,
    vocab_size,
    dtype=torch.bfloat16,
    device="cuda",
)

values, indices = deep_select.topk(
    x,
    topk,
    sorted_index=True,
    indices_type=torch.int32,
    return_value=True,
)

print(values.shape)   # (4, 1024)
print(indices.shape)  # (4, 1024)
Ingizo lazima liwe na umbo la (batch_size, vocab_size). Kipimo chake cha mwisho lazima kiwe contiguous, na hatua ya safu lazima iwe kigawe cha deep_select.get_stride_requirement()[0] baiti.
Thamani zinazorudishwa zina aina ya data sawa na x. Faharasa hutumia aina iliyochaguliwa kupitia indices_type, ambayo inaweza kuwa torch.int32 au torch.int64. Kwa sorted_index=True, faharasa zinazorudishwa za kila safu hupangwa kwa mpangilio wa kupanda.
Kurejesha faharasa pekee
Ikiwa msimbo wa baadaye hauhitaji thamani zilizochaguliwa, zima utoaji wa thamani:
values, indices = deep_select.topk(
    x,
    topk,
    sorted_index=False,
    indices_type=torch.int32,
    return_value=False,
)
README inabainisha kuwa kuruka utoaji wa thamani kunaongeza kasi kwa takriban 10%. Epuka kuomba matokeo yaliyopangwa isipokuwa upangaji unahitajika, kwa sababu upangaji huongeza gharama ya ziada.
Kushughulikia Upangaji wa Hatua
DeepSelect inaweka mahitaji ya upangaji kwenye safu za ingizo na matokeo. Yakague wakati wa utekelezaji:
input_alignment, output_alignment = deep_select.get_stride_requirement()

print("Input row-stride alignment:", input_alignment, "bytes")
print("Output row-stride alignment:", output_alignment, "bytes")
Ikiwa hatua ya safu ya ingizo si kigawe cha upangaji wa ingizo unaohitajika, ongeza nafasi kwenye tenzori kabla ya kuipitisha kwa DeepSelect. Kipimo cha mwisho lazima kibaki contiguous.
Kwa chaguo-msingi, DeepSelect hutenga matokeo yote mawili. Hatua zake hupangwa kwa deep_select.get_stride_requirement()[1] baiti, hivyo tenzori zinazorudishwa zinaweza zisiwe contiguous. Msimbo unaotumia matokeo hayo haupaswi kudhani kuwa hatua zake ni za kawaida za contiguous.
Kutumia bafa iliyopo ya faharasa
API inakubali output_idx= wakati faharasa zinapaswa kuandikwa kwenye bafa inayodhibitiwa na mwitaji. Bafa hiyo lazima itimize hitaji lilelile la hatua ya matokeo. Tazama deep_select/interface.py kwa sahihi kamili ya chaguo la kukokotoa kabla ya kusanidi bafa maalum.
Kufanya Kazi na Safu Zenye Urefu Unaobadilika
Tumia end kuipa kila safu kikomo cha juu kisichojumuishwa. Hii ni muhimu wakati safu katika kundi moja zina urefu tofauti unaotumika:
import torch
import deep_select

batch_size = 2
vocab_size = 129280

x = torch.randn(
    batch_size,
    vocab_size,
    dtype=torch.float32,
    device="cuda",
)

end = torch.tensor(
    [129280, 100000],
    dtype=torch.int32,
    device="cuda",
)

values, indices = deep_select.topk(
    x,
    1000,
    end=end,
    sorted=True,
    indices_type=torch.int64,
)
Hapa, safu ya kwanza inaweza kutumia vipengele vyote 129280, huku safu ya pili ikiwa na kikomo cha vipengele 100000 vya kwanza. Ikiwa safu ni fupi kuliko ukubwa wa TopK ulioombwa, DeepSelect hujaza matokeo yake kwa value_oob_fill_value na idx_oob_fill_value.
Ushughulikiaji wa NaN
Ukaguzi wa NaN huwashwa kila wakati. Kwa chaguo-msingi, abort_when_nan_found=True, hivyo kernel huendesha trap() na kusitisha inapogundua NaN. Safu ambazo urefu wake halali ni mdogo kuliko au sawa na ukubwa wa TopK ulioombwa hazikaguliwi kwa NaN.
Thibitisha au safisha data ya ingizo kabla ya kuanzisha kernel ikiwa NaN zinawezekana, hasa unapohifadhi tabia chaguo-msingi ya kusitisha.
Utendaji na Vidokezo vya Kina
- Usivuke kiwango cha TopK kinachotumika. DeepSelect inasaidia thamani ndogo za TopK hadi na kujumuisha
4096. Thamani kubwa zaidi hazitumiki. - Linganishia mzigo unaokusudiwa. Tumia
torch.bfloat16kwa hali ya Lightning Indexer natorch.float32kwa hali ya sampling iliyoelezwa na mradi. - Epuka kupanga inapowezekana. Kupanga kwa faharasa au thamani hugharimu utendaji, kwa hiyo iombe tu uchakataji wa baadaye unapohitaji.
- Epuka thamani inapowezekana. Weka
return_value=Falsewakati ni faharasa pekee zinazotumika. - Angalia mpangilio mapema. Panga maumbo ya tenzori na padding kuzunguka
get_stride_requirement()badala ya kurekebisha tenzori zisizolingana katika kitanzi muhimu kwa utendaji. - Usidhani kuwa matokeo yanafuatana kwenye kumbukumbu. DeepSelect hupanga stride za safu za matokeo, na tenzori zinazotokana zinaweza zisiwe contiguous.
- Pima umbo halisi. Utendaji wa TopK hutegemea aina ya ingizo, ukubwa wa kundi, ukubwa wa msamiati, na ukubwa wa TopK. Jaribu usanidi halisi unaotumiwa na programu.
Kuendesha kipimo kilichotolewa
Hazina inajumuisha hali ya utendaji katika skripti yake ya majaribio:
python3 tests/test.py --perf-onlyKipimo hiki kinalinganisha DeepSelect na torch.topk kwa ingizo zilezile na kuripoti uwiano kwa kutumia kipimo cha kipimo-bendi cha kumbukumbu kinachofaa.
Hitimisho
DeepSelect hutoa kernel maalum za TopK kwa mizigo ya DeepSeek Sparse Attention na sampling inayooana. Anza na tenzori ya CUDA yenye vipimo viwili iliyopangwa, weka topk kuwa 4096 au chini, na zima upangaji au utoaji wa thamani usipohitajika. Kwa ujumuishaji wa uzalishaji, thibitisha mahitaji ya stride, zingatia kuwa matokeo yanaweza yasiwe contiguous, na pima maumbo halisi ya tenzori yanayotumiwa na programu yako.