
- 月流量
- 0
- 产品收费
- 未设置
- 收录时间
- —
- 更新时间
- 2026-11-03
01MOSS-Live是什么
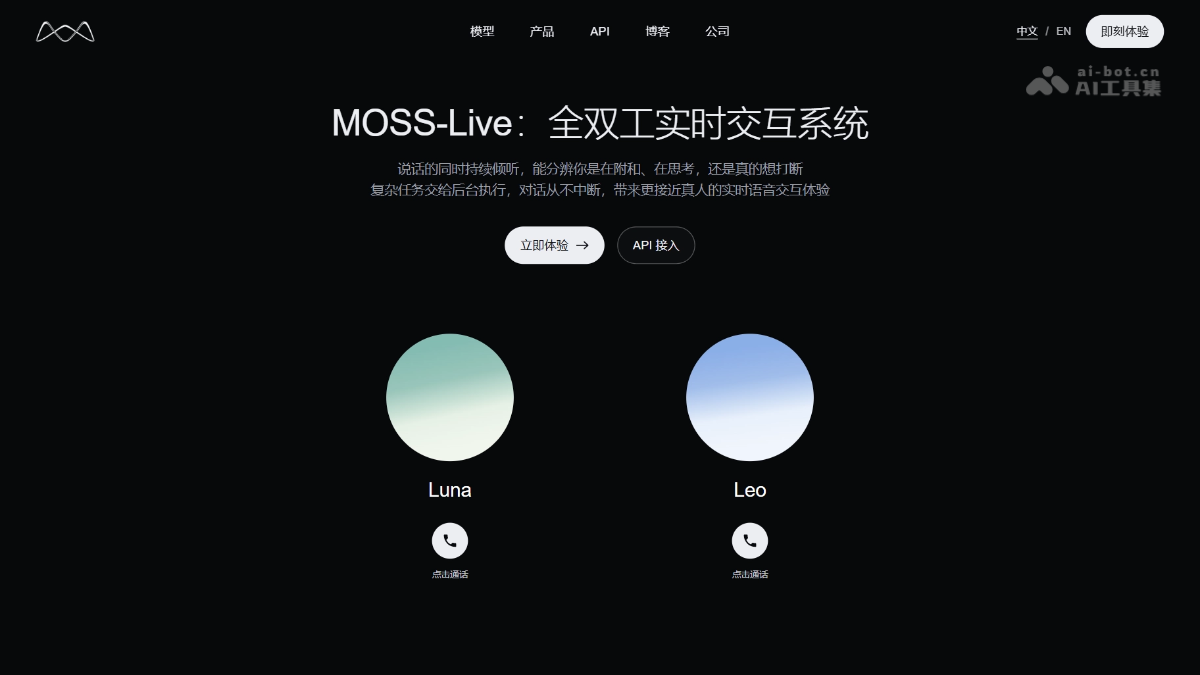
MOSS-Live是模思智能推出的全双工实时交互系统。MOSS-Live让AI像真人一样边听边说,语义级判断何时回应、等待或接受打断,不被附和声和环境音误触发;支持视频通话、屏幕共享与环境声理解;采用前后台协同架构,对话不被打断即可异步完成查资料、做规划等复杂任务,任务完成后主动反馈结果。MOSS-Live基准多项指标领先GPT Realtime等竞品,API限时免费开放。
02MOSS-Live的主要功能
全双工对话:边听边说,语义级判断回应、等待、接受打断或保持沉默的时机。
语义打断:区分附和与主动打断,不被”嗯”等简短回应中断,被明确打断时及时响应。
语义判停:基于语义理解判断用户是否说完,句中停顿或思考时主动等待,不抢话。
无关声音拒识:能分辨哪些话是对它说的,不被旁人闲聊、自言自语、设备播放声误触发。
自然附和:根据对话内容与节奏,在恰当时机主动给予简短回应。
断点续说与记忆:多次打断、切换话题后,仍记得被打断的位置与上下文,可自然接续。
主动交互:按用户预设条件持续关注对话,满足条件时主动介入。
边聊边做事:调用工具异步执行查询、规划等任务,对话不中断,任务完成后主动反馈结果。
边听边译:流式同声传译,用接近真人同传的低延迟持续输出译文。
多模态感知:支持视频通话、屏幕共享,能理解环境声音与说话者音色,融合视觉、语音与环境信息交互。
03MOSS-Live的技术原理
前后台协同架构:MOSS-Live 将实时交互与复杂任务解耦,由不同模型分工:前台交互模型持续接收语音、画面与环境声音,理解对话状态并决定倾听、回应或等待的时机;后台模型承接需要深度推理与长程执行的任务。两者通过共享的记忆、上下文和任务状态保持协同,前台掌握后台任务进展,待任务完成后在合适时机把结果带回对话,使用户无需等待即可继续交流。
语义级全双工控制:MOSS-Live 在持续倾听过程中实时理解语义、说话意图与对话状态,动态判断何时回应、何时等待、何时接受打断、何时保持沉默,实现真正自然的并行听说。
持续多模态感知:系统持续融合三路信息源:语音流、视频画面与声学环境。交互决策基于多模态信息的综合理解,例如结合实时画面识别用户所指物体,或识别导航播报等无关声音并拒绝响应。
04如何使用MOSS-Live
官网在线体验:访问模思智能官网 https://www.moss.cn,点击”体验 MOSS Live”入口,注册登录后授权麦克风/摄像头,可选择声音开始全双工语音对话。
API 接入:访问 https://platform.moss.cn 注册开发者账号,创建应用获取密钥并按官方文档集成全双工接口,可把 MOSS-Live 嵌入自己的产品。
05MOSS-Live的核心优势
节奏控制业界领先:停顿抢话率仅 1.44%,远低于 GPT Realtime 2.1和 Doubao SeedDuplex,等待与接话时机最自然。
无关声音拒识极强:无关语音误接话率仅 2%,而参评竞品高达 68%–88%,不会被旁人闲聊、设备播放声误触发。
打断处理质量最高:FDB v1 打断后回答质量 4.88/5 分,不被附和声中断,能在用户真正打断时及时响应并接续上下文。
对话与任务并行:前后台协同架构让复杂任务在后台异步执行,对话不被阻塞,完成后主动反馈结果。
多模态实时感知:同时融合语音、视频画面、屏幕共享与环境声音,实现”边看、边听、边聊”的全模态交互。
断点续说能力强:多次打断、频繁切换话题后仍能记住发言位置与上下文,自然接续之前的内容。
支持流式同传:可边听边译,以接近真人同声传译的低延迟持续输出译文,适用跨语言交流场景。
06MOSS-Live的项目地址
项目官网:https://www.moss.cn/products/moss-live
07MOSS-Live的应用场景
AI 会议参会:作为虚拟参会者实时跟进讨论,被打断后接续上下文,会后自动整理结论与待办。
车载语音助理:开车途中规划行程、查船票酒店,抗导航播报干扰,多次打断后仍能从断点续说路线。
随身旅行向导:视频识别眼前建筑并讲解历史,随时打断查房价、餐厅,讲解随游客兴趣自然展开。
跨语言同声传译:国际会议或跨语言交流中边听边译,用接近真人同传的低延迟持续输出译文。
学习陪练与提醒:背诵时实时纠错、会议中盯守重要事项,满足预设条件时主动介入提醒。
© 免责声明:鉴于域名具有时效性,指向的网站内容可能发生变更。AIEZZ对呈现的第三方网站不可控,无法承担任何责任。请自行判断内容风险。
用户评价0