
- 月流量
- 0
- 产品收费
- 未设置
- 收录时间
- —
- 更新时间
- 2026-11-04
01EvaOmni是什么
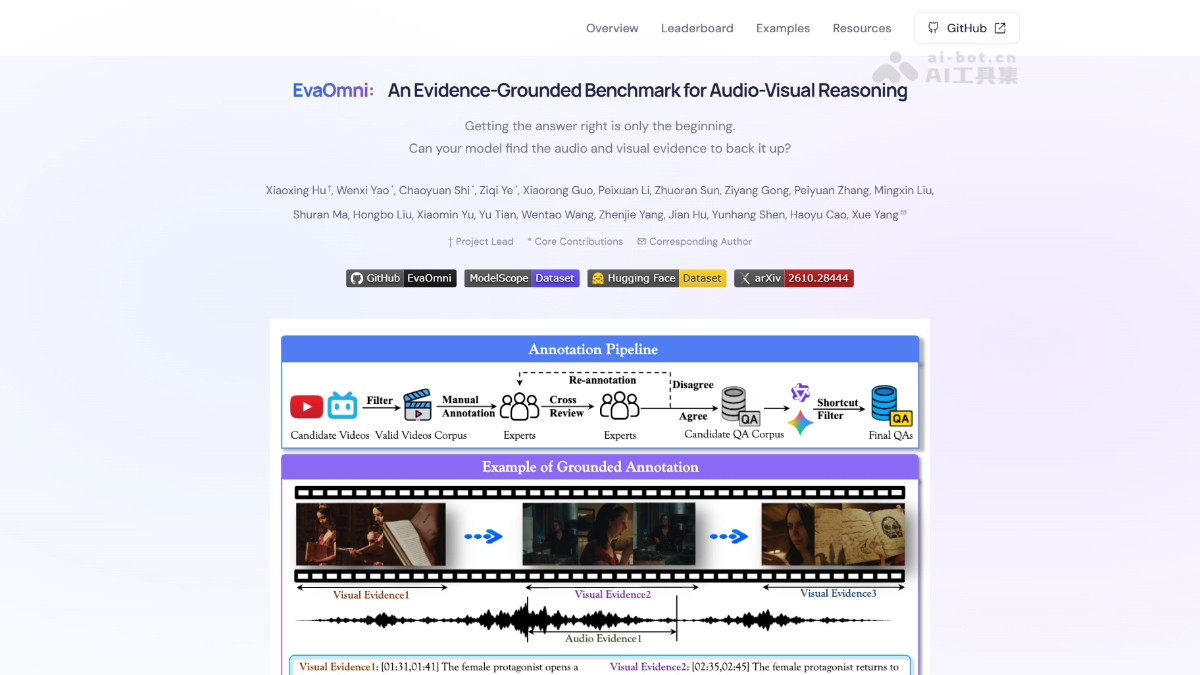
EvaOmni 是上海交大、复旦、腾讯优图等开源的全模态大模型评测基准,含 392 段真实视频、1,027 道人工标注问答,覆盖 15 种能力、3 个推理层级。EvaOmni需同时给出答案及音频、视频证据时间区间,按答案准确率、证据覆盖、双模态定位三项指标评分。EvaOmni实测 24 个模型中最强的 Gemini3.7-Flash 准确率 79.4%,双模态定位仅 35.1%,与人类专家的 94.3% 相差 59.2 个百分点,暴露出答对但说不出依据的短板。
02EvaOmni的主要功能
答案评测:判断模型在视听选择题上的回答是否正确,给出准确率 Acc.。
证据标注与返回:每道题人工标注支持答案的音频与视频时间区间,模型需随答案一同返回双模态证据区间。
证据覆盖评分(C.G.):统计人工标注证据段被模型预测区间命中的比例,衡量模型找齐了多少支持线索。
双模态瓶颈定位(B.G.):分别对音频、视频计算时序 IoU 并取较弱模态定分,要求两种模态同时定位准确。
三级能力分层:按检索定位、基础理解、复杂推理划分任务,检验模型从单点对齐到多跳推理的能力跨度。
捷径过滤:通过文本、音频、视觉单模态输入筛查题目,剔除仅靠单一模态或文字常识就能答对的样本。
模型横向评测:提供 24 个全模态模型的统一基准与排行榜,支持开放权重与专有模型对比选型。
03EvaOmni的技术原理
微信关注回复“开源”,加入AI开源项目交流群
证据感知的标注数据结构:EvaOmni 对每道题同时标注音频证据区间和视频证据区间,并配一个基于视频内容设计的干扰选项集。模型输出因此被定义为三元组,选项、音频时间戳集合、视频时间戳集合,评测程序可分别核对答案正确性与证据定位质量。
四阶段数据构建流水线:数据生产经过视频筛选、人工标注、交叉审核、捷径过滤四个阶段:先排除含硬编码字幕或大面积文字覆盖的视频,保证视听线索真实有效;由专家编写题目、设计与视频内容绑定的干扰选项,标注两种模态的证据区间;由其他标注者交叉审核能力归属、证据质量与捷径问题,存在争议的样本交由两名额外专家独立复核;让模型在仅文本、仅音频、仅视觉三种单模态输入下分别作答,凡能被单模态答对的题目一律返修重标,从数据层面阻断”绕过视听联合推理”的捷径。
覆盖—定位双指标评分体系:证据覆盖分 C.G. 统计每条人工标注证据段是否与任一预测区间存在正时长重叠,衡量找没找到;瓶颈定位分 B.G. 在每种模态内将全部预测区间与标注区间分别取并集,按时序交并比 IoU 计算重合程度,且最终得分取音频、视频两个 IoU 中较弱的一方。两项指标均乘以答案正确性得分,答错即记零分;这一设计使宽泛预测只能拿覆盖分,精确边界才能贡献定位分,同时用”短板模态”定分,杜绝用强模态弥补弱模态的行为。
三级能力分层设计:数据集按推理与证据复杂度组织为三个层级:Level 1 检索与定位考查时间、事件、实体在音视频间的对齐;Level 2 基础理解要求融合互补的视听线索理解事件、情绪与意图;Level 3 复杂推理要求整合分散在不同时间点的多条证据完成多跳判断。层级越高,单题证据数量和覆盖时长显著增加,由此把模型在检索、理解和长程多步推理中的能力短板定位到具体层级。
04如何使用EvaOmni
安装 ModelScope 客户端:执行 pip install -U modelscope 安装或升级模型Scope SDK。
下载数据集:使用 dataset_snapshot_download 指定数据集 ID VisionXLab/EvaOmni-Dataset 将数据拉取到本地目录。
准备模型输入:按评测协议预处理视频并配套音频内容。
接入待评模型:按 GitHub 仓库的说明接入你的全模态模型,用统一提示词让模型输出选项、音频时间戳、视频时间戳三元组。
运行评测:调用评测框架在全部 1,027 道问答上批量推理,由程序自动核对答案与区间匹配。
查看结果:读取 Acc.、C.G.、B.G. 三项指标及三级能力分层成绩,与排行榜对比定位模型短板。
05EvaOmni的核心优势
证据定位纳入评分:要求模型返回音频与视频证据时间区间,让猜对和有据可依区分开。
双指标量化证据质量:证据覆盖分 C.G. 衡量找没找齐线索,瓶颈定位分 B.G. 按时序 IoU 取较弱模态定分,杜绝用强模态掩盖弱模态。
三级能力分层精细:从检索定位、基础理解到复杂多跳推理逐级递进,能定位模型在不同推理深度上的具体短板。
人工标注质量高:经专家出题、交叉审核、争议样本双专家复核,数据可靠性优于自动构造的同类基准。
捷径过滤机制严格:用文本、音频、视觉三种单模态输入筛查题目,剔除绕过视听联合推理就能答对的样本,保证评测公平。
揭示真实能力鸿沟:实测显示最强模型的答案准确率与人类只差 17 个百分点,双模态定位却差 59.2 个百分点,暴露现有模型的真实短板。
06EvaOmni的项目地址
项目官网:https://xiaoxing2001.github.io/EvaOmni.github.io/
GitHub仓库:https://github.com/VisionXLab/EvaOmni
HuggingFace模型库:https://huggingface.co/datasets/VisionXLab/EvaOmni-Dataset
arXiv技术论文:https://arxiv.org/pdf/2610.28444
07EvaOmni的应用场景
全模态模型研发评测:模型团队在迭代 Omni LLM 时,用 Acc./C.G./B.G. 三项指标定位”答案提升但证据定位没跟上”的能力断层,指导训练改进方向。
企业级 AI 选型验收:金融、政务等需要模型”给出可核对依据”的场景,采购方可通过 B.G. 瓶颈定位分筛选真正双模态可靠的模型。
视频内容审核与溯源:审核类应用要求模型指出违规内容”在哪个画面、哪段声音”中出现,EvaOmni 的时间区间输出与定位指标可直接作为验收标准。
教育/影视内容的问答产品:带视频的学习助手、影视解说类产品需要引用原片片段作答,可用该基准评估模型能否准确定位到相关镜头与台词。
学术研究与榜单建设:研究者可基于开源的 392 段带证据标注视频开展视听推理、时间定位、多跳推理等方向的进一步研究,或将其纳入多基准联合评测体系。
© 免责声明:鉴于域名具有时效性,指向的网站内容可能发生变更。AIEZZ对呈现的第三方网站不可控,无法承担任何责任。请自行判断内容风险。
用户评价0