

什么是 DeepInfer-SM80?
DeepInfer-SM80 是一组经过优化的 Python、Triton 和 TileLang 模块,可通过 vLLM V1 引擎在 NVIDIA Ampere GPU 上运行 DeepSeek-V4.1。它移植了 DeepSeek 的 DeepInfer 中的核心理念。后者面向 NVIDIA Blackwell,而本项目则围绕 Ampere 硬件的能力重新设计了关键执行路径。
项目不依赖 Blackwell 专属特性,例如 tcgen05 warp-group 指令、Tensor Memory、硬件 UE8M0 scale 指令,以及每个流式多处理器 228 KB 的共享内存,而是使用 Ampere 的 mma.sync.aligned.m16n8k16 Tensor Core、感知 SM 的调度、基于整数位移的 UE8M0 解码,以及 YOCO 共享 KV 复用。
项目支持 A100 和 A800 等数据中心 SM80 GPU,也支持 RTX 3090、RTX 3090 Ti、RTX A6000、A40、A10 和 A30 等 SM86 设备。其内核每个 CTA 使用的共享内存不超过 48 KB,因此可以在 SM86 设备较低的共享内存限制下运行。
为什么使用它?
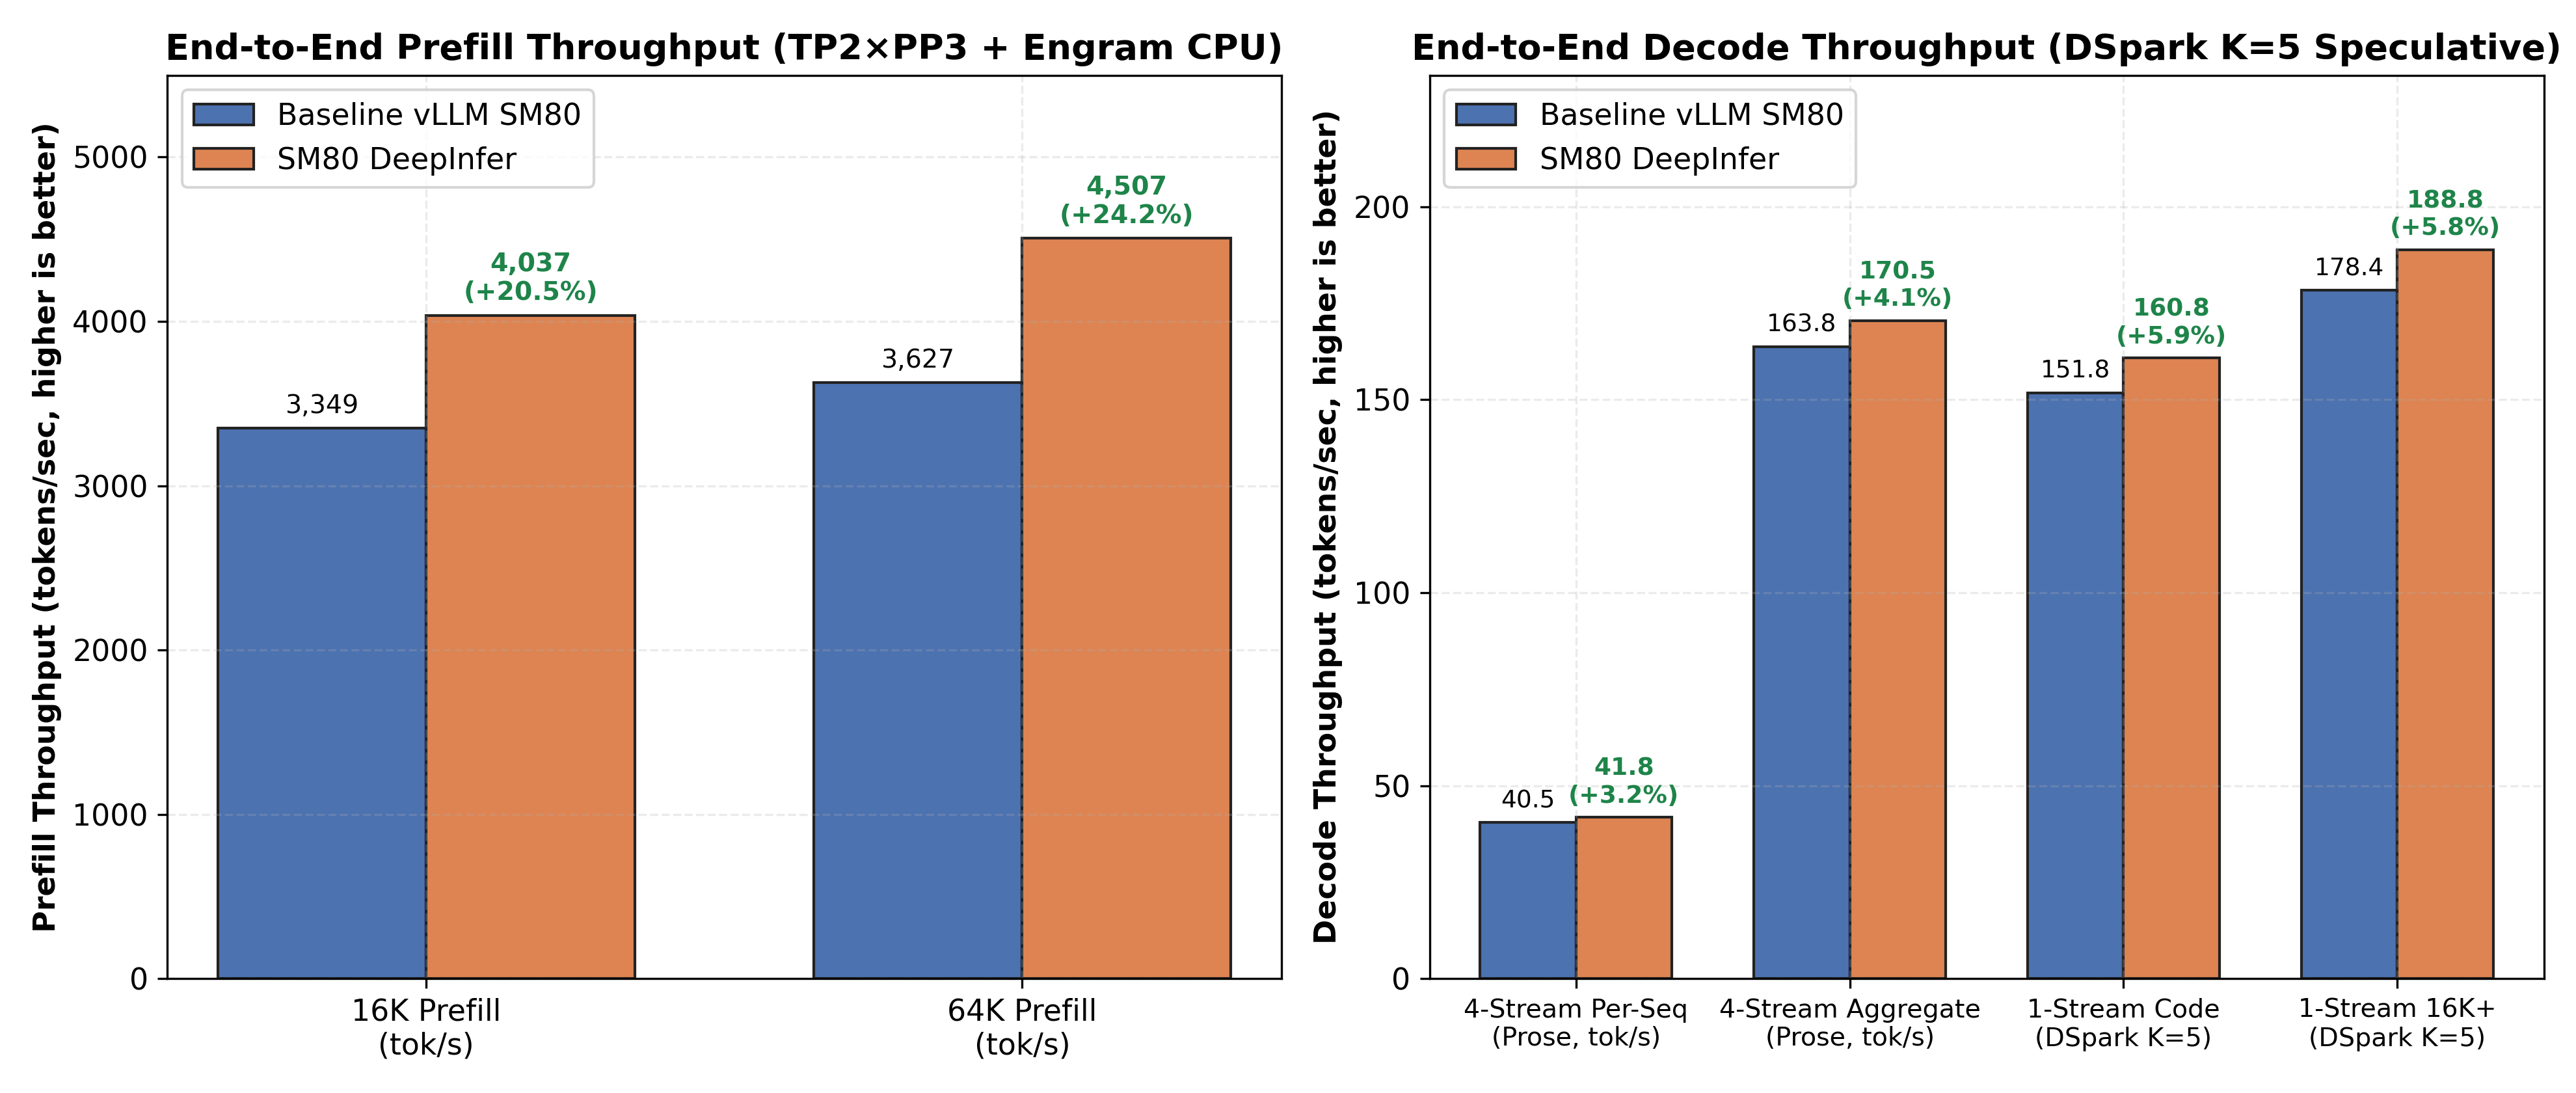
DeepInfer-SM80 专注于 DeepSeek-V4.1 预填充、稀疏注意力、KV-cache 访问、残差路由和长上下文推理中的高开销操作。仓库报告了以下生产配置下的结果:使用六块 GA100 64 GB GPU、TP2 × PP3、K=5 的 DSpark 推测解码,以及 1,048,576 tokens 的最大上下文长度:
- 16K 冷预填充:4,037.0 tokens/秒,高于 3,349.4 tokens/秒。
- 64K 冷预填充:4,506.8 tokens/秒,高于 3,627.3 tokens/秒。
- 64K 首 token 延迟:10.7 秒,低于 13.2 秒。
- 四流推测解码:总计 170.5 tokens/秒,高于 163.8 tokens/秒。
- 单流 Python 代码解码:160.8 tokens/秒,高于 151.8 tokens/秒。
- GPU 驻留 KV 容量:4,648,480 tokens;相较基线没有额外的 VRAM 开销。
这些测量结果对应仓库测试过的硬件和服务配置。在其他 Ampere GPU、模型配置、工作负载或 vLLM 环境下,结果可能有所不同。
关键优化
统一的 512 维稀疏 MLA
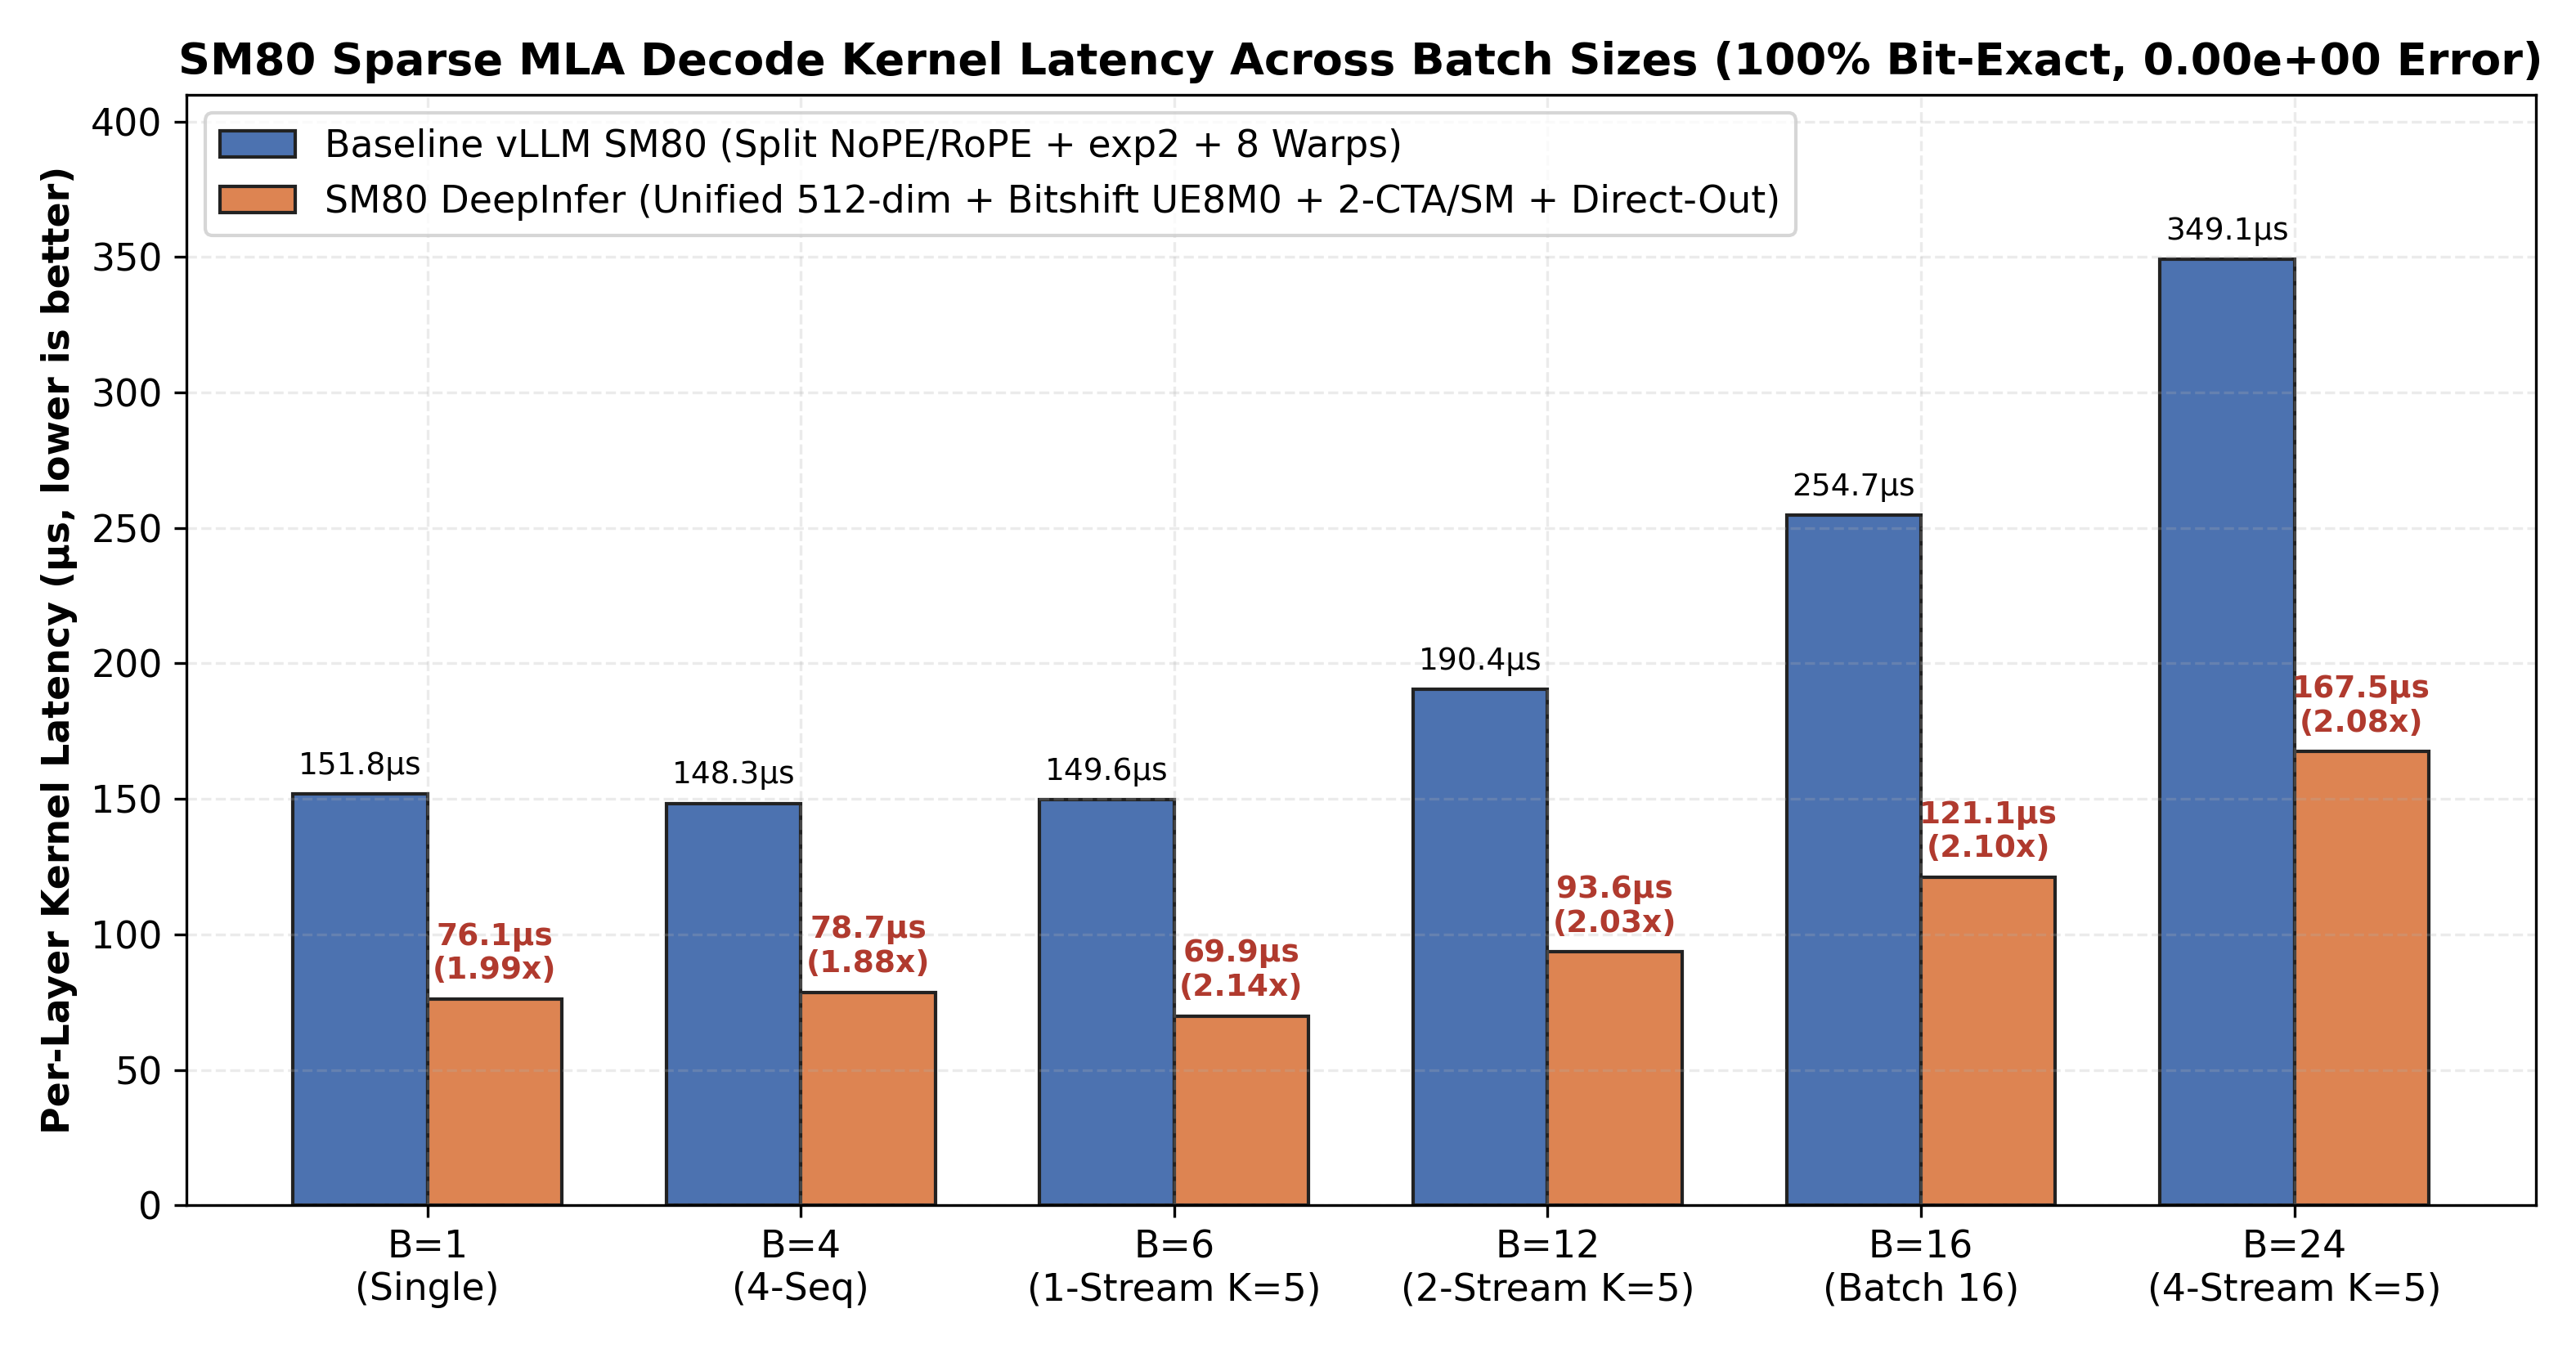
DeepSeek-V4.1 的 DeepSelect 稀疏注意力会将 448 维 NoPE latent 以 float8_e4m3fn 存储,并使用 UE8M0 二的幂次方 block scale,同时保留 64 维 BF16 RoPE 后缀。DeepInfer-SM80 会加载完整的 512 维 tile,并通过单一 Tensor Core 点积路径进行处理,而不是分别处理 NoPE 和 RoPE 部分。
该内核使用 IEEE-754 整数位移替代基于 exp2 的 UE8M0 转换:
(scale_u8.to(tl.int32) << 23).to(tl.float32, bitcast=True)对于有效的 UE8M0 指数,这会生成位级完全相同的 FP32 scale 值,同时将计算从超越运算转移到整数流水线。
调优后的配置使用 BLOCK_N=64、num_warps=4 和 num_stages=2。降低寄存器压力后,每个 SM80 流式多处理器可以驻留两个 CTA。当 num_kv_splits == 1 时,内核会直接写入最终输出,避免启动单独的归约阶段。
单 CTA Top-K 与 SWA 索引组合
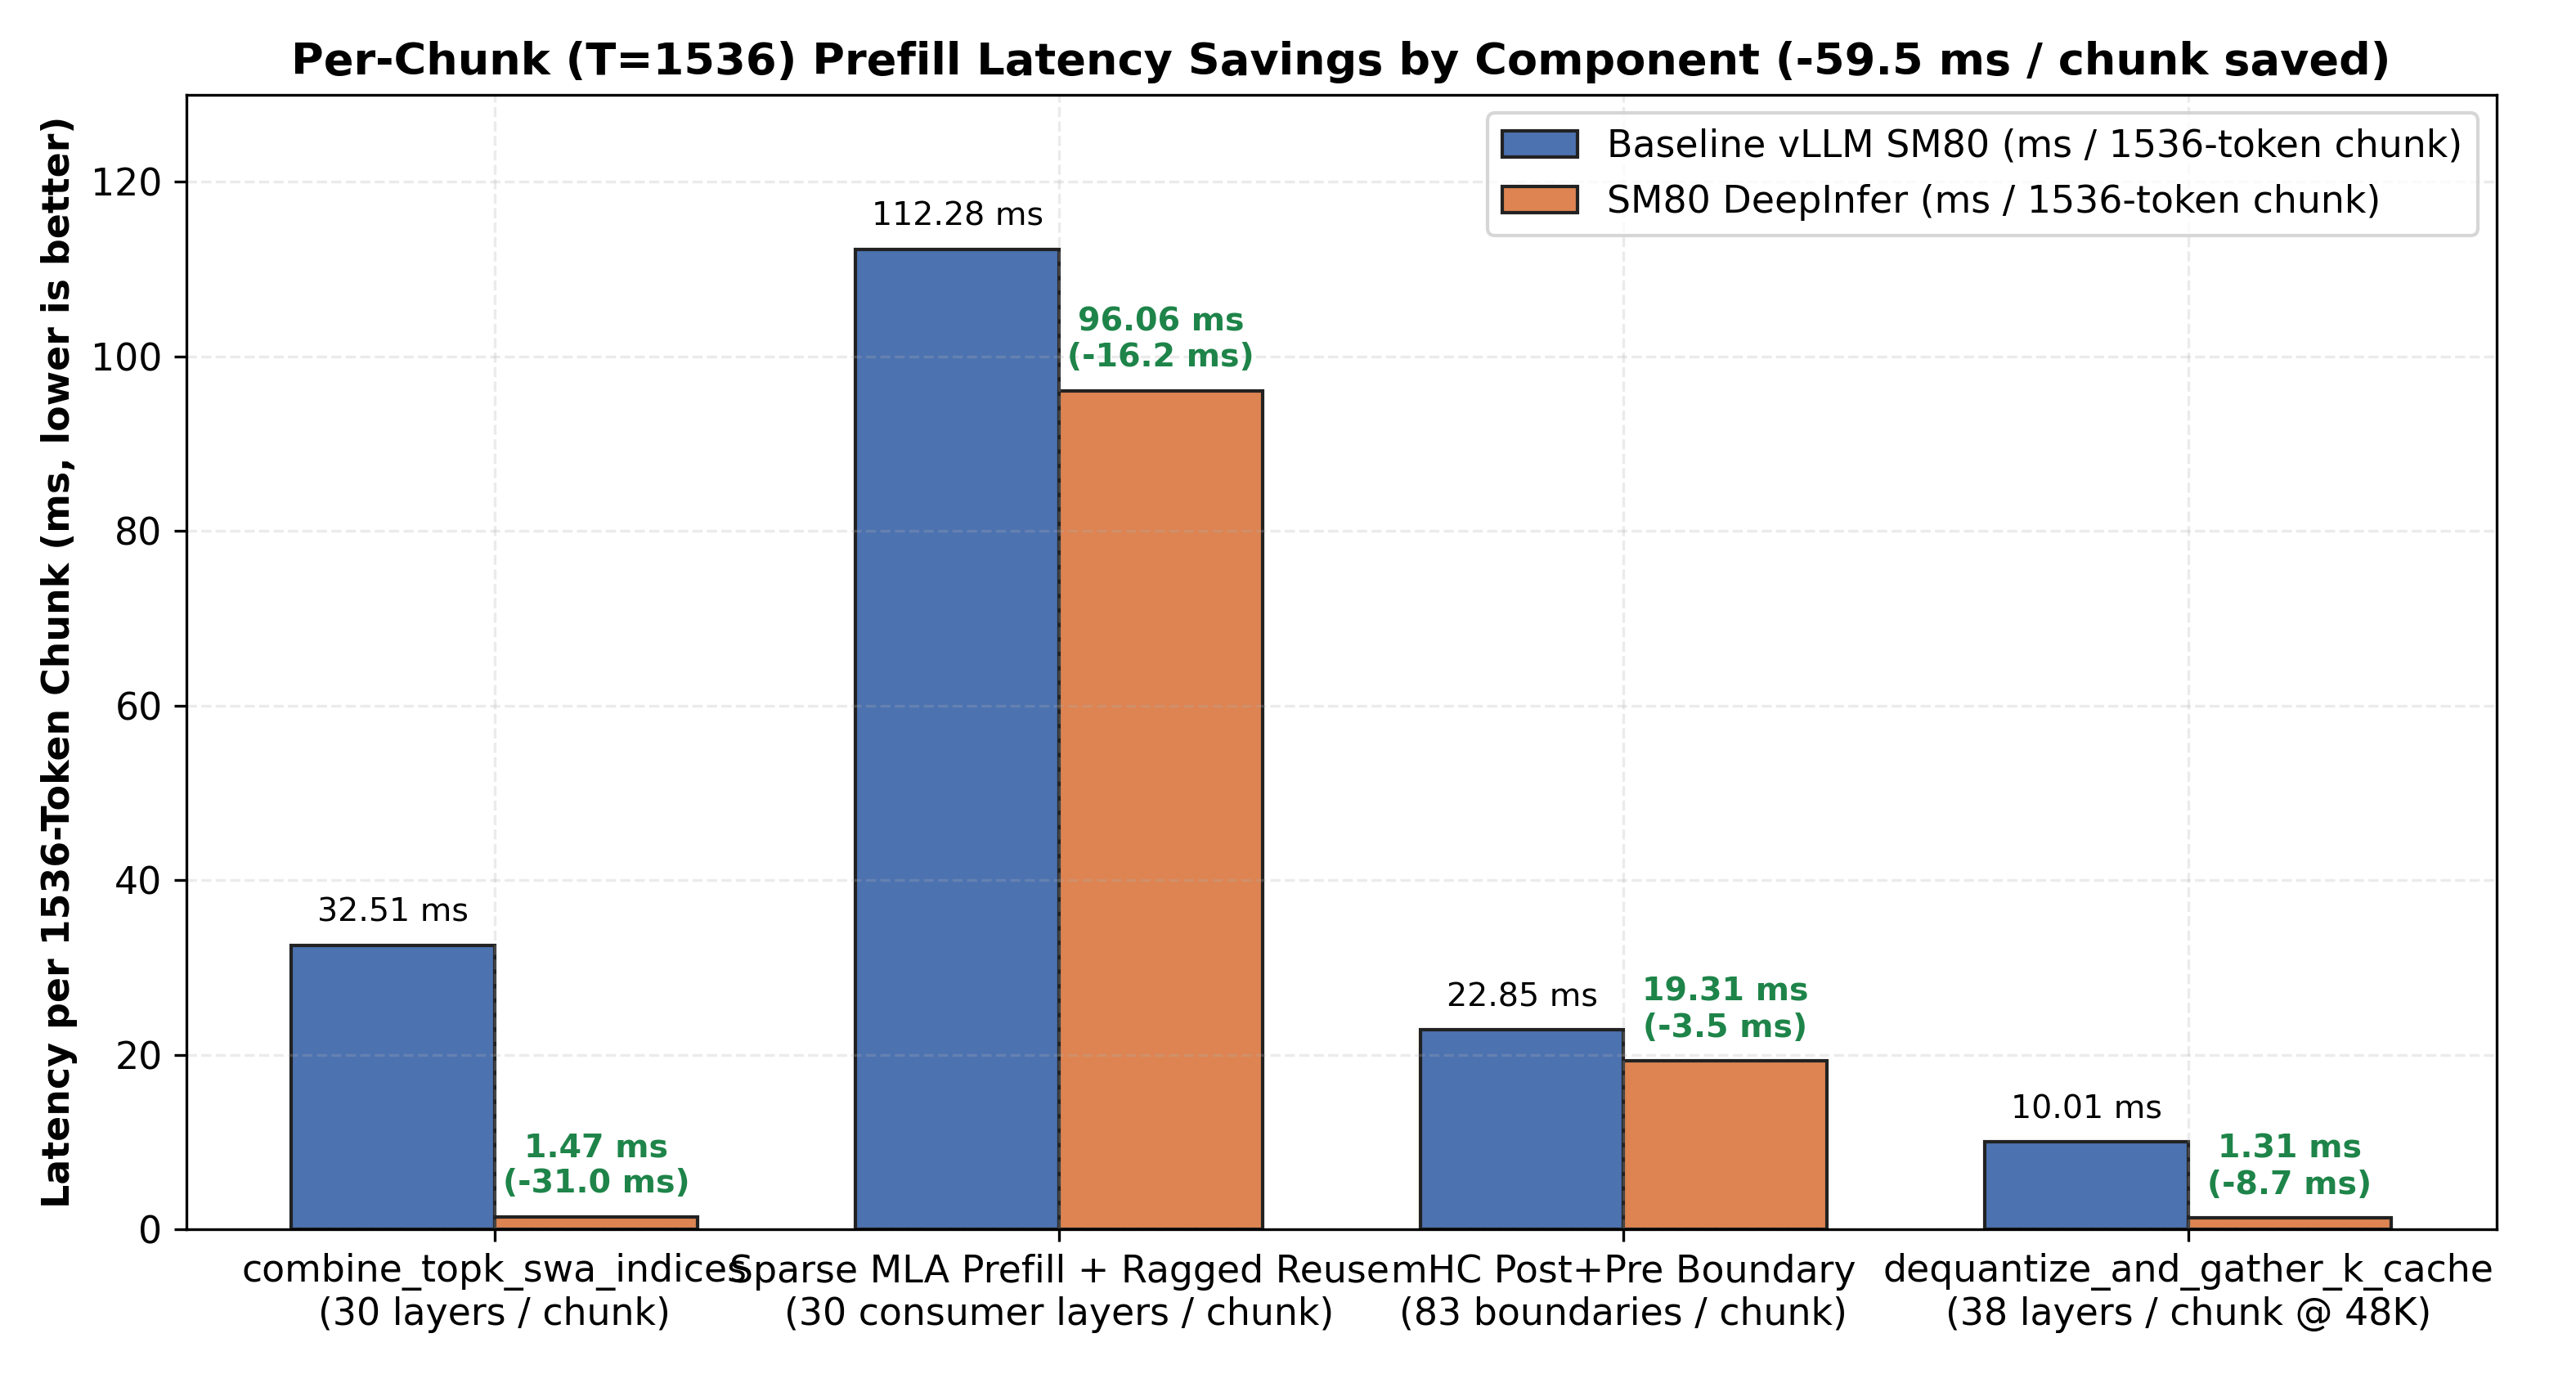
优化后的 _combine_topk_swa_indices_kernel 使用一个 Triton 内核和每个查询 token 一个 CTA,替代一系列 PyTorch 分配与操作。在 T=1536 时,实测延迟从 1,083.72 微秒降至 48.88 微秒,速度提升 22.17 倍。
为避免 warp 间写入竞争,每个输出行被划分为三个互不相交的区域:
- 压缩后的 Top-K 索引占据
[0, topk_len)。 - 滑动窗口注意力索引占据
[topk_len, topk_len + swa_len)。 - 剩余列使用
-1填充。
README 报告称,在所有测试过的序列长度以及压缩比 0、1 和 2 下,输出均达到位级一致。
更快的 KV-Cache 反量化与聚合
dequantize_and_gather_k_cache 路径使用相同的基于位移的 UE8M0 转换。它还会按照传递给 Triton 内核的目标步幅进行写入,从而消除中间的 torch.empty 分配和后续的 .copy_() 操作。
实测速度在 16K 上下文下提升 4.02 倍,在 48K 上下文下提升 7.64 倍;报告中的测试均与参考结果达到位级一致。
针对 SM80 调优的 mHC 残差路由
DeepSeek-V4.1 会在每次前向传递中的 83 个边界执行四流流形约束超连接路由。DeepInfer-SM80 为模型的 5,120 隐藏维度增加了对齐的 (6, 8, 128) 切分几何结构。八个切片中的每个包含 640 个元素,可被 128 整除。
项目还将小矩阵阈值从 32 降至 16,使 token 数量至少为 16 时可以使用 Tensor Core 的 T.gemm 路径。报告的 mhc_fused_post_pre_delayed 速度提升在 T=12 时为 2.89 倍,在 T=6 时为 1.30 倍。
YOCO 元数据复用
在 DeepSeek-V4.1 的 You-Only-Cache-Once 架构中,第 21 层至第 39 层读取第 20 层的全分辨率 KV 缓存。这些消费者共享相同的扩展序列长度、块表和压缩比。
DeepInfer-SM80 在处理第 20 层时,将不规则 K 元数据存储在 vLLM forward context 中。在第 21 层至第 39 层复用这些数据,可为每个预填充块消除 19 条冗余的元数据构建 GPU 内核链。
安装前准备
你需要一个 vLLM V1 环境,以便在受支持的 NVIDIA Ampere GPU 上运行 DeepSeek-V4.1。该仓库提供一个统一补丁和六个替换模块,但 README 未规定 CUDA、Python、Triton、TileLang 或 vLLM 的确切版本号。请使用与该补丁及现有 DeepSeek-V4.1 部署兼容的 vLLM 代码库。
支持的硬件组包括:
- SM80 数据中心 GPU:A100 40 GB、A100 80 GB、GA100 64 GB,以及 A800 40 GB 或 80 GB。
- SM86 工作站和消费级 GPU:RTX 3090、RTX 3090 Ti、RTX A6000、A40、A10 和 A30。
该软件采用 Apache License 2.0 发布。
安装选项 A:应用统一补丁
此方法会将全部六个修改文件应用到 vLLM 源代码检出目录。在该目录的根目录中打开终端并运行:
git apply /path/to/Deepinfer-SM80/patches/vllm-sm80-deepinfer.patch将 /path/to/Deepinfer-SM80 替换为克隆或下载项目所在的位置。该补丁包含稀疏 MLA、缓存聚集、Top-K 加 SWA、mHC、预热以及 YOCO 元数据复用等修改。
安装选项 B:安装即插即用模块
如果直接替换文件更适合你的环境,可以将项目的 vLLM 模块树复制到已安装的 vLLM 软件包中:
cp -r vllm_sm80_deepinfer/vllm/* /path/to/site-packages/vllm/将 /path/to/site-packages/vllm/ 替换为实际的 vLLM 软件包目录。在 Docker 部署中,也可以将相同文件作为只读覆盖层进行绑定挂载。
即插即用目录树修改了以下功能区域:
model_executor/kernels/mhc/:用于 TileLang mHC 执行和预热。models/deepseek_v4_1/amd/rocm.py:用于 Triton Top-K 和 SWA 组合器。models/deepseek_v4_1/common/ops/cache_utils.py:用于 KV 缓存聚集。models/deepseek_v4_1/nvidia/model.py:用于 YOCO 元数据复用。v1/attention/ops/rocm_aiter_mla_sparse.py:用于统一稀疏 MLA 内核。
尽管两个优化文件的路径中仍保留了
rocm或amd,但该仓库明确将它们作为面向 Ampere 的 vLLM 集成的一部分使用。应用即插即用文件时,请保留所提供的目录结构。
基本用法:验证内核
安装补丁或即插即用模块后,在目标 A100、A800、RTX 3090、RTX A6000 或其他受支持的 Ampere GPU 上运行随附的隔离微基准测试:
python3 benchmarks/microbench_sm80_kernels.py
python3 benchmarks/microbench_sm80_part2.py
python3 benchmarks/microbench_sm80_part3.py
这些基准文件涵盖稀疏 MLA 和 KV 聚集内核、TileLang mHC 内核,以及 Top-K 加 SWA 组合器。它们用于测量本地内核延迟,并将优化后的输出与基线参考结果进行验证。
使用以下命令生成仓库的基准图表:
python3 benchmarks/generate_charts.py完整的基准数据集也位于 benchmarks/results/sm80_benchmark_summary.json。
理解数值验证
据报告,多个优化路径实现了位级精确:
_combine_topk_swa_indices_kerneldequantize_and_gather_k_cache_sparse_attn_decode_kernelmhc_post_with_sqrsum
其他 Tensor Core 路径可能会出现轻微差异,因为 BF16 累加或 MMA 执行顺序发生了变化。在实测的融合 mHC 配置中,报告的最大差异低于 1.9e-3;在实测的稀疏注意力预填充配置中,低于 4.8e-3。
Prompt-logprob 负对数似然结果仍处于报告的运行间噪声范围内。评估部署时,应同时检查性能和数值输出,不要假定每个优化算子都必须实现位级一致。
高级部署建议
针对经过测试的六 GPU 生产布局使用 TP2 × PP3
对于六块 64 GB 或 80 GB 的 Ampere GPU,该仓库建议使用 TP2 × PP3,并采用 14,14,12 的层分区。在测试配置中,该布局针对选定的单流代码和长生成工作负载,可达到每秒 160.8 至 188.8 个 token;64K 冷预填充可达到每秒 4,506.8 个 token;并可容纳约 465 万个驻留 GPU 的 KV token。
在基准配置下,该容量相当于约 4.43 个一百万 token 的上下文。
了解替代方案
- PP6:可提供约 450 万至 470 万个 token 的容量,但 README 报告称,由于张量并行度为一且请求需要跨越六个流水线阶段,单流解码速度明显更慢。
- 非对称 TP2 加 TP4:可将估算容量提高到约 600 万个 token,但将 MoE 中间层大小 2,304 拆分为宽度为 576 的 TP4 分区会降低 Marlin tile 效率。
在为百万 Token 部署选择拓扑之前,请先查阅仓库中的 docs/05_TOPOLOGY_1M_CONTEXT_ANALYSIS_SM80.md。
基准测试实际工作负载
最大的收益来自频繁调用的算子,但端到端性能提升取决于提示词长度、并发数、推测解码、拓扑结构和 GPU 型号。先运行隔离基准测试,然后使用与生产应用相同的提示词、上下文大小和并发级别,对完整服务工作负载进行比较。
保留直接输出快速路径
当 num_kv_splits == 1 时,稀疏 MLA 解码优化会跳过第二次归约启动。如果修改注意力调度或拆分行为,请重新测量该内核,因为直接输出路径是报告中解码性能提升的重要组成部分。
在前向上下文中保留 YOCO 元数据
第 20 层的元数据缓存非常有价值,因为第 21–39 层的所有消费者都共享其 KV 源。对模型执行或前向上下文处理的修改应保留这种复用机制;否则,引擎可能会为每个消费者层重复构建相同的非规则元数据。
结论
DeepInfer-SM80 为在 NVIDIA Ampere 上加速 DeepSeek-V4.1 提供了一条专注的路径,同时不会增加 KV 缓存的 VRAM 开销。其改进结合了面向 Ampere 的稀疏注意力、位移 UE8M0 解码、直接 KV 缓存输出、无竞态的 Top-K 与 SWA 组合器、对齐的 mHC 路由,以及 YOCO 元数据复用。
首先应用统一补丁,或安装六个可直接替换的模块。运行全部三套微基准测试,以在你的硬件上确认延迟和数值行为,然后使用真实服务工作负载评估优化后的 vLLM 环境。对于六 GPU、百万上下文的部署,请将仓库中经过测试的 TP2 × PP3 配置作为主要参考。