

项目简介
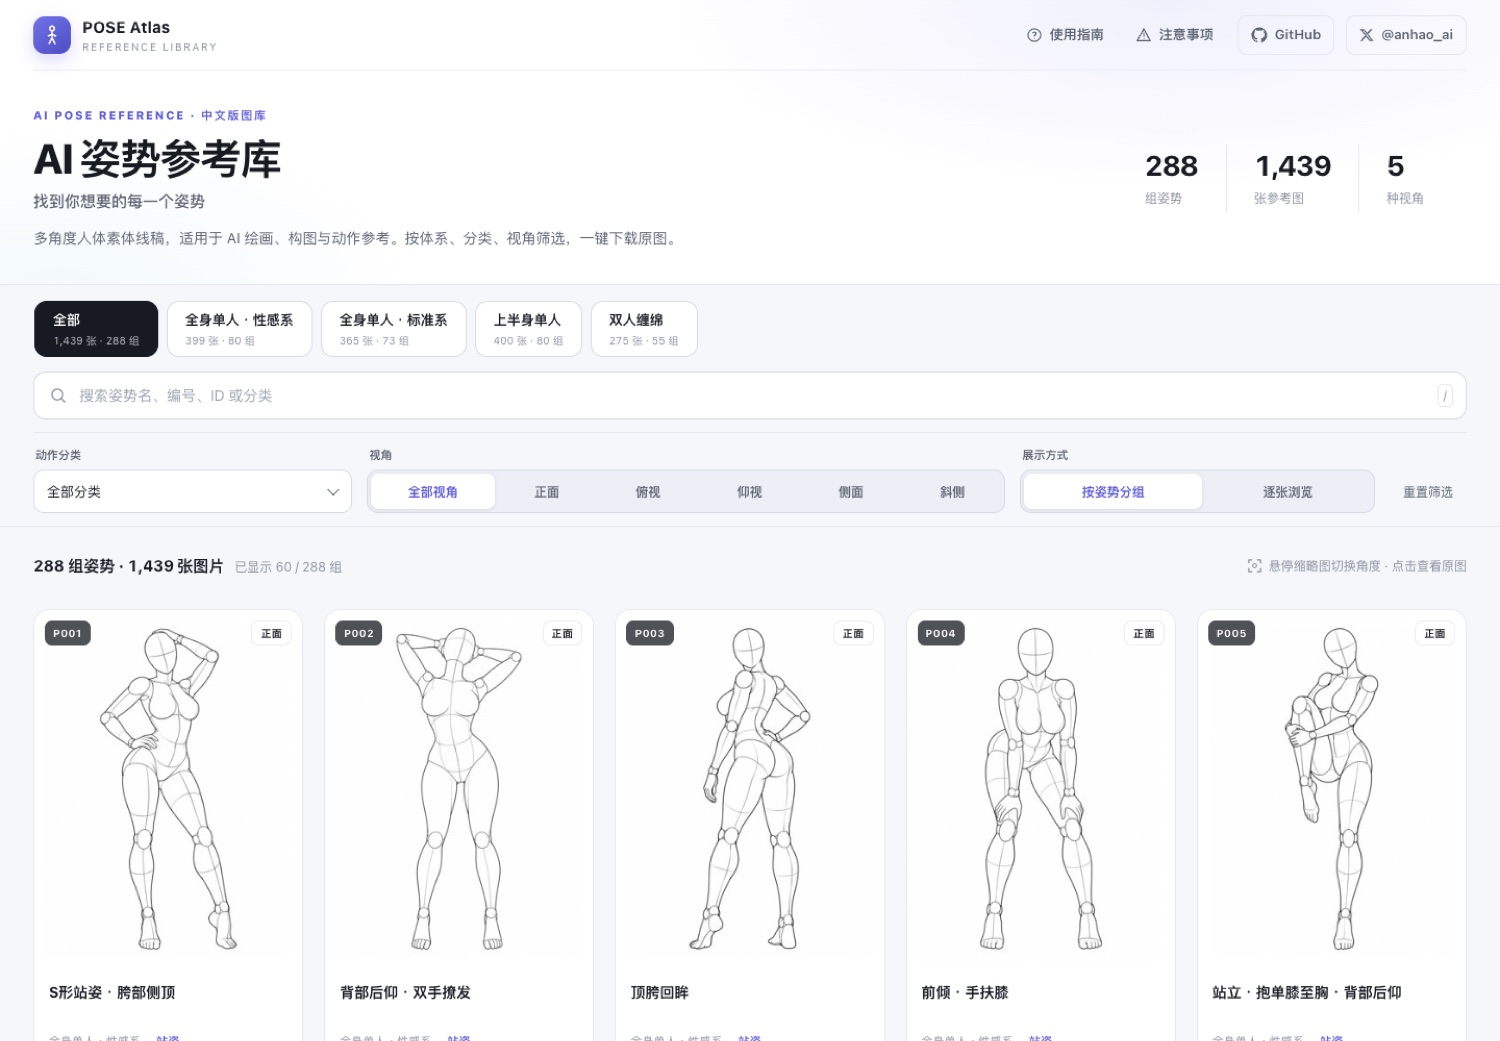
AI Pose Gallery 中文版是一套面向 AI 绘画、3D 创作和摄影参考的静态人体姿势图库。项目收录 288 组、1439 张多角度参考图,并将原站的日文元数据完整翻译为中文。
仓库同时保存了 1439 张 JPG 缩略图和 1439 张 PNG 原图,共 2878 个图片文件。前端为零依赖单页应用,不需要安装框架或运行构建工具即可使用。
你可以访问在线演示查看实际效果,也可以从GitHub 仓库获取完整项目。
图库包含成人向姿势参考,部分分类名称涉及性行为术语。内容仅供艺术创作、动作参考与前端技术学习使用,未成年人请勿访问。
主要功能
搜索与组合筛选
画廊按照四个体系组织内容,页面会显示每个体系的图片数量和姿势组数。搜索框支持姿势名称、编号、ID 与分类关键词,按 / 可以快速聚焦搜索框。
- 四个姿势体系页签
- 26 类动作分类
- 正面、斜侧、侧面、俯视和仰视五种视角
- 体系、分类和视角组合筛选
- 一键重置筛选条件
分组与逐张浏览
页面提供按姿势分组和逐张浏览两种模式。分组卡片会展示同一姿势的多个角度缩略图,悬停或点击缩略图即可切换卡片主图。
打开灯箱后,页面会先显示 300×400 缩略图,再加载 900×1200 PNG 原图。灯箱支持下载 PNG、复制记录 ID,以及在新窗口中打开图片。
←与→:切换当前姿势的角度↑与↓:切换姿势Esc:关闭灯箱- 手机端左右滑动:切换图片
响应式布局
桌面端使用多列网格,手机端使用双列网格。移动设备上的筛选面板可以展开或收起,便于在较小屏幕上浏览。
数据规模与结构
1439 条记录分布在四个体系中:
- 全身单人・标准系:365 条
- 全身单人・性感系:399 条
- 上半身单人:400 条
- 双人缠绵:275 条
前端实际读取 data/pose-zh.json。每条记录包含唯一 ID、体系、姿势编号、分类、姿势名称、角度、缩略图路径、原图路径和检索字符串。
{
  "id": "full_sexy_P001_front",
  "体系": "全身单人・性感系",
  "姿势编号": "P001",
  "分类": "站姿",
  "姿势名称": "S形站姿・胯部侧顶",
  "角度": "正面",
  "缩略图": "thumbs/…jpg",
  "原图": "img/…png",
  "检索": "用于前端模糊搜索的拼接串"
}
data/pose.json 保留原始日文字段和数据,便于翻译校对或数据回灌。data/translations.csv 则提供 323 条日中对照记录。
获取项目
准备好 Git 和 Python 3,然后克隆仓库并进入项目目录:
git clone https://github.com/anhao/ai-pose-gallery-zh.git
cd ai-pose-gallery-zh
项目没有 npm 或 Python 依赖安装步骤。核心页面位于 index.html,数据和图片已经保存在仓库对应目录中。
重要目录
index.html:零依赖单页画廊data/:日文数据、中文数据、分类和翻译对照表thumbs/:1439 张 300×400 JPG 缩略图img/:1439 张 900×1200 PNG 原图scripts/:下载、翻译回填、校验和发布脚本_headers:Cloudflare Pages 缓存策略robots.txt与sitemap.xml:搜索引擎配置
本地启动画廊
页面通过 fetch 加载 JSON 数据,因此不能直接双击 index.html。直接使用本地文件协议时,浏览器会因安全策略拦截请求。
在仓库根目录启动 Python HTTP 服务器:
python3 -m http.server 8000随后打开:
http://127.0.0.1:8000页面加载后,可以按以下顺序熟悉基本操作:
- 从顶部页签选择一个姿势体系。
- 选择动作分类和一个或多个视角。
- 在搜索框中输入姿势名、编号、ID 或分类关键词。
- 在分组模式与逐张模式之间切换。
- 点击卡片打开灯箱,再使用键盘或触屏手势导航。
- 在灯箱中下载 PNG 原图或复制记录 ID。
维护图片与翻译数据
重新下载图片
仓库提供并发下载脚本。已经存在的文件会被自动跳过,因此命令可以重复执行,并支持断点续传和自动重试。
python3 scripts/download.py默认并发数为 48。如需调整并发量,可以设置 WORKERS:
WORKERS=64 python3 scripts/download.py更新中文翻译
翻译词典位于 scripts/i18n.py。修改其中的译文后,运行回填脚本重新生成中文数据:
python3 scripts/apply_translation.py生成结果会供前端读取。更新后建议检查 data/pose-zh.json 中的体系、分类、姿势名称、角度和检索字段是否符合预期。
校验图片完整性
校验脚本会检查 2878 个文件的存在性、文件大小和图片头:
python3 scripts/verify.py在重新下载素材、移动目录或正式部署前执行一次校验,可以减少线上出现缺图或损坏图片的风险。
部署到 Cloudflare Pages
该项目是纯静态站点,推荐连接 GitHub 后交给 Cloudflare Pages 自动发布。
- 登录 Cloudflare Dashboard。
- 进入 Workers & Pages,依次选择 Create、Pages 和 Connect to Git。
- 选择项目仓库,并将生产分支设置为
main。 - 将 Framework preset 设置为
None。 - 将 Build command 设置为
bash scripts/build.sh。 - 将 Build output directory 设置为
dist。 - 保存并部署,通常约 2 至 5 分钟后可获得
https://<project>.pages.dev地址。
之后每次向生产分支执行 git push,Cloudflare Pages 都会自动重新构建并发布。
不要将 Build output directory 直接设置为仓库根目录。根目录中的
.git可能包含数百 MB 数据,Cloudflare 扫描其中的 pack 文件时可能触发 25 MiB 单文件限制。scripts/build.sh会仅将站点所需文件复制到dist。
仓库最大单文件约 917 KB,发布目录约有 2883 个文件,符合 Cloudflare Pages 的单文件不超过 25 MiB、单次部署不超过 20000 个文件的限制。
使用命令行部署
如果不连接 GitHub,也可以先生成发布目录,再通过 Wrangler 上传:
bash scripts/build.sh
npx wrangler pages deploy dist --project-name ai-pose-gallery-zh
_headers 已为 img/ 和 thumbs/ 配置一年期强缓存,可避免浏览器重复请求未变化的图片。
高级配置建议
更换正式域名
仓库中的绝对地址默认指向 https://ai-pose-gallery.anhao.app/。如果 Fork 后部署到自己的域名,需要同步修改以下位置:
index.html中的 canonical 地址- Open Graph 的
og:*地址 - Twitter Card 的
twitter:*配置 - JSON-LD 结构化数据中的站点地址
robots.txt中的 sitemap 地址sitemap.xml中的首页地址
统一更新这些地址可以避免自定义域名与 pages.dev 域名被搜索引擎视为重复页面。
保留 SEO 语义
页面已经配置独立的 description、keywords、author、Open Graph、Twitter Card,以及 WebSite 和 ImageGallery JSON-LD 数据。修改前端时,应继续保持单一主标题、清晰的分区标题,以及包含姿势名和视角的图片替代文本。
缩略图采用懒加载,灯箱先显示小图再请求原图。扩展页面功能时,建议保留这一加载顺序,以免 900×1200 PNG 同时请求而影响首屏速度。
修改数据时保持字段一致
搜索、筛选、分组和角度切换都依赖 pose-zh.json 中的字段。手工编辑记录时,应特别注意 id 的唯一性、图片相对路径、体系名称、分类、姿势编号和角度名称,并在修改后运行校验脚本。
版权与使用边界
图片及原始数据的著作权归原作者ギア所有。仓库维护者不对这些素材主张权利,项目也不构成对原作品的商业使用授权。
scripts/ 与 index.html 的代码采用 MIT 协议,但该协议不覆盖 img/、thumbs/ 和 data/ 中的图片与原始数据。二次发布或使用素材前,应确认用途符合相关版权要求。
总结
AI Pose Gallery 中文版将完整汉化数据、本地图片资源和响应式前端整合在一个零依赖静态项目中。通过 Python HTTP 服务器即可本地预览,借助内置脚本可以重新下载、更新翻译和校验素材,再使用 Cloudflare Pages 快速发布。部署自己的版本时,记得调整域名相关的 SEO 配置,并遵守项目的内容提示与版权边界。