

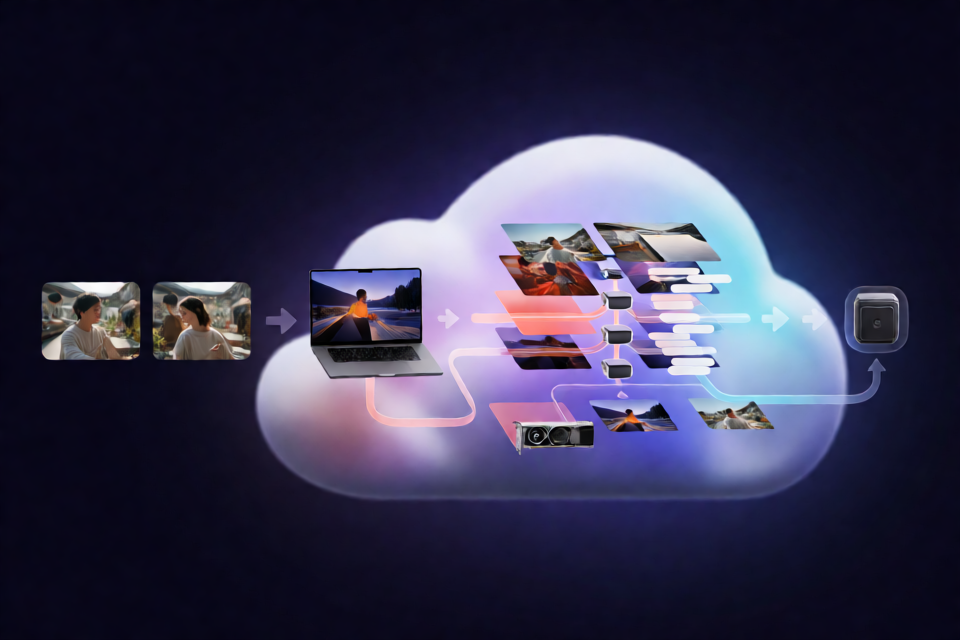
本项目的作用
MiniMax H3 Ref2VA LoRA Colab Skill 是一个可安装的 Codex 技能,用于准备成对的图像数据集,并在 Google Colab 上训练MiniMax H3 Ref2VA LoRA。其运行器会整理本地图像、打包数据集、启动随附的 Colab 笔记本,将检查点和运行产物保存到 Google Drive,并将最终的 .safetensors 适配器下载到您的计算机。
此工作流专门针对 MiniMax H3 Transformer。H3 在其图像理解流程中使用 Qwen3-VL,但Qwen Image 是一个独立模型。Qwen Image LoRA 与 H3 适配器不兼容。
主要功能
- 创建目标图像与参考/控制图像配对的数据集。
- 在可用时使用具有相同基础名称的描述文件。
- 支持使用 JSON 数据集计划,以实现可复现的描述和参考图像选择。
- 通过 Google Colab 上的 Ostris AI Toolkit 运行 MiniMax H3 Ref2VA LoRA 训练。
- 支持配置训练步数、LoRA 秩、alpha、学习率、GPU 类型和高内存请求。
- 将检查点、样本、配置和运行摘要同步到 Google Drive。
- 将最终的
.safetensors适配器下载到本地输出目录。 - 提供检查 Colab 计算余额和测试远程运行时连接的命令。
前置条件
安装此技能前,请确保本地系统具备:
- Python 3.10 或更高版本。
- 已安装并完成身份验证的 Google Colab CLI,然后才能运行远程命令。
- 能够访问 GPU 硬件的 Colab 账户。
- 访问所需 H3 模型和训练适配器资源的权限,包括接受任何适用的许可证。
- 足以完成预期训练运行的可用 Colab 计算资源。
随附的笔记本会检查是否至少有 60 GiB 可用磁盘空间,并在 GPU 显存低于 48 GiB 时发出警告。项目建议使用高内存 A100,但没有官方最低显存保证。
安装 Codex 技能
克隆仓库并运行安装程序:
git clone https://github.com/killkli/minimax-h3-lora-colab-skill.git
cd minimax-h3-lora-colab-skill
./install.sh
设置了 CODEX_HOME 时,安装程序会将技能放置在 $CODEX_HOME/skills 下。否则,它会使用 ~/.codex/skills。
若要安装到其他技能目录,请提供 --dest:
./install.sh --dest /path/to/skills默认情况下,现有安装会被保留。如果您确实想要替换现有安装,请使用 --force。安装程序会将之前的副本移至带时间戳的备份中,而不会静默删除它。
验证安装
显示运行器帮助,而不启动 Colab 任务:
python3 ~/.codex/skills/minimax-h3-lora-colab/scripts/runner.py --help如果已配置 CODEX_HOME,请将 ~/.codex/skills 替换为 $CODEX_HOME/skills。本地安装和帮助检查不会启动训练,也不会消耗 Colab GPU 时间。
准备训练图像
将目标照片放入一个目录中。照片应展示同一个人或主体。您可以选择添加具有匹配基础名称的文本描述文件。例如,photo01.jpg 的描述可以保存在 photo01.txt 中。
在克隆的仓库中,使用以下命令准备数据集:
python3 scripts/runner.py prepare \
  --input-dir /path/to/target_photos \
  --name studio_subject \
  --trigger "studio_subject person" \
  --output-dir ./prepared_dataset
准备好的目录包含:
prepared_dataset/
├── targets/
├── references/
└── dataset_manifest.jsontargets/包含目标图像及其同名描述文件。references/包含基础名称与目标图像匹配的参考或控制图像。dataset_manifest.json记录每个样本的来源、目标、参考图像和描述。
数据集准备在本地完成。它会将原始照片复制到准备好的数据集中,但不会将其上传到 Colab。
自动选择参考图像
如果您未提供单独的参考文件夹,运行器至少需要两张目标照片。它会循环使用这些照片来创建参考配对。
请尽可能使用同一主体的多样且有用的视角。目标图像不应使用自身作为参考图像。
使用单独的参考文件夹
若要从另一个目录中选择参考图像,请添加 --reference-dir:
python3 scripts/runner.py prepare \
  --input-dir /path/to/target_photos \
  --reference-dir /path/to/reference_photos \
  --name studio_subject \
  --trigger "studio_subject person" \
  --output-dir ./prepared_dataset
每个选定的参考图像都必须展示与目标图像集相同的主体。如果您只整理较大集合中的一部分内容,请将选定的目标图像和参考图像放入暂存文件夹,并保持原始图像集合不变。
创建可复现的数据集计划
数据集计划会记录特定图像的描述以及可选的目标到参考图像的选择。这使手动整理或代理辅助整理过程具备可复现性。
{
  "captions": {
    "photo01.jpg": "studio_subject person, waist-up portrait in a blue jacket, outdoors in soft daylight",
    "photo02.jpg": "studio_subject person, side profile wearing a white shirt, indoors by a window"
  },
  "references": {
    "photo01.jpg": "front_reference.png",
    "photo02.jpg": "side_reference.png"
  }
}
captions 对象必须包含每个目标图像的基本文件名。如果存在可选的 references 对象,它还必须将每个目标基本文件名映射到候选参考目录中的一个图像基本文件名。
描述应仅说明可见细节。将无关的人物或主体放在不同的数据集中,并且不要将目标图像映射到其自身。
使用以下计划准备数据集:
python3 scripts/runner.py prepare \
  --input-dir /path/to/target_photos \
  --reference-dir /path/to/reference_photos \
  --dataset-plan /path/to/dataset-plan.json \
  --name studio_subject \
  --trigger "studio_subject person" \
  --output-dir ./prepared_dataset
如果省略 --dataset-plan,运行器会使用现有的旁车字幕,并为缺少字幕的图像提供简单的默认字幕。
上传前进行检查
训练前打开 dataset_manifest.json,核对每个源图像、目标图像、参考图像和字幕。这是发现配对错误、缺少描述或图像属于其他主体的最佳时机。训练步骤会将准备好的图像上传到 Colab 运行时。
在 Google Colab 上训练 LoRA
检查准备好的数据集后,启动训练运行:
python3 scripts/runner.py train \
  --dataset-dir ./prepared_dataset \
  --name studio_subject \
  --trigger "studio_subject person" \
  --steps 1000 \
  --rank 16 \
  --alpha 16 \
  --gpu A100 \
  --output-dir ./outputs
默认训练设置如下:
- 1,000 个训练步。
- LoRA 秩为 16。
- Alpha 为 16。
- 学习率为
1e-4。 - 使用高显存 A100 Colab 会话。
笔记本会下载 H3 模型及所需的训练适配器资源。最终适配器会以 .safetensors 文件的形式放置在 ./outputs/ 中。
运行产物还会同步到:
MyDrive/MiniMax_H3_LoRAs/<name>/<run-id>/Drive 目录包含检查点、生成的样本、配置数据和运行摘要。
谨慎更改训练参数
你可以替换示例中的步数、秩、Alpha、GPU 和输出目录值。要查看所有受支持的训练选项,请运行:
python3 scripts/runner.py train --help默认会请求高显存模式。只有在所选 Colab GPU 配置不应提出该请求时,才添加 --no-high-mem。
检查 Colab 使用量和连接性
要以 JSON 格式读取当前 Colab 计算余额,请使用:
python3 scripts/runner.py usage --json要配置远程 GPU 运行时,并验证探测、文件传输和 Google Drive 路径,请运行:
python3 scripts/runner.py test
test命令不是训练验证。它无法证明 MiniMax H3 训练能够适应可用显存或成功完成。
高级技巧和操作指南
保持主体数据集专注
每个数据集只使用同一个人或主体的图像。分离无关主体可以让字幕和参考映射更加清晰,也符合运行器预期的工作流。
使用图像专属字幕
不要只依赖通用字幕,而应描述姿势、服装、构图、环境和光线等可见属性。始终一致地加入所选触发词,但避免添加图像中无法看到的细节。
优先选择有用的参考多样性
选择能够提供不同视角、同时仍展示同一主体的参考图像。例如,在适当情况下搭配正面视图和侧面轮廓视图。绝不要将目标图像与其自身配对。
保留可供检查的记录
将数据集计划和生成的清单与项目一同保存。两者共同记录一次运行所使用的字幕和配对关系,便于审计或重复数据准备过程。
监控本地和云端输出
本地输出目录包含下载的最终适配器,而 Google Drive 会保留更完整的运行产物。如果训练运行意外停止,可以使用 Drive 中的副本检查检查点、样本、配置和运行摘要。
将硬件适配视为依赖运行时的因素
推荐使用的高显存 A100 并不能保证成功。实际显存占用取决于 Colab 运行时和训练配置。笔记本会在显存低于 48 GiB 时发出警告,并检查是否有 60 GiB 可用磁盘空间,但这些检查并不是官方硬件保证。
了解验证状态
上游 AI Toolkit Ref2VA 示例配置被标记为未验证。因此,仓库并未声称每次云端训练运行都能成功。笔记本会固定所检查的 AI Toolkit 源代码提交,以确保可复现性,但成功安装或远程探测成功不应被理解为端到端训练已完成的证明。
延伸阅读
结语
MiniMax H3 Ref2VA LoRA Colab 技能提供了一条从本地图像整理到可下载 H3 适配器的可重复路径。在本地准备并审核目标图像与参考图像对;如需可复现的说明文字和映射关系,请使用数据集计划;确认 Colab 资源和许可证后,再启动训练。请注意,上游配置仍未经验证,并且 Qwen Image LoRA 不能与 MiniMax H3 适配器互换使用。