
- ماہانہ وزٹس
- 0
- قیمتیں
- متعین نہیں
- فہرست میں شامل
- —
- اپ ڈیٹ شدہ
- 2026-10-08
01VoxMem کیا ہے؟
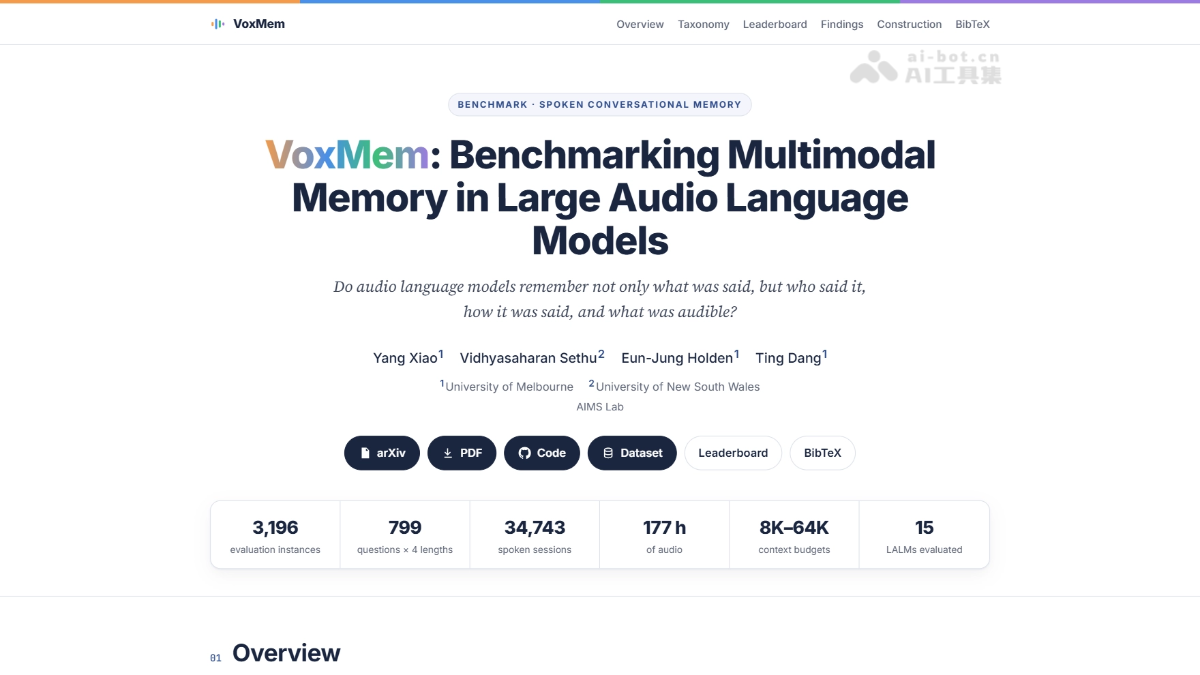
VoxMem میلبورن یونیورسٹی اور یونیورسٹی آف نیو ساؤتھ ویلز کی ٹیموں کا تیار کردہ آڈیو بڑے ماڈلز کی یادداشت کا بینچ مارک ہے۔ یہ پہلی بار 4 اقسام کے صوتی شواہد، یعنی معنوی مواد، مقرر، لہجہ اور محیطی آواز، کو 4 یادداشتی کارروائیوں، یعنی اخذ، بین الجلسی استدلال، زمانی پیروی اور جواب دینے سے انکار، کے دو جہتی جائزہ فریم ورک میں شامل کرتا ہے، جو 8K سے 64K ٹوکن تک کی کثیر الجلسی تاریخ کا احاطہ کرتا ہے۔ 15 ماڈلز کے ٹیسٹ سے ظاہر ہوا کہ 32K پر کسی بھی ماڈل کی مجموعی درستگی 40٪ سے زیادہ نہیں تھی۔ ماڈلز یہ یاد رکھ سکتے ہیں کہ کیا کہا گیا، لیکن یہ یاد رکھنا ان کے لیے مشکل ہے کہ کس نے اور کس انداز میں کہا؛ صرف آڈیو سیاق کو طویل کرنا پائیدار صوتی تعامل کے لیے کافی نہیں۔
02VoxMem کی اہم خصوصیات
کثیر الجلسی صوتی یادداشت کا جائزہ: کثیر الجلسی اور مختلف طوالت کی صوتی تاریخ کے ماحول میں یہ جانچا جاتا ہے کہ بڑے آڈیو لسانی ماڈلز سابقہ گفتگو کے مواد کو یاد رکھ کر دوبارہ پیش کر سکتے ہیں یا نہیں۔
چار اقسام کے صوتی شواہد کا احاطہ: صوتی معنویت، مقرر کی شناخت، مافوق اللسان اشاروں اور محیطی آواز کا بیک وقت جائزہ لیا جاتا ہے۔ آخری تین اقسام ایسی ”آڈیو اصل“ معلومات ہیں جنہیں نقلِ تحریر سے بحال نہیں کیا جا سکتا۔
یادداشت کی چار کارروائیوں کی درجہ بندی: معلومات کا اخذ، کثیر الجلسی استدلال، زمانی ارتقا کی پیروی اور ناکافی شواہد کی صورت میں جواب دینے سے انکار شامل ہیں۔ ہر دو اقسام کے ملاپ سے 15 مؤثر جائزہ خانے بنتے ہیں۔
تاریخ کی قابو شدہ طوالت: ایک ہی سوال میں 8K، 16K، 32K اور 64K ٹوکن کی چار تاریخی طوالتوں پر شواہد بالکل یکساں رہتے ہیں، صرف غیر متعلقہ گفتگو شامل کی جاتی ہے، اس لیے یادداشت پر طوالت کے اثر کو الگ سے ناپا جا سکتا ہے۔
کھلا جائزہ نظام: کوڈ اور ڈیٹا مکمل طور پر اوپن سورس ہیں۔ معیاری اجرا، اسکورنگ اسکرپٹس اور Leaderboard فراہم کیے گئے ہیں، جبکہ API ماڈلز اور مقامی ماڈلز دونوں کی تکرار ممکن ہے۔
03VoxMem کا تکنیکی اصول
WeChat پر ”اوپن سورس“ کا جواب دے کر AI اوپن سورس منصوبوں کے گروپ میں شامل ہوں
دو جہتی درجہ بندی کا فریم ورک: VoxMem کا بنیادی ڈیزائن صوتی شواہد × یادداشتی کارروائیوں کی دو جہتی درجہ بندی ہے۔ صوتی شواہد یہ طے کرتے ہیں کہ کیا یاد رکھنا ہے، اور صوتی معلومات کو معنوی مواد، مقرر، مافوق اللسان اشاروں اور محیطی آواز کی چار اقسام میں تقسیم کرتے ہیں؛ یادداشتی کارروائیاں یہ طے کرتی ہیں کہ اسے کیسے استعمال کرنا ہے، جن میں ایک ہی جلسے سے معلومات واپس لانا (IE)، متعدد جلسوں کے شواہد کو یکجا کرنا (MSR)، وقت کی ترتیب کے مطابق حالت کے ارتقا کی پیروی کرنا (TET)، اور ناکافی شواہد کی صورت میں جواب دینے سے انکار (AR) شامل ہیں۔ معنوی مواد × IE کے امتزاج کو جان بوجھ کر خارج کیا گیا ہے کیونکہ یہ خالص متنی بازیافت تک محدود ہو جاتا ہے۔ باقی 15 خانے مکمل جائزہ فضا بناتے ہیں، اس طرح صوتی یادداشت کی صلاحیت کا منظم، نہ کہ منتشر، جائزہ لیا جاتا ہے۔
تین مرحلوں میں ڈیٹا کی تیاری: ڈیٹا ”منصوبہ بندی—گفتگو لکھنا—صوتی ترکیب“ کی پائپ لائن سے تیار کیا جاتا ہے۔ پہلے ہر سوال کے لیے ایک ساخت یافتہ منصوبہ بنایا جاتا ہے، جس میں سوال، جواب، شواہد کی تقسیم اور قابلِ قبولیت کی پابندیاں طے ہوتی ہیں؛ پھر صارف اور معاون، دونوں جانب کی گفتگو الگ الگ تیار کی جاتی ہے۔ دونوں فریق مقرر، لہجے یا پس منظر کی آواز کا ذکر نہیں کرتے تاکہ جواب متن سے ظاہر نہ ہو؛ آخر میں TTS کے ذریعے آواز تیار کی جاتی ہے، ہر صارف کے لیے آواز کا انداز مستقل رکھا جاتا ہے، طرز کے کنٹرول سے لہجے کے اشارے شامل کیے جاتے ہیں، 10dB سگنل ٹو نوائز تناسب پر محیطی آواز ملائی جاتی ہے، اور اشاروں والے ہر دور کے لیے اشاروں سے پاک جوڑی دار ورژن بھی رکھا جاتا ہے تاکہ معیار کی جانچ کی جا سکے۔
خلل ڈالنے والی گفتگو اور طوالت کا کنٹرول: ہر تاریخی ریکارڈ شواہد والی گفتگو، خلل ڈالنے والی گفتگو اور پُر کرنے والی گفتگو پر مشتمل ہوتا ہے۔ خلل ڈالنے والی گفتگو کا موضوع شواہد والی گفتگو سے ملتا جلتا، مگر اقدار مختلف ہوتی ہیں۔ متن دیکھنے والے ایک درجہ بندی کنندہ کے ذریعے، جس کی درستگی صرف 51–56٪ ہے، تصدیق کی جاتی ہے کہ ماڈل محض سطحی موضوعاتی مماثلت سے جواب تلاش نہ کر سکے۔ طوالت کے کنٹرول میں چاروں تاریخی درجے سختی سے ایک دوسرے کے اندر شامل ہوتے ہیں؛ تاریخ کو صرف غیر متعلقہ پُر کرنے والی گفتگو سے طویل کیا جاتا ہے، اس لیے چاروں درجوں میں سوال، جواب اور شواہد یکساں رہتے ہیں۔ درستگی میں تبدیلی صرف تاریخ کے طویل ہونے سے منسوب کی جا سکتی ہے اور سوال کی مشکل کے اختلاط کا اثر ختم ہو جاتا ہے۔
04VoxMem استعمال کرنے کا طریقہ
ریپوزٹری کلون کریں: GitHub سے کوڈ حاصل کریں، git clone https://github.com/swagshaw/voxmem، اور منصوبے کی ڈائریکٹری میں داخل ہوں۔
انحصارات انسٹال کریں: pip install -r requirements.txt چلائیں۔ اختیاری طور پر pip install "datasets" انسٹال کریں تاکہ آڈیو خودکار طور پر ارے میں ڈی کوڈ ہو سکے۔
API کلید ترتیب دیں: اگر API ماڈل کا جائزہ لے رہے ہیں تو متعلقہ SDK انسٹال کریں اور کلید مقرر کریں، مثلاً pip install openai کے بعد export OPENAI_API_KEY=۔
اسموک ٹیسٹ چلائیں: پہلے python run_voxmembench.py --config 8k_speaker_information --model abstain --allow-abstention --limit 25 --out predictions_smoke.jsonl سے عمل کی تصدیق کریں، پھر score_voxmembench.py --judge exact-match سے اسکور کریں۔ تصدیق کریں کہ انکار کی پرت، انکار والے سوالات پر 1.0 اور جواب دیے جا سکنے والے سوالات پر 0.0 حاصل کرتی ہے۔
باقاعدہ جائزہ: ایک ترتیب منتخب کریں، مثلاً 32k مکمل مجموعہ یا 32k_speaker_information ذیلی مجموعہ، اور مطلوبہ ماڈل چلائیں، مثلاً python run_voxmembench.py --config 32k --model openai:gpt-4o-audio-preview --allow-abstention --out predictions_32k.jsonl؛ مقامی ماڈلز کے لیے --adapter سے حسبِ ضرورت اڈاپٹر فنکشن اور --model-dir سے وزن کی ڈائریکٹری مقرر کریں۔
LLM منصف کے ذریعے اسکورنگ: python score_voxmembench.py --predictions predictions_32k.jsonl --judge openai:gpt-4o-mini --out metrics_32k.json چلائیں۔ منصف صرف سوال، معیاری جواب اور دیے گئے جواب کو دیکھ کر کھلے جوابات کی مساوات کا فیصلہ کرتا ہے۔
05VoxMem کے بنیادی فوائد
آڈیو اصل یادداشت کا پہلا منظم احاطہ: موجودہ بینچ مارکس کی صرف لفظی مواد جانچنے کی حد کو توڑتے ہوئے پہلی بار یہ دیکھا جاتا ہے کہ کس نے کہا، کس انداز میں کہا اور کیا سنا گیا، یعنی غیر متنی صوتی معلومات، سب کو ایک متحد جائزہ فریم ورک میں شامل کیا جاتا ہے۔
دو جہتی درجہ بندی کا مضبوط ڈیزائن: 4 اقسام کے صوتی شواہد × 4 یادداشتی کارروائیوں کے 15 مؤثر خانوں کے ذریعے منتشر سوالات کی جگہ ایک ایسا نظام بنایا گیا ہے جس سے صوتی یادداشت کی صلاحیت کا جامع اور باہم مستقل جائزہ ممکن ہوتا ہے۔
کثیر الجلسی ترتیب حقیقی منظرناموں سے قریب: انسان اور مشین کے صوتی تعامل میں وقت کے ساتھ ہونے والی متعدد گفتگوؤں کی نقل کی جاتی ہے، نہ کہ ایک طویل یک طرفہ گفتگو کی، تاکہ بار بار آنے والے مقررین اور حالت کی تازہ کاریوں کے بارے میں ماڈل کی طویل مدتی یادداشت جانچی جا سکے۔
طوالت کا اثر مکمل طور پر الگ: 8K سے 64K تک کی چار تاریخی طوالتوں میں ایک ہی سوال کے شواہد سختی سے ایک جیسے اور اندرونی طور پر شامل رہتے ہیں، جس سے پہلی بار ”تاریخ کے طویل ہونے“ کے اثر کو سوال کی مشکل اور شواہد کی قسم سے صاف طور پر الگ کیا جاتا ہے۔
اخراجِ معلومات سے تحفظ اور دوہری معیار جانچ: گفتگو کے دونوں فریق صوتی اشاروں کا ذکر نہیں کرتے، جوڑی دار ورژن سے تقابل کیا جاتا ہے، اور دو سطحی معیار جانچ سے وہ سوالات نکال دیے جاتے ہیں جن کا جواب صرف نقلِ تحریر سے دیا جا سکے۔ یوں یقینی بنایا جاتا ہے کہ سوال کے لیے واقعی ”سننا“ ضروری ہو، صرف ”پڑھنا“ نہیں۔
خلل ڈالنے والے ڈیزائن سے شارٹ کٹ مشکل: موضوع میں ملتی جلتی مگر قدر میں مختلف خلل ڈالنے والی گفتگو کو صرف 51–56٪ درستگی والے متنی درجہ بندی کنندہ سے جانچا جاتا ہے، جس سے کلیدی الفاظ ملا کر جواب تلاش کرنے کا راستہ بند ہو جاتا ہے۔
06VoxMem منصوبے کا پتہ
منصوبے کی ویب سائٹ: https://swagshaw.github.io/voxmem/
GitHub ریپوزٹری: https://github.com/swagshaw/voxmem
HuggingFace ماڈل ریپوزٹری: https://huggingface.co/datasets/AudioMemory/voxmembench
arXiv تکنیکی مقالہ: https://arxiv.org/pdf/2609.32607
07VoxMem کے اطلاقی منظرنامے
صوتی معاونین اور اسمارٹ اسپیکرز کی طویل مدتی یادداشت کے ماڈل کا انتخاب: فراہم کنندگان VoxMem کے ذریعے امیدوار ماڈلز کو یکساں طور پر جانچ سکتے ہیں کہ آیا وہ مختلف جلسوں میں صارف کی ترجیحات، گھر کے افراد کی آوازیں اور سابقہ وعدے یاد رکھ سکتے ہیں، تاکہ سروس شروع ہونے کے بعد ”گزشتہ ہفتے کہی بات فوراً بھول جانے“ کا مسئلہ نہ ہو۔
گاڑیوں اور قابلِ پہننے والی صوتی تعامل کی جانچ: گاڑی کے اندر محیطی آواز شور والی اور صارف کا لہجہ متغیر ہوتا ہے۔ VoxMem کے محیطی آواز اور مافوق اللسان اشاروں کے ابعاد حقیقی شور والے منظرناموں میں ماڈل کی یادداشت کی قابلِ اعتمادیت جانچ سکتے ہیں۔
متعدد مقررین والے کسٹمر سروس اور کانفرنس نظام کی معیار جانچ: کسٹمر سروس مراکز اور اجلاس کے خلاصوں جیسے منظرناموں میں یہ درست طور پر منسلک کرنا ضروری ہے کہ ”کون سا جملہ کس نے کہا“۔ VoxMem میں مقرر سے منسلک غلط نسبت ایسے نظاموں کے ”غلط شخص سے بات منسوب کرنے“ کے مسئلے کی براہِ راست تشخیص میں استعمال ہو سکتی ہے۔
ساتھی روبوٹس اور بزرگوں کی دیکھ بھال کرنے والی مصنوعات میں جذباتی یادداشت کی تصدیق: گزشتہ ہفتے کسی بزرگ نے آہ بھر کر کہی ہوئی بات یا لہجے سے ظاہر ہونے والی تھکن صرف مافوق اللسان اشاروں کے ذریعے محفوظ ہو سکتی ہے۔ VoxMem کا زمانی پیروی کا بُعد جانچ سکتا ہے کہ آیا مصنوعات وقت کے ساتھ حالت میں آنے والی تبدیلی محسوس کر سکتی ہیں۔
© دستبرداری: ڈومینز اور لنک شدہ مواد وقت کے ساتھ تبدیل ہو سکتے ہیں۔ AIEZZ فریقِ ثالث کی ویب سائٹس کو کنٹرول نہیں کرتا۔ بیرونی مواد اور خطرات کا آزادانہ جائزہ لیں۔
صارف کے جائزے0