
- ماہانہ وزٹس
- 0
- قیمتیں
- متعین نہیں
- فہرست میں شامل
- —
- اپ ڈیٹ شدہ
- 2026-11-05
01WeVisOne-VL کیا ہے؟
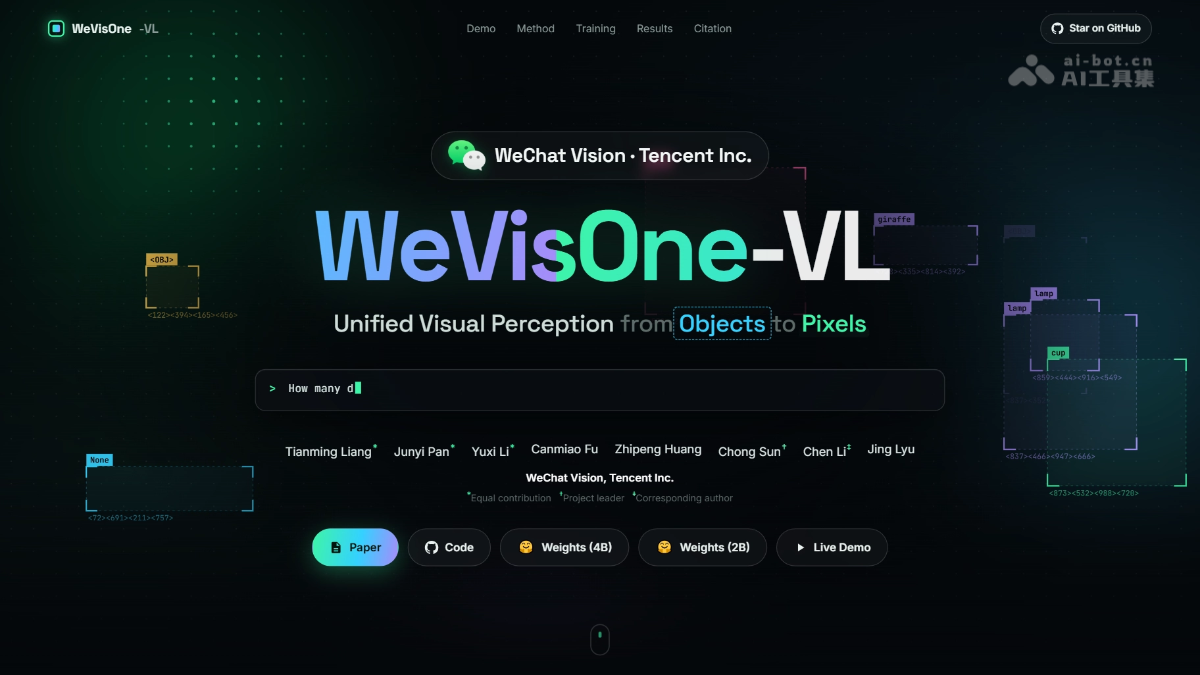
WeVisOne-VL Tencent WeChat کی بصری ٹیم کا اوپن سورس وژوئل-لینگویج بنیادی ماڈل ہے، جو Qwen3-VL پر مبنی ہے اور 2B اور 4B کے دو ورژنز فراہم کرتا ہے۔ WeVisOne-VL متحدہ ساختی token پیش گوئی کے طریقے سے ایک ہی ماڈل کے ذریعے detection، referring localization، counting، pointing، OCR، referring segmentation اور promptable matting سمیت سات کام انجام دیتا ہے۔ صرف 960 لاکھ پیرامیٹرز والے pixel decoder کے ذریعے یہ براہِ راست mask یا بالوں کی سطح کی matting آؤٹ پٹ کرتا ہے، اس کے لیے SAM کی اضافی تنصیب درکار نہیں۔ WeVisOne-VL کی تربیتی ڈیٹا میں 1 کروڑ سے زیادہ تصاویر اور تقریباً 36 کروڑ bounding boxes شامل ہیں۔ تین مراحل کی curriculum fine-tuning اور reinforcement learning کے بعد یہ 30 سے زیادہ benchmarks پر ہم پلہ ماڈلز سے آگے ہے۔
02WeVisOne-VL کے اہم افعال
آبجیکٹ detection: ”تمام کتوں کو تلاش کریں“ جیسی ہدایات کے مطابق تصویر میں موجود تمام آبجیکٹ باکس براہِ راست آؤٹ پٹ کر سکتا ہے۔
Referring localization: ”سرخ کپڑے پہنے شخص“ جیسی قدرتی زبان کی تفصیل کے مطابق تصویر میں موجود مخصوص آبجیکٹ کو شناخت کر سکتا ہے۔
Counting: تصویر میں مخصوص قسم کے کتنے آبجیکٹس ہیں، اس کا جواب دیتا ہے۔
Pointing: ”وہ کپ“ جیسی اشارتی تفصیل سمجھ کر اشارہ کیے گئے آبجیکٹ کو تلاش کرتا ہے۔
OCR: تصویر میں موجود متن پڑھ کر اس کی جگہ نشان زد کرتا ہے۔
Referring segmentation: آبجیکٹ کے کناروں کے ساتھ پکسل بہ پکسل خاکہ بناتا اور binary mask آؤٹ پٹ کرتا ہے۔
Promptable matting: مسلسل alpha channel آؤٹ پٹ کرتا ہے؛ بالوں جیسی نیم شفاف تفصیلات قدرتی طور پر برقرار رہتی ہیں اور پس منظر براہِ راست تبدیل کیا جا سکتا ہے۔
03WeVisOne-VL کے تکنیکی اصول
WeChat پر ”开源“ لکھ کر بھیجیں اور AI اوپن سورس پروجیکٹ گروپ میں شامل ہوں۔
کوآرڈینیٹس بطور token ساختی آؤٹ پٹ: ماڈل کوآرڈینیٹس کو 1001 خصوصی tokens میں discretize کرتا ہے؛ ایک باکس میں عین 4 tokens اور ایک نقطے میں 2 tokens ہوتے ہیں۔ Detection boxes، متن کی جگہ اور pixel masks ایک ہی vocabulary سے ظاہر کیے جاتے ہیں، پھر structured next-token prediction کے ذریعے متحدہ طور پر پیدا کیے جاتے ہیں۔ کام بدلنے کے لیے صرف prompt کا سابقہ بدلا جاتا ہے؛ ہدف موجود نہ ہو تو براہِ راست None آؤٹ پٹ ہوتا ہے۔
اندرونی pixel decoder، SAM cascade کی جگہ: Qwen3-VL backbone کے باہر صرف 960 لاکھ پیرامیٹرز پر مشتمل ایک چھوٹا ماڈیول منسلک ہے۔ Visual feature adapter backbone کے pre-merge سے پہلے کی چار ViT layers کی خصوصیات لے کر deep convolution کے ذریعے انہیں مشترکہ feature pyramid میں refine کرتا ہے۔ ہر token کی hidden state، Fourier encoding والے box prior کے ساتھ مل کر instance query بناتی ہے، جسے 6 deformable cross-attention blocks بار بار refine کرتے ہیں۔ آخر میں instance-conditioned dense head پہلے dynamic convolution kernels سے mask کی پیش گوئی کرتا ہے، پھر S/4→S/2→S/1 coarse-to-fine cascade کے ذریعے بالوں کی سطح کا مکمل ریزولوشن alpha matte بحال کرتا ہے۔ پورے عمل میں SAM یا کسی بیرونی segmentation model پر انحصار نہیں کیا جاتا۔
Curriculum training اور mixed-task reinforcement learning: pretraining کے بعد بالترتیب task alignment، high-resolution اور dense-scene، اور pixel-level کے تین SFT مراحل سے گزرتا ہے۔ آخر میں 178K uncertainty-filtered samples کے ذریعے mixed-task GRPO reinforcement learning کی جاتی ہے۔ اس سے باکس زیادہ درست اور hallucination کم ہوتی ہے۔ ”تصویر میں ہدف نہ ہو پھر بھی باکس بنانا“ اور ”تصویر میں ہدف ہو مگر باکس چھوڑ دینا“ جیسی غلطیوں پر خصوصی سزا دی جاتی ہے، جس سے عدم شناخت کی صلاحیت اور ہدف موجود ہونے کی صورت میں localization accuracy بیک وقت بہتر ہوتی ہے۔
Knowledge graph سے چلنے والا data engine: categories اور referring expressions کے knowledge graph کے ذریعے ہدفی data collection کی جاتی ہے۔ SAM3 اور اندرونی DINO detector candidate boxes تیار کرتے ہیں، Qwen3-VL ان کی درستگی کی cross-validation کرتا ہے، SAM2 انہیں masks میں توسیع دیتا ہے، جبکہ BiRefNet اور MatAnyone2 مسلسل alpha candidates تیار کرتے ہیں۔ Samples کو قبول کیے جانے سے پہلے IoU، coverage اور foreground accuracy سمیت متعدد جانچوں سے گزرنا ہوتا ہے، جبکہ کچھ samples کی انسانی طور پر random checking بھی کی جاتی ہے۔ ماڈل کی غلطیاں اگلے filtering cycle میں واپس شامل ہوتی ہیں۔ یوں 1 کروڑ سے زیادہ تصاویر اور تقریباً 36 کروڑ target boxes کو annotate کر کے خود کو بہتر بنانے والا annotation loop تشکیل دیا گیا ہے۔
04WeVisOne-VL کا استعمال کیسے کریں
کوڈ حاصل کریں: GitHub سے Tencent/WeVisOne-VL repository clone کریں اور README کے مطابق dependencies اور environment انسٹال کریں۔
ماڈل تیار کریں: Hugging Face سے WeVisOne-VL-2B یا WeVisOne-VL-4B weights ڈاؤن لوڈ کریں۔
Task prompt بنائیں: task کے مطابق prompt میں ضرورت واضح کریں، مثلاً detection کے لیے ”Locate all the instances of …“، referring localization کے لیے ہدف کی تفصیل، اور matting کے لیے alpha آؤٹ پٹ کی ہدایت۔ موجودہ annotations کو 、、 جیسے ساختی tags کے ذریعے بھی منتقل کیا جا سکتا ہے۔
Inference چلائیں: repository کے فراہم کردہ model.predict() interface کے ذریعے تصویر اور prompt ماڈل کو دیں؛ سرکاری demonstration بھی یہی interface استعمال کرتی ہے۔
آؤٹ پٹ parse کریں: ماڈل نتائج token بہ token تیار کرتا ہے۔ کوآرڈینیٹس کو <0>–<1000> خصوصی tokens سے normalized coordinates میں بحال کیا جاتا ہے، pixel decoder کو متحرک کر کے mask یا alpha آؤٹ پٹ حاصل کیا جاتا ہے، جبکہ ہدف موجود نہ ہو تو None واپس آتا ہے۔
Post-processing: boxes، masks یا matting نتائج کو اصل تصویر کے سائز پر map کریں؛ انہیں retrieval، annotation، پس منظر تبدیل کرنے اور دیگر downstream tasks میں استعمال کیا جا سکتا ہے۔
05WeVisOne-VL کے بنیادی فوائد
قابلِ اعتماد عدم شناخت: تصویر میں ہدف نہ ہو تو ”موجود نہیں“ کہنے کی صلاحیت رکھتا ہے اور زبردستی جواب نہیں بناتا، جس سے visual perception مرحلے میں hallucination نمایاں طور پر کم ہوتی ہے۔
ایک ماڈل، متعدد کام: detection، referring localization، counting، pointing، OCR، segmentation اور matting کے ساتوں کام ایک ہی ماڈل میں مشترک ہیں۔ صرف prompt بدلنا پڑتا ہے، اس لیے متعدد ماڈلز کو جوڑنے، deploy کرنے اور برقرار رکھنے کی لاگت کم ہوتی ہے۔
SAM کی اضافی تنصیب نہیں: اندرونی 960 لاکھ پیرامیٹرز والا pixel decoder براہِ راست mask اور بالوں کی سطح کی matting آؤٹ پٹ کرتا ہے، اور ”detector+SAM+matting model“ کی تین مرحلوں والی cascade کی جگہ لیتا ہے، جس سے inference chain مختصر ہو جاتی ہے۔
درستگی اور باریک تفصیل دونوں: 1 کروڑ تصاویر اور 36 کروڑ boxes کی وسیع annotation، curriculum training اور mixed-task reinforcement learning کے باعث یہ 30 سے زیادہ benchmarks پر عمومی VLMs اور خصوصی ماڈلز دونوں سے آگے ہے، جبکہ matting کا MAD تقریباً نصف رہ جاتا ہے۔
اوپن سورس اور قابلِ تعیناتی: 2B اور 4B دونوں ورژنز کے weights، code اور toolchain مکمل طور پر دستیاب ہیں، Apache 2.0 license کے تحت۔ اسے ویب پر آزمایا یا مقامی طور پر چلایا جا سکتا ہے، اس لیے چھوٹی ٹیموں کے لیے موزوں ہے۔
06WeVisOne-VL کا پروجیکٹ ایڈریس
پروجیکٹ کی سرکاری ویب سائٹ: https://tencent.github.io/WeVisOne-VL/
GitHub repository: https://github.com/Tencent/WeVisOne-VL
HuggingFace model collection: https://huggingface.co/collections/tencent/wevisone-vl
arXiv تکنیکی مقالہ: https://arxiv.org/pdf/2610.31329
07WeVisOne-VL کے استعمال کے منظرنامے
مواد کی جانچ اور سکیورٹی detection: ”موجود نہیں“ کہنے کی صلاحیت کے ذریعے تصویر میں موجود خلاف ورزی کرنے والی اشیا کو درست طور پر تلاش کرتا ہے۔ نہ ملنے پر واضح طور پر عدم موجودگی واپس کرتا ہے، جس سے جائزے سے رہ جانے اور غلط مثبت نتائج کم ہوتے ہیں، اور WeChat کے content ecosystem کی moderation ضروریات پوری ہوتی ہیں۔
ای کامرس مصنوعات کی matting: پروڈکٹ تصویر دے کر بالوں کی سطح کا alpha matte براہِ راست آؤٹ پٹ کرتا ہے، جس سے ایک کلک میں سفید پس منظر والی تصویر یا نیا پس منظر والا پوسٹر بنایا جا سکتا ہے۔ دستی image editing اور متعدد ماڈلز کی pipeline کی جگہ لیتا ہے۔
دستاویز اور رسیدوں کی ساختی کاری: OCR اور جگہ کی معلومات کے ذریعے invoices، contracts اور forms کو کوآرڈینیٹس والے structured data میں تبدیل کرتا ہے، جس سے خودکار data entry اور reconciliation ممکن ہوتی ہے۔
Data annotation اور retrieval augmentation: referring localization اور segmentation کے ذریعے boxes اور masks والے annotation data کی بڑی مقدار تیار کی جا سکتی ہے، یا text-to-image retrieval کے دوران پوری تصویر کے بجائے درست target region واپس کیا جا سکتا ہے، جو downstream model training اور retrieval میں مدد دیتا ہے۔
روبوٹ اور خودکار ڈرائیونگ کی perception: edge deployment کے ذریعے ماحول کو سمجھنے اور targets کو operate کرنے میں استعمال ہوتا ہے۔ عدم شناخت کا mechanism ”ہوا کو رکاوٹ سمجھنے“ والی hallucination سے بچاتا اور کام کی safety بہتر بناتا ہے۔
© دستبرداری: ڈومینز اور لنک شدہ مواد وقت کے ساتھ تبدیل ہو سکتے ہیں۔ AIEZZ فریقِ ثالث کی ویب سائٹس کو کنٹرول نہیں کرتا۔ بیرونی مواد اور خطرات کا آزادانہ جائزہ لیں۔
صارف کے جائزے0