
- ماہانہ وزٹس
- 0
- قیمتیں
- متعین نہیں
- فہرست میں شامل
- —
- اپ ڈیٹ شدہ
- 2026-11-09
01VeriSpoof کیا ہے؟
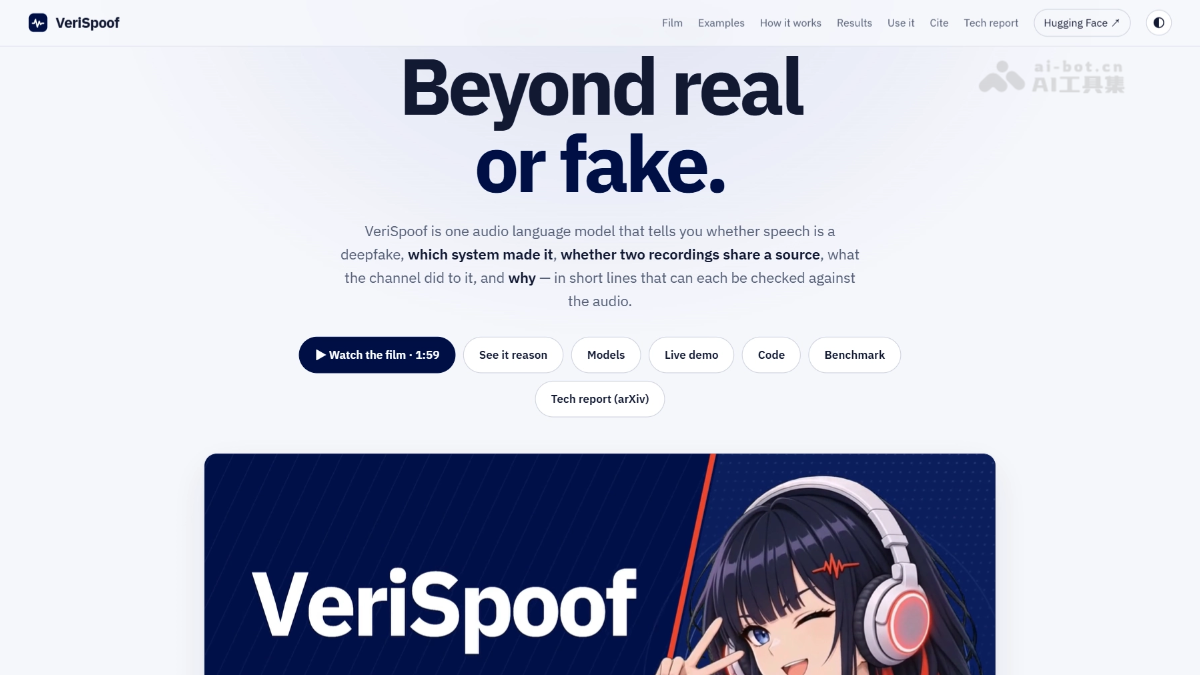
VeriSpoof یونیورسٹی آف میلبورن کا تیار کردہ اوپن سورس آڈیو بڑے ماڈل ہے، جس کے 2.85B پیرامیٹرز کو صرف 29.7M پر تربیت دی گئی ہے۔ VeriSpoof صوتی جعل سازی کی فرانزک جانچ کو ماڈل سے سوال کرنے کے عمل میں یکجا کرتا ہے؛ ایک ہی وزن کے ذریعے اصلیت کی جانچ، نظام کا سراغ، ماخذ کی تصدیق، چینل کی شناخت اور قابلِ تصدیق، شواہد پر مبنی استدلالی جانچ مکمل کی جاتی ہے۔ Speech-DF-Arena پر مجموعی EER 2.14% ہے، 28 نظاموں میں تیسرے نمبر پر اور اوپن سورس ماڈلز میں پہلے نمبر پر ہے۔
02VeriSpoof کے اہم افعال
اصلیت کی جانچ: یہ تعین کرتا ہے کہ ریکارڈنگ انسانی آواز ہے یا AI سے تیار کردہ؛ اسکور ”جعل سازی/انسانی آواز“ کے دو جوابی جملوں کے log-likelihood کے فرق سے حاصل ہوتا ہے۔ Speech-DF-Arena پر مجموعی EER 2.14% اور اوپن سورس ماڈلز میں پہلے نمبر پر ہے۔
جنریشن سسٹم کا سراغ: امیدوار TTS/VC نظاموں میں مخصوص جنریٹر کی شناخت کرتا ہے، اور اسے صوتی ماڈل، ووکوڈر اور دیگر تین سطحوں میں تقسیم کر کے الگ الگ فیصلہ کیا جا سکتا ہے۔ MLAAD میں دیکھے گئے جنریٹرز کی 12 زمروں میں درجہ بندی کی درستگی 96.8% ہے۔
ماخذ کی تصدیق: یہ تعین کرتا ہے کہ آیا دو ریکارڈنگز ایک ہی جنریشن سسٹم سے نکلی ہیں۔ تربیت میں نہ دیکھے گئے جنریٹرز کے جوڑوں پر EER 6.2% ہے، جو مخصوص ڈیٹیکٹر کی منجمد خصوصیات پر تربیت دیے گئے جوڑی والے پروب سے 77% کم ہے۔
ریکارڈنگ کی شرائط کی شناخت: آڈیو میں شور، بازگشت اور کوڈیک کی قسم کی شناخت کرتا ہے؛ Plus ورژن کی درستگی 81.3% ہے۔
قابلِ تصدیق استدلال: مشاہدے، چینل، مقام، ماخذ کا خاکہ اور نتیجے کے مقررہ خانوں میں استدلال پیش کرتا ہے۔ ہر سطر کو موجی پیمائش یا ڈیٹاسیٹ کی لیبلنگ سے جانچا جا سکتا ہے، اور ہر 0.16 سیکنڈ کے حساب سے جعل سازی والے حصے کا مقام بھی فراہم کرتا ہے؛ مقامی جعل سازی کی شناخت کی شرح 78.4% سے بڑھ کر 99.6% ہو جاتی ہے۔
03VeriSpoof کا تکنیکی اصول
WeChat پر فالو کر کے ”اوپن سورس“ کا جواب دیں اور AI اوپن سورس پروجیکٹ گروپ میں شامل ہوں۔
دوہری ریزولوشن والا آڈیو ٹوکنائزیشن: انکوڈر Qwen3-ASR-1.7B کے AuT انکوڈر کو استعمال کرتا ہے۔ 25 سطحی مخفی حالتوں کو قابلِ تعلم وزن کے ذریعے ملا کر ابتدا سے تربیت دیے گئے آڈیو ٹوکنائزر میں بھیجا جاتا ہے۔ ٹوکنائزر 16 مکمل جملے کے ٹوکن خارج کرتا ہے، جو ماخذ کی عالمی اور غیر متبدل معلومات رکھتے ہیں؛ 52 فریم ٹوکنز میں سے ہر ایک 0.16 سیکنڈ سے متعلق ہوتا ہے اور وقت کی معلومات محفوظ رکھتا ہے۔ ہر 0.8 سیکنڈ بعد فریموں کے درمیان متنی زمانی نشان داخل کیا جاتا ہے، تاکہ زبان کا ماڈل جعل سازی والے حصے کا مقام براہِ راست ”سیکنڈ“ کی اکائی میں بیان کر سکے۔
جواب ہی کو اسکور بنانا: زبان کا ماڈل MiniCPM5-2B ہے جس میں LoRA شامل ہے۔ تمام کاموں کا تربیتی ہدف اگلے token کی پیش گوئی ہے، اور کوئی کام مخصوص درجہ بندی کا ہیڈ موجود نہیں۔ جانچ کا اسکور جعل سازی اور انسانی جواب کے جملوں کے log-likelihood کا فرق، ماخذ کا اسکور yes اور no کا فرق، جبکہ کثیر الانتخاب سوال میں ہر امیدوار جواب کے جملے کا اسکور لے کر زیادہ سے زیادہ قدر ہوتا ہے۔
تین مرحلوں کا تربیتی طریقہ: ادراکی ہم آہنگی کے مرحلے میں زبان کے ماڈل کو منجمد رکھا جاتا ہے اور صرف ٹوکنائزر اور انکوڈر DoRA کو تربیت دی جاتی ہے، تاکہ آڈیو کا حصہ پہلے جعل سازی کے آثار محفوظ کرنا سیکھے۔ اس کے بعد زبان کے ماڈل میں LoRA شامل کر کے جنریٹر، صوتی ماڈل، ووکوڈر اور تین سطحوں کے جوڑی والے سوالات سمیت تمام فرانزک سوالات کی تربیت کی جاتی ہے۔ آخر میں کم تر learning rate کے ساتھ شواہد پر مبنی استدلال اور متضاد نمونے شامل کیے جاتے ہیں، جبکہ دوسرے مرحلے کے سوالات دوبارہ چلائے جاتے ہیں تاکہ ایک مرحلے میں جواب دینے کی صلاحیت کم نہ ہو۔
سگنل سے اخذ کردہ استدلالی ہدف: استدلالی متن مقررہ خانوں میں لکھا جاتا ہے، اور ہر قسم کے بیان کے لیے ایک ایسا چیکر موجود ہے جو ماڈل پر منحصر نہیں۔ مشاہدے کی سطر موج پر بینڈوڈتھ، SNR، لیول اور کلپنگ کی پیمائش سے ملائی جاتی ہے؛ چینل کی سطر ڈیٹا augmentation کے وقت ریکارڈ کی گئی شرائط سے؛ مقام کی سطر ڈیٹاسیٹ کی لیبلنگ سے؛ اور ماخذ کا خاکہ جنریٹر کے میٹا ڈیٹا سے۔ متضاد نمونوں میں مقام کو الٹ دیا جاتا ہے یا نیا حصہ داخل کیا جاتا ہے، جس سے نتیجہ بھی پلٹنا چاہیے؛ غیر متعلقہ خانوں کو بدلنے پر نتیجہ تبدیل نہیں ہونا چاہیے۔ یوں تربیتی سگنل کے ذریعے پابندی لگائی جاتی ہے کہ نتیجہ صرف اس بات پر منحصر ہو کہ ”کہاں مصنوعی آواز ہے“۔
04VeriSpoof کا استعمال کیسے کریں
کوڈ انسٹال کریں: hf download AustinXiao/VeriSpoof-Plus --include "code/*" --local-dir verispoof چلائیں، پھر推理 پیکیج انسٹال کرنے کے لیے pip install ./verispoof/code چلائیں۔
ماڈل لوڈ کریں: Python میں from verispoof import VeriSpoof، پھر model = VeriSpoof.from_pretrained("AustinXiao/VeriSpoof-Plus") چلا کر لوڈنگ مکمل کریں۔
اصلیت کی جانچ: model.detect("sample.wav") چلانے سے لیبل اور اسکور واپس ملتا ہے۔ جانچ کا اسکور اور ہر token کا مقام صرف ایک forward pass سے حاصل ہو جاتا ہے، متن تیار کرنے کی ضرورت نہیں۔
قابلِ تصدیق استدلال: model.explain("sample.wav") چلانے سے استدلالی متن، نتیجہ، مقامی حصے اور ہر token کے لیے ترکیب شدہ آواز کا امکان واپس ملتا ہے۔ مکمل استدلال vLLM backend کے ذریعے بیچ میں تیار کیا جا سکتا ہے؛ A100 پر ہر نمونے میں تقریباً 0.05 سیکنڈ لگتے ہیں۔
ماخذ کی تصدیق: model.same_source("a.wav", "b.wav", level="generator") چلا کر تعین کریں کہ دونوں ریکارڈنگز ایک ہی ماخذ سے ہیں یا نہیں۔ level کو acoustic_model یا vocoder بھی مقرر کیا جا سکتا ہے۔
شرائط کی شناخت اور سراغ: model.condition("sample.wav", attr="codec") کے ذریعے شور، بازگشت یا کوڈیک کی شناخت کریں، اور model.generator("sample.wav", ["XTTS-v2", "Bark", "VITS"]) کے ذریعے اپنی مرضی کی امیدوار فہرست میں جنریشن سسٹم کی شناخت کریں۔
05VeriSpoof کے بنیادی فوائد
اوپن سورس میں بہترین جانچ کارکردگی: Speech-DF-Arena پر مجموعی EER 2.14% ہے، 28 نظاموں میں تیسرے نمبر پر اور اوپن سورس وزنوں میں پہلے نمبر پر ہے۔ یہ واحد ایسا سرکردہ نظام بھی ہے جو کم لاگت سے دوبارہ تیار کرنے کا طریقہ فراہم کرتا ہے۔
پانچ ماڈلز کے بجائے متحدہ ساخت: ایک ہی وزن کے ذریعے جانچ، سراغ، ماخذ کی تصدیق، چینل کی شناخت اور استدلال کے پانچ کام مکمل ہوتے ہیں، اور کوئی کام مخصوص درجہ بندی کا ہیڈ موجود نہیں۔
اسکور ہی جواب ہے: تمام جانچ کے اسکور براہِ راست ماڈل کے جوابی جملے کے log-likelihood سے حاصل ہوتے ہیں۔ ایسی عدم مطابقت موجود نہیں کہ ”درجہ بندی کا ہیڈ مضبوط ہو مگر جواب سوال سے متعلق نہ ہو“؛ صارف جو نتیجہ دیکھتا ہے، اسکور بھی اسی آؤٹ پٹ کو کیا گیا ہے۔
استدلال قابلِ تصدیق ہے، تخلیقی گھڑت نہیں: استدلال مقررہ خانوں میں لکھا جاتا ہے، ہر سطر کو موجی پیمائش یا ڈیٹاسیٹ کی لیبلنگ سے جانچا جا سکتا ہے، اور متضاد تربیت یقینی بناتی ہے کہ نتیجہ صرف ”کہاں مصنوعی آواز ہے“ کے بدلنے پر بدلے۔ وفاداری کی شرح زیادہ سے زیادہ 100% ہے۔
عمومی صلاحیت کی سخت جانچ: نہ دیکھے گئے جنریٹرز پر ماخذ کی جانچ کا EER 6.2% ہے، جو مخصوص جوڑی والے پروب سے 77% کم ہے۔ مزید یہ کہ نہ دیکھے گئے جنریٹرز کو تربیتی ڈیٹا سے مکمل طور پر خارج کیا گیا ہے، اس لیے جانچ کا پروٹوکول صاف ہے۔
06VeriSpoof کا پروجیکٹ لنک
پروجیکٹ کی سرکاری ویب سائٹ: https://swagshaw.github.io/verispoof/
GitHub ریپوزٹری: https://github.com/swagshaw/verispoof
HuggingFace ماڈل ریپوزٹری: https://huggingface.co/collections/AustinXiao/verispoof
arXiv تکنیکی مقالہ: https://arxiv.org/pdf/2611.04634
07VeriSpoof کے اطلاق کے منظرنامے
میڈیا اور سوشل پلیٹ فارم کی جانچ: صارف کی اپ لوڈ کردہ آڈیو اور ”صوتی اسکرین شاٹ“ کے AI سے تیار کردہ ہونے کی جانچ، تاکہ کلون شدہ آواز سے بنائے گئے جعلی مواد کو روکنے میں مدد ملے۔
مالیاتی اور ٹیلی فون فراڈ سے تحفظ: کسٹمر سروس کالز اور رقم منتقل کرنے کی ہدایات کی ریکارڈنگ کی تصدیق کہ وہ انسانی آواز ہیں یا نہیں، تاکہ آواز کلون کر کے رشتہ دار یا اعلیٰ افسر بننے والے فراڈ سے بچا جا سکے۔
عدالتی فرانزک اور قانون نافذ کرنا: صوتی شواہد کی جانچ میں ہر سطر کی تصدیق کے قابل استدلالی رپورٹ فراہم کرنا، جس میں جعل سازی والے حصے کا مقام اور جنریشن سسٹم کے اشارے بیان ہوں، تاکہ انسانی دوبارہ جانچ میں مدد ملے۔
کال سینٹر شناخت کی تصدیق: یہ تعین کرنا کہ محفوظ شدہ ریکارڈنگ اور براہِ راست کال ایک ہی ماخذ سے ہیں یا نہیں اور آواز انسانی ہے یا نہیں، تاکہ مصنوعی آواز کے ذریعے وائس پرنٹ تصدیق کو نظرانداز کرنے کا خطرہ کم ہو۔
تحقیق اور ماڈل کی جانچ: اوپن سورس وزنوں میں مضبوط ترین جانچ کی بنیاد اور متحدہ فرانزک ماڈل کے طور پر، محققین VeriSpoof-Bench کے ذریعے اپنے ماڈلز کی جانچ اور قابو شدہ تقابلی تجربات کر سکتے ہیں۔
© دستبرداری: ڈومینز اور لنک شدہ مواد وقت کے ساتھ تبدیل ہو سکتے ہیں۔ AIEZZ فریقِ ثالث کی ویب سائٹس کو کنٹرول نہیں کرتا۔ بیرونی مواد اور خطرات کا آزادانہ جائزہ لیں۔
صارف کے جائزے0