
- ماہانہ وزٹس
- 0
- قیمتیں
- متعین نہیں
- فہرست میں شامل
- —
- اپ ڈیٹ شدہ
- 2026-09-24
01Qwen-Audio-3.1 کیا ہے
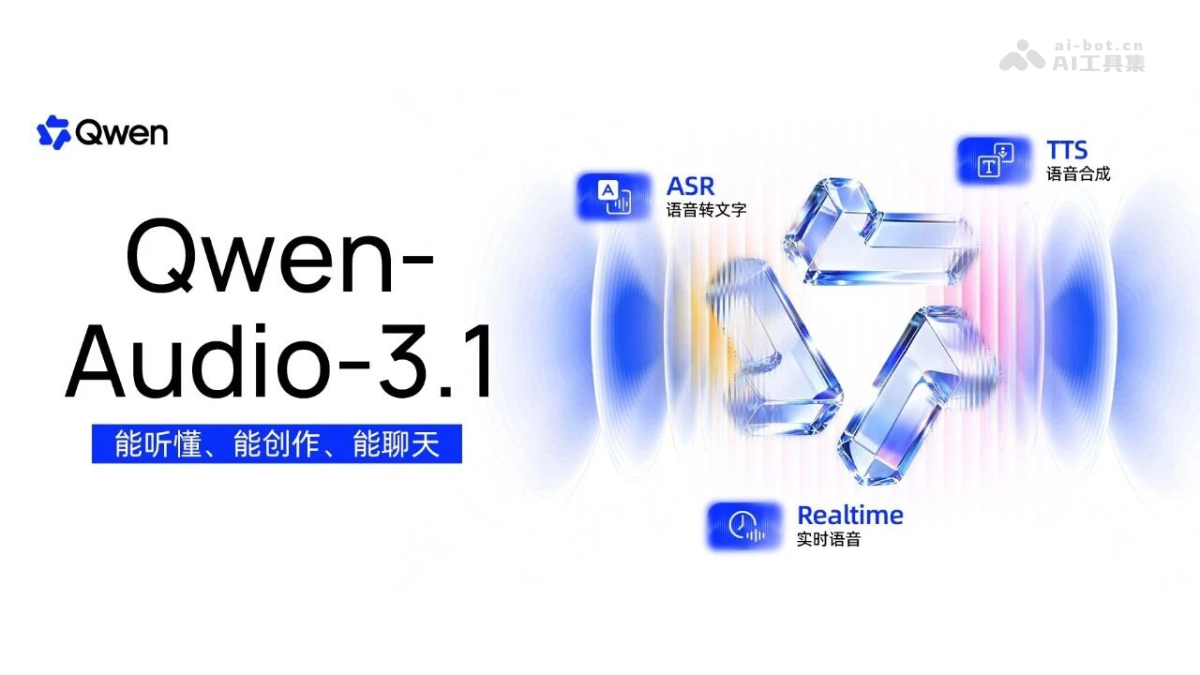
Qwen-Audio-3.1، ٹونگیی چیانوین کی جانب سے پیش کردہ بڑے صوتی ماڈلز کا سلسلہ ہے، جس میں پانچ ماڈلز شامل ہیں: ASR صوتی شناخت، ASR-Next آڈیو فہم، TTS صوتی ترکیب، TTS-Next آڈیو تخلیق، اور Realtime حقیقی وقت میں تعامل۔ یہ فہم، تخلیق، تعامل اور تخلیق کے پورے سلسلے کا احاطہ کرتا ہے۔ Qwen-Audio-3.1 30 زبانوں اور 16 چینی لہجوں کو سپورٹ کرتا ہے، بولنے والوں کے لحاظ سے نقل، جذبات کی شناخت اور مکمل دو طرفہ حقیقی وقت کی گفتگو فراہم کرتا ہے، اور کام مکمل کرنے کے لیے ٹولز استعمال کر سکتا ہے۔
02Qwen-Audio-3.1 کی اہم خصوصیات
ASR صوتی شناخت: 30 زبانوں اور 16 چینی لہجوں میں بولنے والوں کے لحاظ سے نقل کی سہولت، بولنے والے کے لیبلز اور ٹائم اسٹیمپس کے ساتھ؛ متن کو براہِ راست بہتر بھی بنا سکتا ہے۔
ASR-Next آڈیو فہم: نقل شدہ متن سے آگے بڑھ کر انسانی جذبات، ماحولیاتی آوازوں اور مشینی آوازوں کو سمجھتا ہے، اور آواز کی وضاحت، واقعات کے مقام کا تعین اور آڈیو سوال و جواب سپورٹ کرتا ہے۔
TTS صوتی ترکیب: متعدد زبانوں اور لہجوں میں ترکیب، ایک ہی آواز کو مختلف زبانوں میں قدرتی انداز سے منتقل کرنا، اور ہدایات کے ذریعے جذبات و رفتار کو کنٹرول کرنا۔
TTS-Next آڈیو تخلیق: انسانی آواز، صوتی اثرات اور ماحولیاتی آوازوں پر مشتمل مکمل آڈیو ایک ہی بار میں تیار کرتا ہے، جو پوڈکاسٹ، آڈیو بکس، فلم و ٹی وی، گیمز اور اشتہارات کے لیے موزوں ہے۔
Realtime حقیقی وقت میں تعامل: بیک وقت سننے اور بولنے والا مکمل دو طرفہ تعامل، جذبات اور ارادے کی سمجھ، کثیر لسانی سوئچنگ، اور گفتگو کے دوران کام مکمل کرنے کے لیے ٹولز کا استعمال۔
03Qwen-Audio-3.1 کے تکنیکی اصول
اینڈ ٹو اینڈ مشترکہ ماڈلنگ (ASR): Qwen-Audio-3.1-ASR اینڈ ٹو اینڈ طریقہ استعمال کرتا ہے اور بولنے والے کے لیبلز، ٹائم اسٹیمپس اور نقل شدہ متن کو مشترکہ طور پر آؤٹ پٹ کرتا ہے، روایتی مربوط نظام کی مرحلہ وار پروسیسنگ کے بجائے۔ اس طرح مختصر مداخلتی جملے اور ایک دوسرے پر چڑھتی آوازیں محفوظ رہتی ہیں؛ ماڈل میں تکلمی الفاظ حذف کرنے، تکرار ختم کرنے، خود اصلاح اور معنوی تنظیم نو کی صلاحیتیں بھی شامل ہیں، جس سے نقل کا نتیجہ ساختی طور پر براہِ راست میٹنگ ریکارڈ اور گفتگو کے تجزیے میں استعمال ہو سکتا ہے۔
اگلی نسل کا آڈیو فہم کا ڈھانچہ (ASR-Next): ASR-Next اگلی نسل کے ڈھانچے پر مبنی ہے، جو پروسیسنگ کے موضوع کو ”آواز میں موجود الفاظ“ سے بڑھا کر مکمل آڈیو سگنل تک لے جاتا ہے۔ صوتی سطح پر جذبات، ماحولیاتی آوازوں اور مشینی آوازوں کو سمجھ کر یہ صوتی واقعات کے مقام کا تعین، وضاحت اور استدلال مکمل کرتا ہے، جو ASR کے نقل کے آلے سے عمومی آڈیو فہم کے ماڈل میں ارتقا کی علامت ہے۔
آواز کی منتقلی اور اظہار کا کنٹرول (TTS): TTS ماڈل صرف درست تلفظ پر توجہ دینے والی روایتی ترکیب سے آگے بڑھتا ہے۔ یہ ایک ہی آواز میں مختلف زبانوں اور لہجوں کے درمیان قدرتی منتقلی ممکن بناتا ہے، اور ہدایات کے ذریعے جذبات، رفتار اور اظہار کے انداز کی ماڈلنگ کرتا ہے، تاکہ ترکیبی آواز مواد اور منظرنامے سے ہم آہنگ رہے۔
متحدہ آڈیو تخلیق (TTS-Next): TTS-Next متن، ٹائم اسٹیمپس اور حوالہ جاتی آڈیو، ان تین اقسام کے ان پٹ کی بنیاد پر انسانی آواز، صوتی اثرات اور ماحولیاتی آوازیں یکجا تخلیق کرتا ہے؛ کثیر مرحلہ گفتگو میں مختلف کرداروں کی آواز اور جذبات کو یکساں رکھتا ہے، اور قدرتی زبان کے ذریعے تخلیق کے عمل کو کنٹرول کرتا ہے۔ یہ باریک سطح کے ٹائم اسٹیمپ کنٹرول، آواز کی نقل اور 48kHz ہائی فائی آؤٹ پٹ سپورٹ کرتا ہے۔
متعدد استادوں سے ڈسٹلیشن پر مبنی مکمل دو طرفہ ڈھانچہ (Realtime): Realtime متعدد استادوں سے ڈسٹلیشن کا ڈھانچہ استعمال کرتا ہے، جو کم تاخیر برقرار رکھتے ہوئے فہم، استدلال، اظہار اور سلامتی کی صلاحیتوں کو بہتر بناتا ہے۔ یہ مکمل دو طرفہ تعامل، بیک وقت بولنے اور سننے، اور کسی بھی وقت مداخلت کی سہولت فراہم کرتا ہے؛ ماڈل ٹول کالنگ کی صلاحیت بھی یکجا کرتا ہے، مسلسل گفتگو میں بدلتی ہوئی ضروریات کو سمجھ سکتا ہے، اور کام مکمل کرنے کے لیے بیرونی API، نالج بیس اور کاروباری نظام سے جڑ سکتا ہے۔
04Qwen-Audio-3.1 کا استعمال کیسے کریں
چیانوین AI پلیٹ فارم کھولیں: https://www.qianwenai.com/ پر جائیں، اکاؤنٹ میں لاگ اِن کریں اور ماڈل مارکیٹ میں داخل ہوں۔
مطلوبہ ماڈل منتخب کریں: ضرورت کے مطابق متعلقہ ماڈل منتخب کریں، ASR (نقل)، TTS (ترکیب)، TTS-Next (تخلیق) یا Realtime (حقیقی وقت میں تعامل)، پھر تفصیلات کا صفحہ کھولیں۔
API Key حاصل کریں: کنسول میں ماڈل سروس فعال کریں اور انٹرفیس کی توثیق کے لیے API Key بنائیں۔
انٹرفیس کال کریں: ہر ماڈل کے تفصیلاتی صفحے کی API دستاویزات دیکھیں اور HTTP درخواست کے ذریعے آڈیو یا متن کے پیرامیٹرز بھیجیں (ASR-Next API ابھی جاری نہیں ہوئی، دستیابی کا انتظار کرنا ہوگا)۔
ایپ میں انضمام کریں: انٹرفیس کو اپنی ایپ، Agent یا اسمارٹ ہارڈویئر سے منسلک کریں، اس کے بعد صوتی کام آن لائن مکمل کیے جا سکتے ہیں۔
05Qwen-Audio-3.1 کے بنیادی فوائد
کثیر لسانی اور لہجوں کی مضبوط صلاحیت: ایک ہی ماڈل 30 زبانوں اور 16 چینی لہجوں کو سپورٹ کرتا ہے، اور وینژو لہجے جیسے مشکل لہجوں کی شناخت میں نمایاں بہتری فراہم کرتا ہے۔
ذہین طور پر بہتر نقل: ASR تکلمی الفاظ حذف کرنے، تکرار ختم کرنے اور معنوی تنظیم نو کو مقامی طور پر مکمل کرتا ہے، جس سے زیادہ رواں، منطقی اور ساختہ متن آؤٹ پٹ ہوتا ہے۔
بولنے والوں کے لحاظ سے اعلیٰ درستگی والی نقل: بولنے والے کے لیبلز، ٹائم اسٹیمپس اور متن کو اینڈ ٹو اینڈ آؤٹ پٹ کرتا ہے، اور Fun-ASR کے مربوط نظام سے مجموعی طور پر بہتر ہے۔
آڈیو فہم میں升级: ASR-Next جذبات، ماحولیاتی آوازوں اور مشینی آوازوں کو سمجھتا ہے، اور ”نقل شدہ متن“ سے ”مکمل آڈیو کی سمجھ“ تک ترقی کرتا ہے۔
تخلیقی صلاحیتوں کا انضمام: TTS-Next انسانی آواز، صوتی اثرات اور ماحولیاتی آوازیں ایک ہی بار میں تیار کرتا ہے، مختلف کرداروں کی آواز اور جذبات میں یکسانیت رکھتا ہے، اور متعدد افراد پر مشتمل پوسٹ پروڈکشن کے عمل کی جگہ لے سکتا ہے۔
انسانی سطح کا حقیقی وقت میں تعامل: مکمل دو طرفہ سننا اور بولنا، مداخلت کی سہولت، جذبات کی شناخت اور کام مکمل کرنے کے لیے ٹولز کا استعمال۔
کم تاخیر، اعلیٰ کارکردگی: اسٹریمنگ شناخت میں پہلے حرف کا جواب تقریباً 160 ملی سیکنڈ میں ملتا ہے، جبکہ Realtime متعدد استادوں سے ڈسٹلیشن کی بنیاد پر کم تاخیر اور استدلالی صلاحیت دونوں برقرار رکھتا ہے۔
06Qwen-Audio-3.1 کا پروجیکٹ لنک
آن لائن ڈیمو: Qwen-Audio-3.1-ASR:https://www.qianwenai.com/models/qwen-audio-3.1-asr-flash
Qwen-Audio-3.1-TTS:https://www.qianwenai.com/models/qwen-audio-3.1-tts-flash
Qwen-Audio-3.1-TTS-Next:https://www.qianwenai.com/models/qwen-audio-3.1-tts-next
Qwen-Audio-3.1-Realtime:https://www.qianwenai.com/models/qwen-audio-3.1-realtime-plus
07Qwen-Audio-3.1 کے اطلاقی منظرنامے
میٹنگ کے خلاصے اور انٹرویو ریکارڈ: ASR کی بولنے والوں کے لحاظ سے نقل اور ٹائم اسٹیمپ کی خصوصیات استعمال کر کے ”کس نے کب کیا کہا“ پر مشتمل ساختہ ریکارڈ خودکار طور پر تیار کریں۔ تکلمی غیر ضروری عناصر کو مقامی طور پر بہتر بنا کر ہٹایا جاتا ہے، جس سے میٹنگ کی کارکردگی میں نمایاں اضافہ ہوتا ہے۔
پوڈکاسٹ اور آڈیو بکس کی تخلیق: TTS-Next کے ذریعے متعدد افراد کے مکالموں، صوتی اثرات اور ماحولیاتی آوازوں پر مشتمل مکمل آڈیو ایک ہی بار میں تیار کریں۔ مختلف کرداروں کی آواز اور جذبات یکساں رہتے ہیں، جس سے میزبان، صوتی اثرات کے ماہر اور مکسر کے درمیان تقسیمِ کار کی ضرورت کم ہو جاتی ہے۔
حقیقی وقت میں صوتی کسٹمر سروس/ذہین معاون: Realtime کے مکمل دو طرفہ تعامل اور جذباتی فہم کی بنیاد پر ایسا صوتی کسٹمر سروس نظام بنائیں جس میں مداخلت کی جا سکے اور جو ہمدردانہ ردعمل دے۔ یہ گفتگو کے دوران کاروباری نظام کو کال کر کے استفسار، آرڈر دینے جیسے کام بھی مکمل کر سکتا ہے۔
بین الاقوامی سفر اور کثیر لسانی رابطہ: 30 زبانوں میں حقیقی وقت کی سوئچنگ اور ایک ہی آواز کو مختلف زبانوں میں ترکیب کرنے کی صلاحیت کے ذریعے سفری منصوبہ بندی، سرحد پار ای کامرس اور بین الاقوامی کانفرنسوں کے لیے قدرتی اور رواں صوتی ترجمہ و رابطے کا تجربہ فراہم کریں۔
AI اسمارٹ ہارڈویئر: QwenNote، چیانوین AI اسمارٹ چشموں اور دیگر ہارڈویئر کے ساتھ انضمام کے ذریعے صارف کمپیوٹر یا موبائل کھولے بغیر براہِ راست آواز سے کام شروع کر سکتا ہے، شرائط شامل کر سکتا ہے اور پیش رفت دیکھ سکتا ہے، یوں آواز AI ہارڈویئر کا قدرتی داخلی راستہ بن جاتی ہے۔
© دستبرداری: ڈومینز اور لنک شدہ مواد وقت کے ساتھ تبدیل ہو سکتے ہیں۔ AIEZZ فریقِ ثالث کی ویب سائٹس کو کنٹرول نہیں کرتا۔ بیرونی مواد اور خطرات کا آزادانہ جائزہ لیں۔
صارف کے جائزے0