
- ماہانہ وزٹس
- 0
- قیمتیں
- متعین نہیں
- فہرست میں شامل
- —
- اپ ڈیٹ شدہ
- 2026-09-14
01Xiaomi-CocktailASR-1 کیا ہے؟
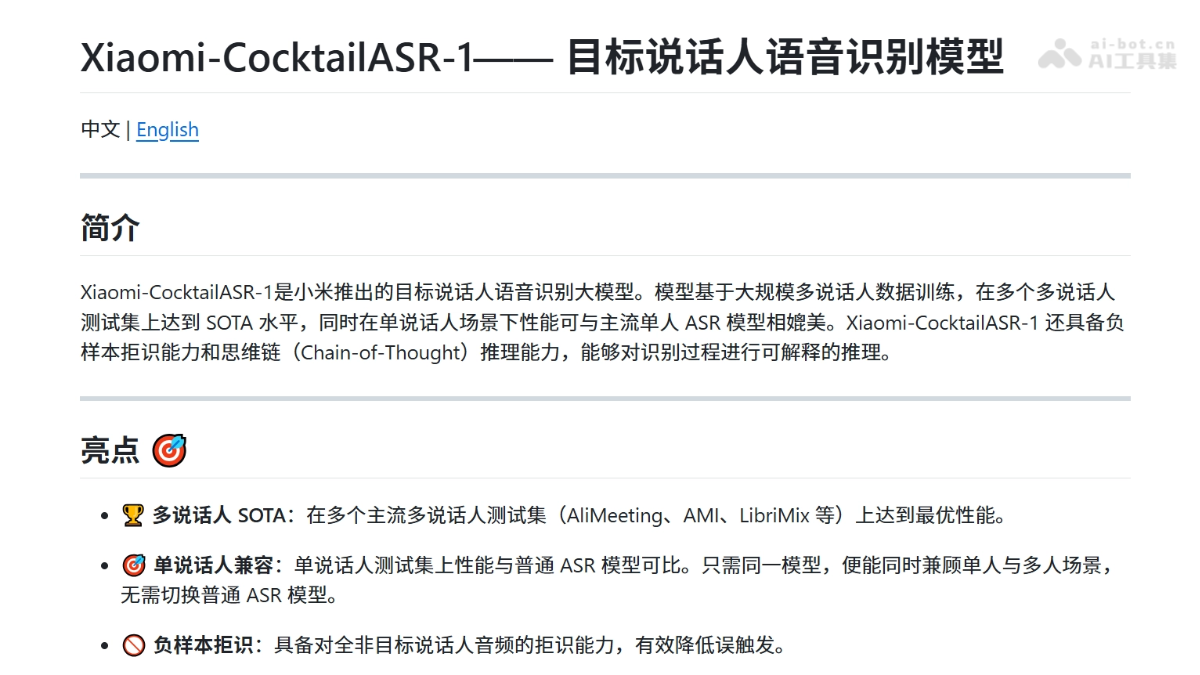
Xiaomi-CocktailASR-1 ژیاؤمی کا اوپن سورس ٹارگٹ اسپیکر اسپیچ ریکگنیشن کا بڑا ماڈل ہے۔ یہ LLM اینڈ ٹو اینڈ معماری پر مبنی ہے اور حوالہ جاتی آواز کو اسپیکر ایمبیڈنگ پرامپٹ کے طور پر استعمال کرتا ہے، اس لیے اسپیچ سیپریشن کے بغیر متعدد افراد کی ملی جلی آواز میں سے مطلوبہ اسپیکر کی گفتگو درست طور پر تحریر میں تبدیل کی جا سکتی ہے۔ یہ ماڈل متعدد اسپیکرز کے بینچ مارکس پر SOTA کارکردگی حاصل کرتا ہے، جبکہ ایک اسپیکر کے منظرناموں سے بھی مطابقت رکھتا ہے۔ اس میں منفی نمونوں کو مسترد کرنے اور چین آف تھاٹ کے ذریعے قابلِ تشریح استدلال کی صلاحیت موجود ہے، اور یہ Apache 2.0 لائسنس کے تحت اوپن سورس ہے۔
02Xiaomi-CocktailASR-1 کی اہم خصوصیات
ٹارگٹ اسپیکر اسپیچ ریکگنیشن: حوالہ جاتی آواز اور متعدد اسپیکرز کی ملی جلی آڈیو فراہم کرنے پر، اسپیچ سیپریشن کے بغیر براہِ راست مطلوبہ اسپیکر کی گفتگو تحریر میں تبدیل کرتا ہے۔
ایک اسپیکر سے مطابقت: یہی ماڈل ایک اسپیکر کے منظرناموں کو بھی سنبھال سکتا ہے اور معروف سنگل اسپیکر ASR کے برابر کارکردگی دیتا ہے؛ ماڈل تبدیل کرنے کی ضرورت نہیں۔
منفی نمونوں کا اخراج: جب مطلوبہ اسپیکر آڈیو میں موجود نہ ہو تو خالی متن آؤٹ پٹ کرتا ہے، جس سے غلط ایکٹیویشن کم ہوتی ہے۔
چین آف تھاٹ استدلال: CoT موڈ اسپیکرز کی تعداد، جنس، اسپیکر ایمبیڈنگ کی مماثلت اور دیگر استدلالی مراحل آؤٹ پٹ کرتا ہے، یوں قابلِ تشریحیّت اور شناخت کی درستگی دونوں برقرار رہتی ہیں۔
03Xiaomi-CocktailASR-1 کا تکنیکی اصول
اینڈ ٹو اینڈ متحدہ معماری: ماڈل تین حصوں پر مشتمل ہے: Data2Vec2 کی بنیاد پر بہتر بنایا گیا 0.6B آڈیو انکوڈر، ہلکا پھلکا لکیری Adapter، اور Qwen3-8B بڑا زبان ماڈل۔ ان پٹ کو «حوالہ جاتی آواز + 1 سیکنڈ خاموشی + ملی جلی آواز» کی ترتیب سے جوڑا جاتا ہے۔ انکوڈر فریم سطح کی خصوصیات پیدا کرنے کے بعد Adapter کے ذریعے انہیں LLM کی پوشیدہ اسپیس کے ساتھ ہم آہنگ کرتا ہے، پھر متن Prompt کے ساتھ مل کر LLM میں بھیجتا ہے تاکہ مطلوبہ اسپیکر کی گفتگو تحریر کی جا سکے۔
حوالہ جاتی آواز بطور مشروط پرامپٹ: انکوڈر Data2Vec2 کے خود زیرِ نگرانی ماسک پیش گوئی کے طریقۂ کار کے ذریعے ایک ہی نیٹ ورک میں معنوی اور اسپیکر سے متعلق معلومات کو یکجا کرتا ہے، اس لیے علیحدہ اسپیکر انکوڈر کی ضرورت نہیں رہتی۔ حوالہ جاتی آواز کو مشروط Prompt سمجھا جاتا ہے، جس سے انکوڈر خصوصیات نکالتے وقت ہی مطلوبہ اسپیکر پر توجہ مرکوز اور مداخلتی آواز کو دبانا سیکھتا ہے۔ یوں روایتی «سیپریشن + شناخت» سلسلہ وار نظام میں غلطیوں کے جمع ہونے سے ابتدا ہی میں بچا جاتا ہے۔
متعدد صلاحیتوں کا متوازن کثیر مرحلہ تربیتی عمل: تقریباً دس لاکھ گھنٹے کے ڈیٹا کی متناسب تربیت کے ذریعے چاروں صلاحیتوں کو متحد کیا گیا ہے: تقریباً 40 لاکھ گھنٹے کے بجائے 40 万小时 یعنی 40 万 گھنٹے کے متعدد اسپیکرز کے ڈیٹا سے ٹارگٹ اخراج کی تربیت، تقریباً 60 万 گھنٹے کے ایک ہی اسپیکر کے حوالہ-ٹارگٹ جوڑوں سے سنگل اسپیکر منظرنامے میں حد سے زیادہ اخراج کو روکنا، تقریباً 1 万 گھنٹے کے غیر مطابق حوالہ جاتی منفی نمونوں سے مسترد کرنے کی صلاحیت کو اندرونی بنانا، جس کے لیے推理 کے وقت کسی threshold کی ضرورت نہیں، اور CoT ڈیٹا کے ذریعے ماڈل کو پہلے استدلالی سلسلہ اور پھر جواب دینے کی تربیت دینا۔
دوہرا موڈ Prompt اور مسترد کرنے کا طریقۂ کار: معیاری موڈ ایک متحدہ Prompt کے ذریعے ایک اسپیکر کی شناخت، متعدد اسپیکرز میں مطلوبہ اسپیکر کی شناخت اور منفی نمونوں کو مسترد کرنے، تینوں کاموں کو بیک وقت پورا کرتا ہے۔ مطلوبہ اسپیکر موجود نہ ہو تو ماڈل فطری طور پر خالی متن آؤٹ پٹ کرتا ہے۔ CoT موڈ میں الگ Prompt کے ذریعے استدلالی لیبل فعال کیے جاتے ہیں؛ ماڈل اسپیکرز کی تعداد، جنس اور اسپیکر ایمبیڈنگ کی مماثلت جیسے درمیانی مراحل آؤٹ پٹ کرنے کے بعد حتمی ٹرانسکرپشن دیتا ہے، جس سے قابلِ تشریحیّت بہتر ہوتی ہے اور WER معمولی حد تک کم ہوتا ہے۔
04Xiaomi-CocktailASR-1 کیسے استعمال کریں
انحصارات انسٹال کریں: مطلوبہ ماحول انسٹال کرنے کے لیے pip install torch torchaudio transformers soundfile چلائیں۔
ماڈل ڈاؤن لوڈ کریں: HuggingFace (Ease3/Xiaomi-CocktailASR-1) سے ماڈل کے وزن کی فائلیں ڈاؤن لوڈ کریں۔
ماڈل لوڈ کریں: AutoModel.from_pretrained("Ease3/Xiaomi-CocktailASR-1", trust_remote_code=True, torch_dtype="bfloat16").cuda().eval() کے ذریعے ماڈل لوڈ کریں۔
آڈیو تیار کریں: 16k سیمپل ریٹ والی مونو حوالہ جاتی آواز (مطلوبہ اسپیکر کی آواز) اور شناخت کے لیے ایک اسپیکر یا متعدد اسپیکرز کی آڈیو تیار کریں (16k نہ ہونے کی صورت میں خودکار طور پر ری سیمپلنگ کی جائے گی)۔
واحد استدلال: model("target.wav", "ref_speaker.wav") کال کرنے سے مطلوبہ اسپیکر کی ٹرانسکرپٹ واپس مل جاتی ہے (منفی نمونے کی صورت میں خودکار طور پر خالی متن آؤٹ پٹ ہوتا ہے، اضافی پیرامیٹر درکار نہیں)۔
چین آف تھاٹ استدلال: cot=True پیرامیٹر شامل کرنے پر ماڈل میں استدلالی عمل اور میں حتمی نتیجہ آؤٹ پٹ کرے گا۔
بیچ استدلال: ڈیٹا کو 5 کالموں والی TSV (utt_id, wav, text, ref_wav, ref_id) کی شکل میں ترتیب دیں، پھر tools/test_batch_scp.py چلائیں اور ماڈل کا راستہ، ان پٹ TSV اور آؤٹ پٹ فائل متعین کریں تاکہ بیچ ٹرانسکرپشن کی جا سکے۔
05Xiaomi-CocktailASR-1 کے بنیادی فوائد
متعدد اسپیکرز میں SOTA کارکردگی: AliMeeting، AMI، LibriMix اور دیگر معروف متعدد اسپیکرز کے بینچ مارکس پر بہترین شناختی کارکردگی حاصل کرتا ہے، مثلاً AliMeeting Far WER 20.63% ہے جبکہ سابقہ SOTA 27.5% تھا۔
ایک اور متعدد اسپیکرز کے منظرناموں کی یکجا معاونت: ایک ہی ماڈل سنگل اسپیکر کے منظرنامے میں معروف ASR کے برابر کارکردگی دیتا ہے؛ اسپیکرز کی تعداد کے مطابق ماڈل تبدیل کرنے کی ضرورت نہیں۔
منفی نمونوں کو مسترد کرنے کی صلاحیت: مطلوبہ اسپیکر موجود نہ ہو تو خالی متن آؤٹ پٹ کرتا ہے، مسترد کرنے کی شرح 68%-80% تک پہنچتی ہے، جبکہ Qwen3-ASR اور StepAudio جیسے ماڈلز کی مسترد کرنے کی شرح 0 ہے۔
چین آف تھاٹ کی قابلِ تشریح شناخت: CoT موڈ اسپیکرز کی تعداد، جنس اور اسپیکر ایمبیڈنگ کی مماثلت جیسے استدلالی مراحل آؤٹ پٹ کرتا ہے، جس سے قابلِ تشریحیّت بہتر ہوتی ہے اور WER معمولی حد تک کم ہوتا ہے۔
سادہ اینڈ ٹو اینڈ معماری: حوالہ جاتی آواز براہِ راست اسپیکر ایمبیڈنگ Prompt کے طور پر استعمال ہوتی ہے، روایتی اسپیچ سیپریشن ماڈیول کی ضرورت ختم ہو جاتی ہے اور سلسلہ وار نظام میں غلطیوں کے جمع ہونے سے بچا جاتا ہے۔
استعمال میں آسان: ایک سطر کے کوڈ سے کال، خودکار ری سیمپلنگ اور بیچ استدلال کی معاونت، اور مثبت و منفی نمونوں کے Demo دستیاب ہیں؛ انسٹال کرتے ہی استعمال کے لیے تیار۔
06Xiaomi-CocktailASR-1 کا پروجیکٹ لنک
GitHub ریپوزٹری: https://github.com/xiaomi-research/xiaomi-cocktailasr-1
HuggingFace ماڈل ریپوزٹری: https://huggingface.co/Ease3/Xiaomi-CocktailASR-1
arXiv تکنیکی مقالہ: https://arxiv.org/pdf/2609.11274
07Xiaomi-CocktailASR-1 کے اطلاقی منظرنامے
ذہین اجلاسوں کی ہدفی ٹرانسکرپشن: متعدد افراد کے اجلاس میں صرف مخصوص مقرر کی گفتگو سن کر تحریر میں تبدیل کرتا ہے اور دیگر شرکا کی مداخلت و گفتگو خودکار طور پر فلٹر کرتا ہے۔
وائس اسسٹنٹ میں مالکِ ڈیوائس کے احکامات کی شناخت: فون، اسپیکر یا گاڑی کے منظرناموں میں صرف مالکِ ڈیوائس کی آواز پر ردِعمل دیتا ہے، پسِ منظر میں موجود افراد کی آواز سے احکامات غلطی سے فعال نہیں ہوتے۔
کسٹمر سروس اور کوالٹی انسپیکشن ریکارڈنگ کا تجزیہ: متعدد افراد کی کال ریکارڈنگ میں سے مخصوص فریق کی مکمل گفتگو درست طور پر اخذ کرتا ہے، جسے تعمیل کی جانچ اور سروس کی تشخیص کے لیے استعمال کیا جا سکتا ہے۔
سمارٹ ہوم وائس کنٹرول: ٹیلی وژن کے شور اور متعدد افراد کی گفتگو والے گھریلو ماحول میں ریموٹ کنٹرول رکھنے والے فرد کے صوتی احکامات درست طور پر پہچانتا ہے اور غلط آپریشن سے بچاتا ہے۔
قابلِ رسائی سماعت اور ریکارڈنگ آلات: سماعت سے محروم افراد یا ریکارڈنگ کرنے والوں کے لیے مخصوص اسپیکر کی آواز کو ہدفی طور پر اخذ کرکے حقیقی وقت میں متن میں تبدیل کرتا ہے، تاکہ شور شرابے والی سماجی صورتحال میں مطلوبہ شخص کی بات واضح طور پر سنی جا سکے۔
© دستبرداری: ڈومینز اور لنک شدہ مواد وقت کے ساتھ تبدیل ہو سکتے ہیں۔ AIEZZ فریقِ ثالث کی ویب سائٹس کو کنٹرول نہیں کرتا۔ بیرونی مواد اور خطرات کا آزادانہ جائزہ لیں۔
صارف کے جائزے0