
- ماہانہ وزٹس
- 0
- قیمتیں
- متعین نہیں
- فہرست میں شامل
- —
- اپ ڈیٹ شدہ
- 2026-11-04
01EvaOmni کیا ہے
EvaOmni شنگھائی جیاؤ تونگ یونیورسٹی، فودان یونیورسٹی، ٹینسینٹ یوتو سمیت اداروں کی جانب سے اوپن سورس کیا گیا آل موڈل بڑے ماڈلز کا جائزہ لینے کا معیار ہے، جس میں 392 حقیقی ویڈیوز اور انسانی طور پر لیبل کردہ 1,027 سوال و جواب شامل ہیں، اور یہ 15 صلاحیتوں اور استدلال کی 3 سطحوں کا احاطہ کرتا ہے۔ EvaOmni کو جواب کے ساتھ آڈیو اور ویڈیو شواہد کے زمانی وقفے بھی فراہم کرنے ہوتے ہیں، اور اسے جواب کی درستگی، شواہد کے احاطے اور دوہری موڈل لوکیشن کے تین اشاریوں کی بنیاد پر اسکور کیا جاتا ہے۔ EvaOmni کے عملی تجربے میں 24 ماڈلز میں سب سے مضبوط Gemini3.7-Flash کی درستگی 79.4% تھی، لیکن دوہری موڈل لوکیشن صرف 35.1% رہی؛ انسانی ماہرین کے 94.3% کے مقابلے میں 59.2 فیصد پوائنٹس کا فرق، جس سے درست جواب دینے کے باوجود ثبوت پیش نہ کر سکنے کی کمزوری سامنے آتی ہے۔
02EvaOmni کے اہم افعال
جواب کا جائزہ: بصری و سمعی کثیر الانتخاب سوالات میں ماڈل کے جواب کی درستگی جانچتا ہے اور درستگی Acc. فراہم کرتا ہے۔
شواہد کی لیبلنگ اور واپسی: ہر سوال کے لیے جواب کی تائید کرنے والے آڈیو اور ویڈیو زمانی وقفوں کی انسانی لیبلنگ کی جاتی ہے، اور ماڈل کو جواب کے ساتھ دوہری موڈل شواہد کے وقفے بھی واپس کرنے ہوتے ہیں۔
شواہد کے احاطے کا اسکور (C.G.): انسانی طور پر لیبل کردہ شواہد کے حصوں میں سے ماڈل کے متوقع وقفوں سے ملنے والے حصوں کا تناسب شمار کرتا ہے، جس سے معلوم ہوتا ہے کہ ماڈل نے کتنے معاون اشارے تلاش کیے۔
دوہری موڈل رکاوٹ کی تعیین (B.G.): آڈیو اور ویڈیو کے لیے الگ الگ زمانی IoU کا حساب لگایا جاتا ہے اور کمزور موڈل کے اسکور کو حتمی اسکور بنایا جاتا ہے، جس کے لیے دونوں موڈلز میں بیک وقت درست لوکیشن ضروری ہے۔
صلاحیتوں کی تین سطحیں: کاموں کو بازیافت و لوکیشن، بنیادی تفہیم اور پیچیدہ استدلال میں تقسیم کیا جاتا ہے، تاکہ ایک نقطے کی ہم آہنگی سے کثیر مرحلہ استدلال تک ماڈل کی صلاحیت کا جائزہ لیا جا سکے۔
شارٹ کٹ فلٹرنگ: متنی، آڈیو اور بصری یک موڈل ان پٹ کے ذریعے سوالات کی جانچ کی جاتی ہے، اور ایسے نمونے خارج کیے جاتے ہیں جن کا جواب صرف ایک موڈل یا متنی عمومی معلومات کی مدد سے دیا جا سکتا ہو۔
ماڈلز کا تقابلی جائزہ: 24 آل موڈل ماڈلز کے لیے یکساں معیار اور درجہ بندی فراہم کرتا ہے، جس سے اوپن ویٹ اور ملکیتی ماڈلز کے تقابل اور انتخاب میں مدد ملتی ہے۔
03EvaOmni کے تکنیکی اصول
وی چیٹ پر فالو کریں اور “开源” کا جواب دے کر AI اوپن سورس منصوبوں کے گروپ میں شامل ہوں
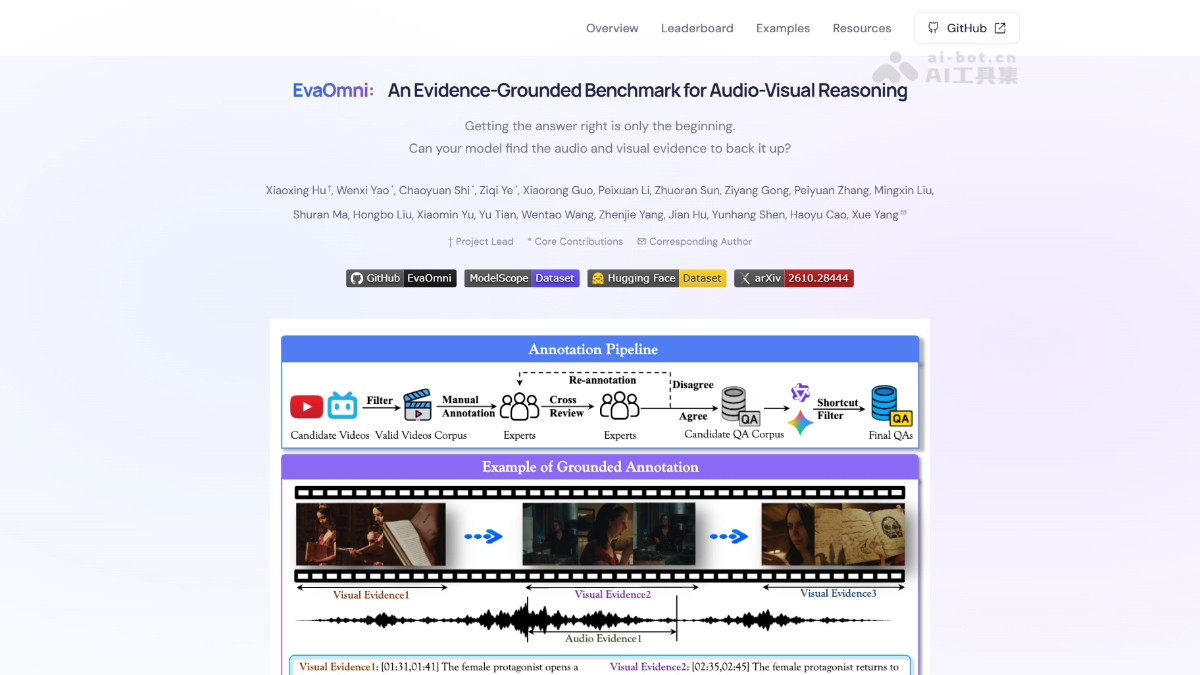
شواہد سے آگاہ ڈیٹا کا ڈھانچہ: EvaOmni ہر سوال کے لیے آڈیو شواہد کا زمانی وقفہ اور ویڈیو شواہد کا زمانی وقفہ بیک وقت لیبل کرتا ہے، اور ویڈیو کے مواد کی بنیاد پر تیار کردہ گمراہ کن اختیارات کا مجموعہ بھی فراہم کرتا ہے۔ اس لیے ماڈل کا آؤٹ پٹ تین اجزا پر مشتمل ہوتا ہے: اختیار، آڈیو ٹائم اسٹیمپس کا مجموعہ اور ویڈیو ٹائم اسٹیمپس کا مجموعہ۔ جائزہ پروگرام جواب کی درستگی اور شواہد کی لوکیشن کے معیار کو الگ الگ جانچ سکتا ہے۔
ڈیٹا کی تعمیر کی چار مرحلوں والی پائپ لائن: ڈیٹا کی تیاری ویڈیو انتخاب، انسانی لیبلنگ، باہمی جانچ اور شارٹ کٹ فلٹرنگ کے چار مراحل سے گزرتی ہے۔ پہلے ایسے ویڈیوز خارج کیے جاتے ہیں جن میں سخت کوڈ شدہ سب ٹائٹلز یا بڑے پیمانے پر متنی احاطہ موجود ہو، تاکہ بصری و سمعی اشارے حقیقی اور مؤثر رہیں۔ ماہرین سوالات لکھتے، ویڈیو کے مواد سے وابستہ گمراہ کن اختیارات تیار کرتے اور دونوں موڈلز کے شواہد کے وقفے لیبل کرتے ہیں۔ دیگر لیبلرز صلاحیت کی درجہ بندی، شواہد کے معیار اور شارٹ کٹ مسائل کی باہمی جانچ کرتے ہیں، جبکہ متنازع نمونوں کا دو اضافی ماہرین آزادانہ طور پر دوبارہ جائزہ لیتے ہیں۔ ماڈل سے صرف متن، صرف آڈیو اور صرف بصری ان پٹ کے تحت الگ الگ جواب لیا جاتا ہے، اور جو سوالات کسی ایک موڈل سے درست حل ہو جائیں انہیں دوبارہ ترمیم اور لیبلنگ کے لیے واپس بھیج دیا جاتا ہے، تاکہ ڈیٹا کی سطح پر “بصری و سمعی مشترکہ استدلال سے بچنے” کے شارٹ کٹ کو روکا جا سکے۔
احاطے اور لوکیشن پر مبنی دوہرا اسکورنگ نظام: شواہد کے احاطے کا اسکور C.G. یہ شمار کرتا ہے کہ انسانی طور پر لیبل کردہ ہر شواہد کے حصے کا کسی بھی متوقع وقفے کے ساتھ مثبت دورانیے کا تقاطع موجود ہے یا نہیں، یعنی یہ جانچتا ہے کہ شواہد ملا یا نہیں۔ رکاوٹ کی لوکیشن کا اسکور B.G. ہر موڈل میں تمام متوقع وقفوں اور لیبل کردہ وقفوں کا الگ الگ اتحاد لے کر زمانی تقاطع و اتحاد کے تناسب IoU سے اوورلیپ کا حساب کرتا ہے، اور آخر میں آڈیو اور ویڈیو کے دو IoU میں سے کمزور کو حتمی اسکور بناتا ہے۔ دونوں اشاریوں کو جواب کی درستگی کے اسکور سے ضرب دی جاتی ہے، اس لیے غلط جواب کو صفر اسکور ملتا ہے۔ اس ڈیزائن کے تحت وسیع متوقع وقفے صرف احاطے کا اسکور حاصل کر سکتے ہیں، جبکہ درست حدود ہی لوکیشن کے اسکور میں حصہ ڈالتی ہیں؛ ساتھ ہی “کمزور موڈل” کو حتمی اسکور بنا کر مضبوط موڈل سے کمزور موڈل کی تلافی کو روکا جاتا ہے۔
صلاحیتوں کی تین سطحوں کا ڈیزائن: ڈیٹا سیٹ کو استدلال اور شواہد کی پیچیدگی کے لحاظ سے تین سطحوں میں منظم کیا گیا ہے۔ Level 1 بازیافت اور لوکیشن میں آڈیو و ویڈیو کے درمیان وقت، واقعات اور اداروں کی ہم آہنگی جانچی جاتی ہے۔ Level 2 بنیادی تفہیم میں باہم تکمیلی بصری و سمعی اشاروں کو یکجا کرکے واقعات، جذبات اور ارادوں کو سمجھنا درکار ہوتا ہے۔ Level 3 پیچیدہ استدلال میں مختلف زمانی مقامات پر بکھرے متعدد شواہد کو یکجا کرکے کثیر مرحلہ فیصلہ کرنا ہوتا ہے۔ سطح جتنی بلند ہو، فی سوال شواہد کی تعداد اور احاطہ کیے گئے دورانیے میں اتنا ہی نمایاں اضافہ ہوتا ہے، جس سے بازیافت، تفہیم اور طویل مدتی کثیر مرحلہ استدلال میں ماڈل کی کمزوری کو مخصوص سطح تک محدود کرکے شناخت کیا جا سکتا ہے۔
04EvaOmni کا استعمال کیسے کریں
ModelScope کلائنٹ انسٹال کریں: ModelScope SDK کو انسٹال یا اپ گریڈ کرنے کے لیے pip install -U modelscope چلائیں۔
ڈیٹا سیٹ ڈاؤن لوڈ کریں: ڈیٹا سیٹ ID VisionXLab/EvaOmni-Dataset متعین کرکے dataset_snapshot_download استعمال کریں اور ڈیٹا کو مقامی ڈائریکٹری میں ڈاؤن لوڈ کریں۔
ماڈل ان پٹ تیار کریں: جائزے کے پروٹوکول کے مطابق ویڈیو کو پری پروسیس کریں اور متعلقہ آڈیو مواد شامل کریں۔
جائزہ لیے جانے والے ماڈل کو مربوط کریں: GitHub ریپوزٹری کی ہدایات کے مطابق اپنا آل موڈل ماڈل مربوط کریں، اور یکساں پرامپٹ کے ذریعے ماڈل سے اختیار، آڈیو ٹائم اسٹیمپ اور ویڈیو ٹائم اسٹیمپ پر مشتمل تین اجزا والا آؤٹ پٹ حاصل کریں۔
جائزہ چلائیں: جائزہ فریم ورک کو کال کرکے تمام 1,027 سوال و جواب پر بیچ推理 چلائیں، جس کے بعد پروگرام خودکار طور پر جوابات اور وقفوں کی مطابقت جانچے گا۔
نتائج دیکھیں: Acc.، C.G.، B.G. کے تین اشاریوں اور تین سطحی صلاحیت کے اسکور پڑھیں، اور ماڈل کی کمزوریوں کی شناخت کے لیے درجہ بندی سے موازنہ کریں۔
05EvaOmni کے بنیادی فوائد
شواہد کی لوکیشن کو اسکور میں شامل کرنا: ماڈل سے آڈیو اور ویڈیو شواہد کے زمانی وقفے واپس کرنے کا تقاضا کیا جاتا ہے، جس سے محض درست اندازے اور قابلِ ثبوت جواب میں فرق کیا جا سکتا ہے۔
شواہد کے معیار کی دوہری مقداری پیمائش: شواہد کے احاطے کا اسکور C.G. اشاروں کے مکمل طور پر ملنے کی پیمائش کرتا ہے، جبکہ رکاوٹ کی لوکیشن کا اسکور B.G. زمانی IoU کے مطابق کمزور موڈل کو حتمی اسکور بناتا ہے، تاکہ مضبوط موڈل سے کمزور موڈل کو چھپانے کا امکان ختم ہو۔
صلاحیتوں کی باریک تین سطحی درجہ بندی: بازیافت و لوکیشن، بنیادی تفہیم اور پیچیدہ کثیر مرحلہ استدلال سے بتدریج آگے بڑھتے ہوئے یہ مختلف استدلالی گہرائیوں میں ماڈل کی مخصوص کمزوریوں کی شناخت کر سکتی ہے۔
اعلیٰ معیار کی انسانی لیبلنگ: ماہرین کے سوالات، باہمی جانچ اور متنازع نمونوں کے دو ماہرین کے ذریعے دوبارہ جائزے کی بدولت ڈیٹا کی قابلِ اعتمادیت خودکار طور پر تیار کردہ ہم نوع معیارات سے بہتر ہے۔
سخت شارٹ کٹ فلٹرنگ: متنی، آڈیو اور بصری تینوں یک موڈل ان پٹ سے سوالات کی جانچ کی جاتی ہے، اور ایسے نمونے خارج کیے جاتے ہیں جن کا جواب بصری و سمعی مشترکہ استدلال سے بچ کر دیا جا سکتا ہو، تاکہ جائزہ منصفانہ رہے۔
حقیقی صلاحیتوں کے فرق کو ظاہر کرنا: عملی تجربے سے معلوم ہوا کہ مضبوط ترین ماڈل کی جواب کی درستگی انسانوں سے صرف 17 فیصد پوائنٹس کم ہے، لیکن دوہری موڈل لوکیشن میں فرق 59.2 فیصد پوائنٹس ہے، جس سے موجودہ ماڈلز کی حقیقی کمزوری سامنے آتی ہے۔
06EvaOmni کا منصوبہ پتہ
منصوبے کی ویب سائٹ:https://xiaoxing2001.github.io/EvaOmni.github.io/
GitHub ریپوزٹری:https://github.com/VisionXLab/EvaOmni
HuggingFace ماڈل ریپوزٹری:https://huggingface.co/datasets/VisionXLab/EvaOmni-Dataset
arXiv تکنیکی مقالہ:https://arxiv.org/pdf/2610.28444
07EvaOmni کے اطلاقی منظرنامے
آل موڈل ماڈلز کی تحقیق و ترقی اور جانچ: ماڈل ٹیمیں Omni LLM کو بہتر بناتے وقت Acc./C.G./B.G. کے تین اشاریوں سے “جواب میں بہتری آئی لیکن شواہد کی لوکیشن ساتھ نہیں بڑھی” والی صلاحیتی خلیج کی شناخت کر سکتی ہیں اور تربیت کی بہتری کی سمت متعین کر سکتی ہیں۔
انٹرپرائز سطح پر AI کا انتخاب اور قبولیت: مالیاتی اور حکومتی امور جیسے ایسے منظرناموں میں جہاں ماڈل سے “قابلِ تصدیق بنیاد فراہم کرنے” کی توقع ہو، خریدار B.G. رکاوٹ لوکیشن اسکور کے ذریعے حقیقی طور پر قابلِ اعتماد دوہری موڈل ماڈل منتخب کر سکتے ہیں۔
ویڈیو مواد کی جانچ اور ماخذ کا سراغ: جانچ پر مبنی ایپلی کیشنز میں ماڈل سے یہ بتانے کا تقاضا ہوتا ہے کہ خلاف ورزی پر مبنی مواد “کس منظر اور کس آواز کے حصے” میں ظاہر ہوا۔ EvaOmni کے زمانی وقفوں کے آؤٹ پٹ اور لوکیشن کے اشاریے براہِ راست قبولیت کے معیار کے طور پر استعمال کیے جا سکتے ہیں۔
تعلیمی اور فلمی مواد کے سوال و جواب کی مصنوعات: ویڈیو والے تعلیمی معاونین اور فلمی تشریح کی مصنوعات کو اصل کلپس کا حوالہ دے کر جواب دینا ہوتا ہے، اس لیے اس معیار سے جانچا جا سکتا ہے کہ ماڈل متعلقہ مناظر اور مکالموں کی درست لوکیشن تلاش کر سکتا ہے یا نہیں۔
علمی تحقیق اور درجہ بندی کی تعمیر: محققین اوپن سورس 392 شواہد سے لیبل کردہ ویڈیوز کی بنیاد پر بصری و سمعی استدلال، زمانی لوکیشن اور کثیر مرحلہ استدلال جیسے موضوعات پر مزید تحقیق کر سکتے ہیں، یا اسے متعدد معیارات کے مشترکہ جائزہ نظام میں شامل کر سکتے ہیں۔
© دستبرداری: ڈومینز اور لنک شدہ مواد وقت کے ساتھ تبدیل ہو سکتے ہیں۔ AIEZZ فریقِ ثالث کی ویب سائٹس کو کنٹرول نہیں کرتا۔ بیرونی مواد اور خطرات کا آزادانہ جائزہ لیں۔
صارف کے جائزے0