

مستقل ویب سائٹ چلاتے ہوئے میں نے محسوس کیا کہ ہر پیر کی صبح میں ہمیشہ ایک ہی کام کرتا ہوں۔
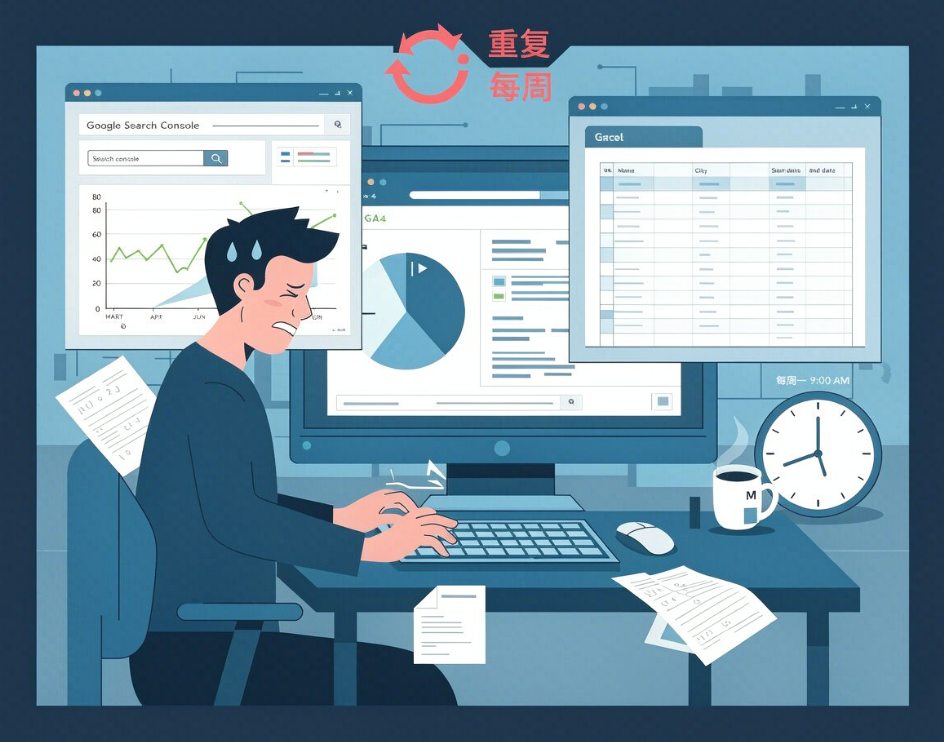
Google Search Console کھول کر گزشتہ ماہ کے سرچ استفسارات کا ڈیٹا دستی طور پر برآمد کرنا۔ GA4 کھول کر ٹریفک کے لحاظ سے 50 سرفہرست لینڈنگ پیجز کو CSV میں برآمد کرنا۔ پھر Excel میں دونوں جدولوں کو ملانا، یعنی GSC کے امپریشنز اور کلکس کو GA4 کے سیشنز اور تبادلوں کے ساتھ URL کے مطابق جوڑنا۔ اس کے بعد دستی طور پر رنگ لگانا: ٹریفک کم ہو تو سرخ، اور تبادلوں کی شرح اوسط سے کم ہو تو زرد۔
پورے عمل میں تقریباً ڈیڑھ گھنٹہ لگتا تھا۔ کام مکمل ہونے کے بعد اسے گروپ میں بھیجتا، اور کلائنٹ کی طرف سے جواب آتا: "موصول ہوگیا"۔
میں نے تین سال تک ہر ہفتے یہی کام کیا۔
پھر گزشتہ ماہ میرے ایک ٹیکنیکل دوست نے میری اسکرین پر نظر ڈالی اور ایسی بات کہی جو دل پر لگی: "یہ تو صرف API کو جوڑنے کا کام ہے، تم ہر ہفتے اسے دستی طور پر کیوں کرتے ہو؟"
میں ایک لمحے کے لیے رک گیا۔ وہ درست کہہ رہا تھا۔ مسئلہ یہ نہیں تھا کہ مجھے معلوم نہیں تھا کہ GSC اور GA4 کی APIs موجود ہیں۔ مسئلہ یہ تھا کہ جب بھی میں "API کو کال کرنے کے لیے اسکرپٹ لکھنے" کے بارے میں سوچتا، میرے ذہن میں ایک پورا انجینئرنگ پروجیکٹ آجاتا: Python لکھنا، authentication سنبھالنا، pagination سنبھالنا، فیلڈ میپنگ کرنا، فرنٹ اینڈ بنانا۔۔۔ یہ سب کام واقعی وقت بچا سکتے تھے، لیکن آغاز کی لاگت اتنی زیادہ محسوس ہوتی تھی کہ میں ہمیشہ اسے مؤخر کرتا رہا۔
موڑ کہاں آیا؟ Codex کے ساتھ۔
اول: Codex کیا ہے، اور یہ ChatGPT کیوں نہیں ہے
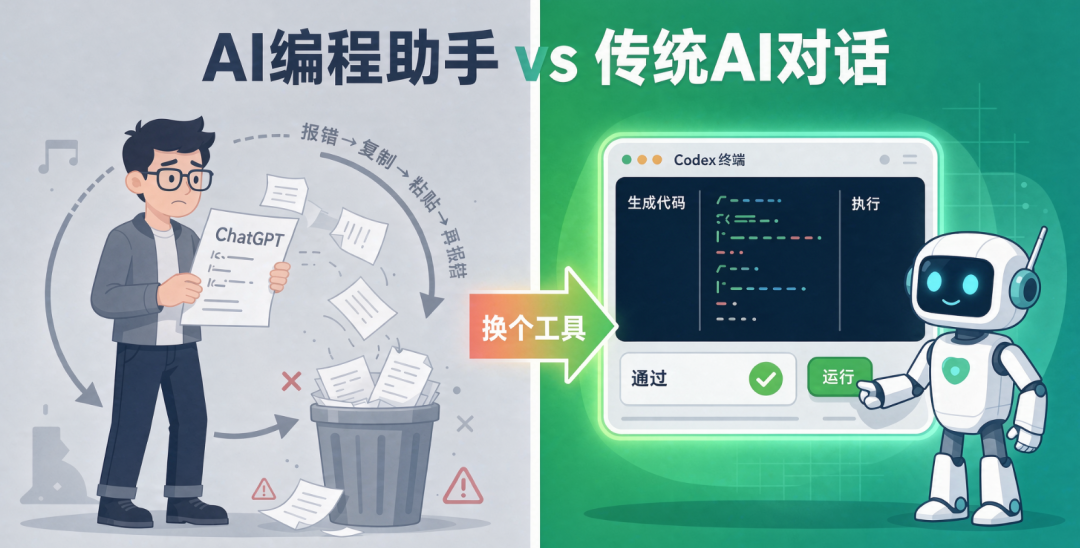
جب لوگ AI سے کوڈ لکھوانے کی بات سنتے ہیں تو ان کا پہلا ردِعمل ہوتا ہے: "ChatGPT سے ایک اسکرپٹ لکھوا لیتے ہیں۔" میں نے بھی یہ آزمایا ہے۔ ChatGPT آپ کو کوڈ کا ایک ٹکڑا دیتا ہے، آپ اسے ایڈیٹر میں پیسٹ کرتے ہیں، ماحول ترتیب دیتے ہیں، dependencies انسٹال کرتے ہیں، error چلاتے ہیں، error واپس پیسٹ کرکے اس سے ترمیم کرواتے ہیں، دوبارہ چلاتے ہیں، پھر error آجاتا ہے۔۔۔ سات آٹھ چکروں کے بعد یہ دستی طور پر ڈیٹا برآمد کرنے سے بھی زیادہ تھکا دینے والا بن جاتا ہے۔
Codex کا کردار بالکل مختلف ہے۔ یہ ایک programming Agent ہے جو براہِ راست terminal میں چلتا ہے۔ اس کا اپنا آزاد sandbox environment ہوتا ہے، یہ فائلیں پڑھ سکتا ہے، فائلیں لکھ سکتا ہے، packages انسٹال کرسکتا ہے، commands چلا سکتا ہے اور errors سنبھال سکتا ہے۔ شروع سے آخر تک آپ کو کوڈ کاپی پیسٹ کرنے کی ضرورت نہیں پڑتی۔ آپ اسے قدرتی زبان میں ہدایت دیتے ہیں، اور یہ خود منصوبہ بناتا، لکھتا، چلاتا اور درست کرتا ہے۔
مثال کے طور پر میں نے اسے یہ ایک جملہ دیا:
"GSC کے گزشتہ 28 دنوں کے سرچ استفسارات کا ڈیٹا برآمد کرکے اسے GA4 کے لینڈنگ پیج ڈیٹا کے ساتھ URL کے مطابق ملاؤ، اور ٹریفک میں سب سے زیادہ کمی والے 20 صفحات کی جدول بناؤ۔"
اس نے خود یہ تمام کام مکمل کیے:
•موجودہ ماحول میں Google API کی Python library موجود ہے یا نہیں، جانچا؛ نہ ہونے پر خود انسٹال کی•میرے GSC اور GA4 authentication فائلوں کے راستے پڑھے اور OAuth سنبھالا•GSC API کو کال کرکے query اور page dimensions کا ڈیٹا حاصل کیا اور pagination خود سنبھالی•GA4 Data API کو کال کرکے landing page dimension کے sessions اور conversions حاصل کیے•URLs صاف کیے، یعنی parameters ہٹائے، آخری slash ہٹایا اور www prefix یکساں کیا•URLs کے مطابق intersection merge کیا اور ہر صفحے کے impressions، clicks اور conversions کا funnel نکالا•ٹریفک میں کمی کی مقدار کے مطابق ترتیب دی گئی Markdown جدول تیار کی
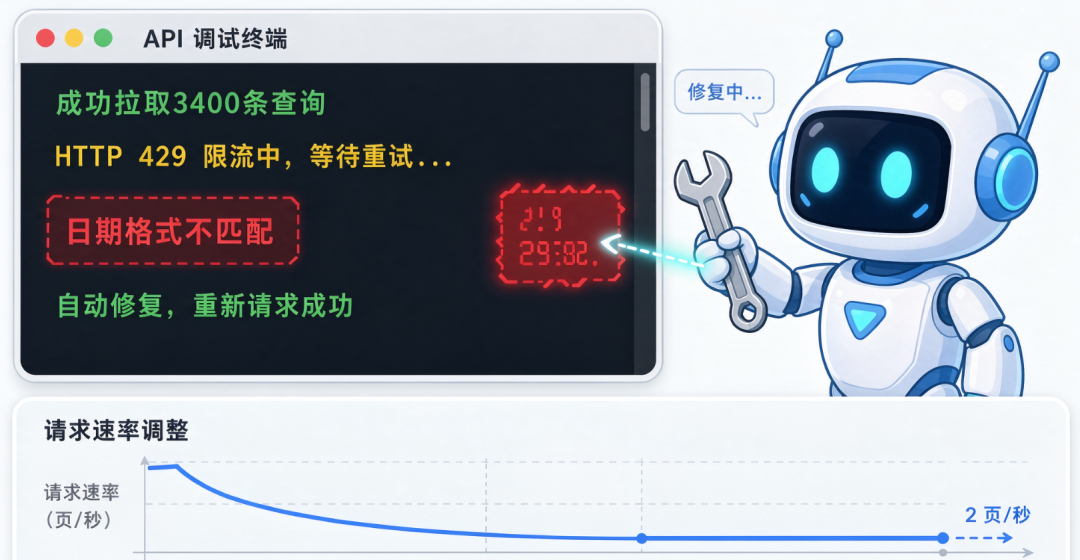
پورے عمل کے دوران میں اسکرین کو دیکھتا رہا اور اس نے سب کچھ خود مکمل کرلیا۔ درمیان میں GA4 API کی تاریخ کے format میں ایک error آیا۔ اس نے error message پڑھا، خود اسے درست کیا، دوبارہ چلایا اور کام ہوگیا۔
🔴 AI programming tools میں فرق یہ نہیں کہ "کون کوڈ لکھ سکتا ہے"، کیونکہ سب لکھ سکتے ہیں۔ اصل فرق یہ ہے کہ "کون اسے خود چلا کر کامیاب کرسکتا ہے"۔
دوم: Codex سے GSC+GA4 ڈیٹا کا مکمل چکر چلانے کا طریقہ
اب میں عملی ترتیب کے مطابق بتاتا ہوں کہ یہ workflow کیسے بنایا گیا۔ نظریہ نہیں، ہر قدم میں نے واقعی terminal میں چلایا ہے۔
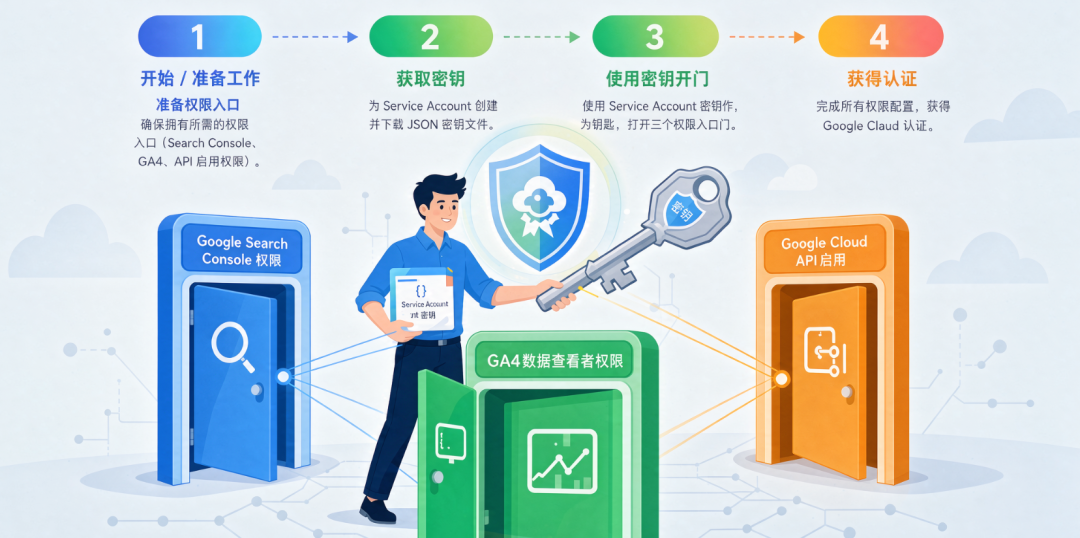
1. تیاری: Google Cloud authentication
اس سے بچا نہیں جاسکتا۔ GSC اور GA4 دونوں کی APIs کو Google Cloud کے OAuth یا Service Account authentication کی ضرورت ہوتی ہے۔ آپ AI استعمال کریں یا نہ کریں، یہ مرحلہ دستی طور پر کرنا پڑتا ہے۔
میں نے یہ کام کیے:
•Google Cloud Console میں ایک project بنایا اور Search Console API اور Google Analytics Data API فعال کیے•ایک Service Account بنایا اور JSON key file مقامی کمپیوٹر پر ڈاؤن لوڈ کی•GSC میں اس Service Account کا email "restricted user" (مکمل اجازت) کے طور پر شامل کیا•GA4 کے admin panel میں اس email کو "data viewer" کے طور پر شامل کیا
Codex اس مرحلے میں آپ کی مدد نہیں کرسکتا، کیونکہ authentication اور authorization انسان اور مشین کے باہمی عمل کا مرحلہ ہے؛ یہ Google کے authorization page پر آپ کی جگہ کلک نہیں کرسکتا۔ لیکن اس کے بعد ہر قدم پر، بشرطیکہ authentication فائل کا راستہ درست ہو، یہ بلا رکاوٹ کام کرے گا۔
⚠️ زیادہ تر API automation پہلی بار کوڈ کی وجہ سے نہیں بلکہ permissions کی وجہ سے رکتی ہے۔ Google کا permissions system روسی گڑیا کی طرح ہے: GSC کا ایک دروازہ، GA4 کا دوسرا، اور Google Cloud کا تیسرا؛ تینوں دروازوں کی permissions ایک دوسرے سے منسلک نہیں ہوتیں۔ یہ مرحلہ صبر سے مکمل کرلیں، پھر آگے کا کام آسان ہوجاتا ہے۔
2. پہلا Skill: GSC query data حاصل کرنا
Codex کا طریقہ کار یہ ہے کہ آپ کاموں کے ایک مجموعے کو ایک قابلِ استعمال Skill (skill file) میں پیک کرکے ~/.codex/skills/ directory میں رکھ سکتے ہیں۔ ہر بار اسی Skill کو چلانے پر یہ اسی منطق کے مطابق کام کرتا ہے۔
میں نے پہلے ایک نہایت سادہ version لکھا: صرف GSC کے query dimension کا ڈیٹا حاصل کرنا۔
اس Skill نے Codex کو تین باتیں بتائیں: کون سی API استعمال کرنی ہے، کون سے dimensions لینے ہیں، اور output کس format میں دینا ہے۔ ایک بار چلانے کے بعد اس نے تقریباً 40 سیکنڈ میں 100 سرفہرست queries کی فہرست نکالی، جس میں clicks، impressions، CTR اور average position شامل تھے۔
میں نے اس نتیجے کا گزشتہ ماہ دستی طور پر برآمد کیے گئے CSV سے موازنہ کیا، ڈیٹا بالکل یکساں تھا۔ اس وقت مجھے محسوس ہوا کہ "دستی دور ختم ہوگیا ہے"۔
لیکن یہ مکمل طور پر درست نہیں تھا۔ GSC API میں ایک مسئلہ ہے: یہ default طور پر صرف 1000 rows دیتی ہے، اس سے زیادہ کے لیے pages بدلنے پڑتے ہیں۔ پہلی بار جب میں نے اسے چلایا تو میری سائٹ پر ایک ماہ میں 3400 سے زیادہ queries تھیں۔ Codex نے خود محسوس کیا کہ واپس آنے والی rows کی تعداد درست نہیں، pagination logic شامل کیا اور دوبارہ چلایا؛ دوسری بار پورا ڈیٹا آگیا۔
اس نے خود دریافت کیا، خود درست کیا۔ ChatGPT سے اسکرپٹ لکھوانے کے تجربے سے یہ بالکل مختلف ہے۔
3. دوسرا Skill: GA4 کو شامل کرنا
GSC کا ڈیٹا حاصل کرنے کے بعد میں نے اسے GA4 کا landing page data بھی حاصل کرنے کو کہا۔
یہ مرحلہ کافی مشکل تھا۔ GA4 Data API کے لیے آپ کو خود ایک "data request body" بنانی ہوتی ہے، جس میں مطلوبہ dimensions (landingPage)، metrics (sessions، conversions، eventCount)، date range اور filter conditions متعین کی جاتی ہیں۔ request body کا JSON structure GSC سے بالکل مختلف ہے، اور GA4 کے response میں field names eventName_xxx کی طویل format میں ہوتے ہیں، جنہیں خود parse کرنا پڑتا ہے۔
Codex نے GA4 API کو جس انداز سے پڑھا اور استعمال کیا وہ میرے لیے خاصا متاثر کن تھا۔ اس نے محض ہدایات کے مطابق API call نہیں کی، بلکہ call کرنے سے پہلے Schema probe کیا: GA4 Metadata API کو کال کرکے اس property میں موجود تمام dimensions، metrics اور field names حاصل کیے، پھر request body تیار کی۔
💡 "پہلے موجودہ صورتحال سمجھو، پھر کام شروع کرو" کا یہ طریقہ وہی ہے جو ایک انسان نئے API سے رابطہ کرتے وقت اختیار کرتا ہے۔ AI نے اسے خودکار بنا دیا ہے۔
دونوں Skills چلانے کے بعد میرے پاس دو جدولیں تھیں:
•GSC query dimensions: keywords، page URLs، clicks، impressions، CTR، average position•GA4 landing page dimensions: page URLs، sessions، conversions، average engagement time
اب اگلا مرحلہ merge کرنا تھا۔
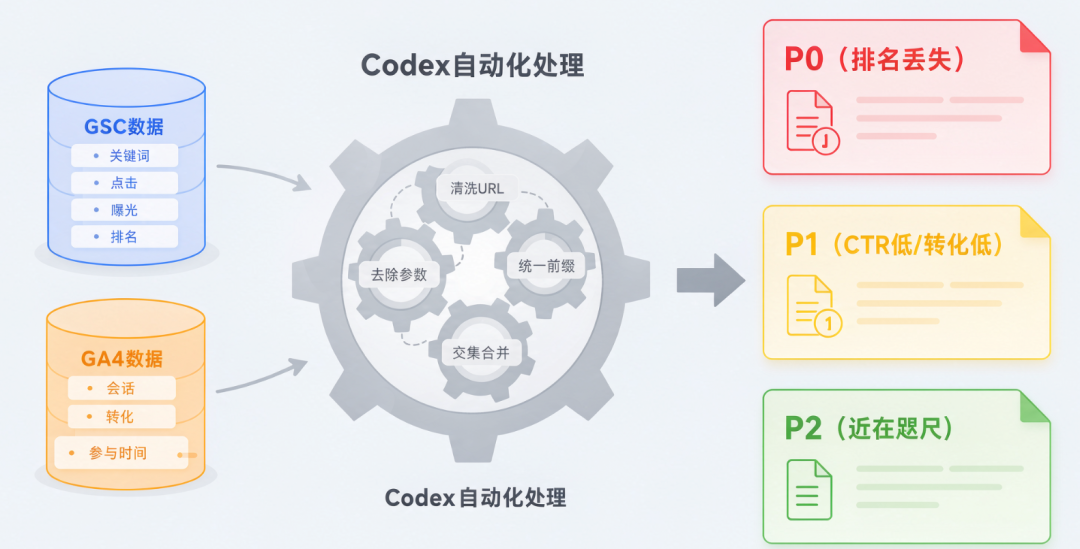
4. Merge: دو جدولوں سے ترجیحی Todo تک
دو جدولوں کو ملانا سننے میں آسان لگتا ہے، URL کو URL کے ساتھ جوڑو اور کام ختم۔ لیکن عملی طور پر بے شمار چھوٹے مسائل سامنے آتے ہیں۔
میں نے Codex سے کہا کہ پہلے دونوں جدولوں کے data samples کو خود "دیکھے"۔ اس نے دریافت کیا کہ GSC کے page URLs میں https:// prefix موجود ہے، جبکہ GA4 کے landing page paths صرف /blog/seo-guide کی شکل میں ہیں۔ GSC کے URLs کے آخر میں ?utm_source=google جیسے query parameters ہیں، جبکہ GA4 میں وہ پہلے ہی ہٹائے جاچکے ہیں۔ کچھ صفحات GSC میں موجود ہیں مگر GA4 میں نہیں، اور اس کے برعکس بھی۔
Codex نے ان فرقوں کے لیے خود data cleaning کی: prefix، parameters اور anchors ہٹائے، آخری slash یکساں کیا، پھر intersection merge کیا۔
Merge کے بعد اس نے مجھے ایک بے جان pivot table نہیں دی، بلکہ مسئلے کی قسم کے مطابق ترجیح دی گئی diagnostic report دی:
ترجیح|صفحے کی خصوصیت|تشخیصی سمت
🔴 P0|impressions میں 30% سے زیادہ کمی، position top5 سے نکل کر top10 سے باہر|ranking loss، backlinks اور content freshness چیک کریں
🟡 P1|زیادہ impressions، کم CTR (CTR اوسط سے 50% کم)|عنوان کی کشش ناکافی، Title اور Meta بہتر کریں
🟡 P1|زیادہ clicks، کم conversions (conversion rate اوسط سے 40% کم)|landing page کی conversion صلاحیت ناکافی، page content اور CTA چیک کریں
🟢 P2|position 8-20، search volume زیادہ|مقصد قریب ہے، internal links اور content مضبوط کریں
📊 دو الگ الگ رپورٹس کو شدت کے لحاظ سے ترتیب دیے گئے Todo میں بدلنا ہی "data loop" کا مطلب ہے۔ مقصد ڈیٹا دیکھنا نہیں، بلکہ یہ جاننا ہے کہ کیا کرنا ہے۔
سوم: اس عمل میں پیش آنے والے حقیقی مسائل
Skill مکمل کرکے چلانے کے بعد پیچھے مڑ کر دیکھیں تو سب کچھ "فطری" لگتا ہے۔ لیکن اس وقت کئی چیزیں واقعی مجھے روک چکی تھیں۔
مسئلہ اول: GA4 کے metric names واضح نہیں
GA4 API میں sessions کو sessions ہی کہا جاتا ہے، اس کا کوئی زیادہ بدیہی نام نہیں۔ conversions کو conversions نہیں بلکہ eventCount کہا جاتا ہے، اور یہ صرف ان events تک محدود ہوتا ہے جنہیں آپ نے conversion کے طور پر نشان زد کیا ہو۔ average engagement time کو avgTimeOnPage نہیں بلکہ userEngagementDuration کہا جاتا ہے، اور پھر اسے خود sessions سے تقسیم کرنا پڑتا ہے۔
دستاویزات پڑھ کر یہ سب سمجھا جاسکتا ہے، مسئلہ یہ ہے کہ ہر چیز الگ الگ تلاش کرنے میں ایک یا دو گھنٹے لگ سکتے ہیں۔ Codex نے میرے لیے یہی وقت بچایا۔ API request بنانے سے پہلے اس نے خود GA4 Metadata interface کو کال کیا، اس property کے تمام دستیاب metrics کے names، types اور descriptions حاصل کیے، پھر انگریزی مفہوم کے مطابق یہ ملایا کہ "مجھے sessions کی تعداد چاہیے" کے لیے کون سا field مناسب ہے۔
مسئلہ دوم: GSC API کی quota limits
GSC API کی روزانہ quota، GSC میں دستی کام کی طرح، محدود ہوتی ہے۔ پہلی بار میں نے pagination بہت تیز رکھی، 20 pages بیک وقت کال کیے اور فوراً rate limit سے ٹکرا گیا۔ Codex کو HTTP 429 موصول ہونے کے بعد اس نے چند سیکنڈ انتظار کرکے دوبارہ کوشش کی، اور دوسری بار pagination کی رفتار کم کرکے 2 pages فی سیکنڈ کردی؛ اس کے بعد کام مستحکم رہا۔
اس تجربے نے مجھے سمجھایا کہ AI خواہ کتنا ہی ذہین ہو، یہ انسانوں کے بنائے ہوئے API کو کال کرتا ہے۔ API کی rate limits، data formats اور field naming جیسے مشکل کام یہ آپ کی جگہ سنبھال لیتا ہے، لیکن آپ کو معلوم ہونا چاہیے کہ مسائل کہاں آسکتے ہیں۔
مسئلہ سوم: Codex کبھی کبھی ضرورت سے زیادہ engineering کر دیتا ہے
ایک بار میں نے اسے کہا: "ڈیٹا کو page type کے مطابق گروپ کرو"۔ میرا مطلب URL path میں /blog/ اور /product/ جیسے prefixes کے مطابق فرق کرنا تھا۔ Codex نے سمجھا کہ ہر page کا HTML structure پڑھ کر page type نکالنی ہے۔ اس نے واقعی یہ کام کیا: requests library سے ہر page کا HTML crawl کیا، meta tags اور schema markup کا تجزیہ کیا، پھر classification کی۔
کام تو ہوگیا، لیکن تقریباً 4 منٹ لگ گئے۔ جبکہ مجھے صرف URL path prefix کے مطابق conditional buckets بنانے تھے۔
⚠️ AI کے ساتھ کام کرتے وقت سوال کی وضاحت اس کی efficiency طے کرتی ہے۔ آپ جتنا درست کہیں گے، یہ اتنی تیزی سے کام کرے گا۔ ہدایت بہت مبہم ہو تو یہ "سمجھنے" کے لیے سب سے پیچیدہ طریقہ اختیار کرسکتا ہے، اور ضروری نہیں کہ آپ کو بتائے کہ وہ غیرضروری راستے پر چلا گیا ہے۔
چہارم: اسے قابلِ استعمال بنانا، صرف ایک بار چلنے والا اسکرپٹ نہیں
کسی workflow کو ایک بار کامیابی سے چلانا آسان ہے۔ اصل قدر اسے ایسے "data loop" میں بدلنے میں ہے جو ہر ہفتے چل سکے اور کسی دوسری سائٹ پر بھی استعمال ہوسکے۔
Codex کے Skill mechanism سے encapsulate کرنا
Codex Skill files کو support کرتا ہے، یعنی ~/.codex/skills/ directory میں رکھی گئی Markdown format کی instruction file۔ بنیادی طور پر یہ ایک نہایت درست operation manual ہوتی ہے۔ Codex ہر بار اس Skill کو چلاتے وقت اسی SOP کے مطابق شروع سے آخر تک کام کرتا ہے، اس لیے یہ مسئلہ نہیں رہتا کہ "گزشتہ بار کچھ عارضی تبدیلیاں کی تھیں اور واپس کرنا بھول گئے"۔
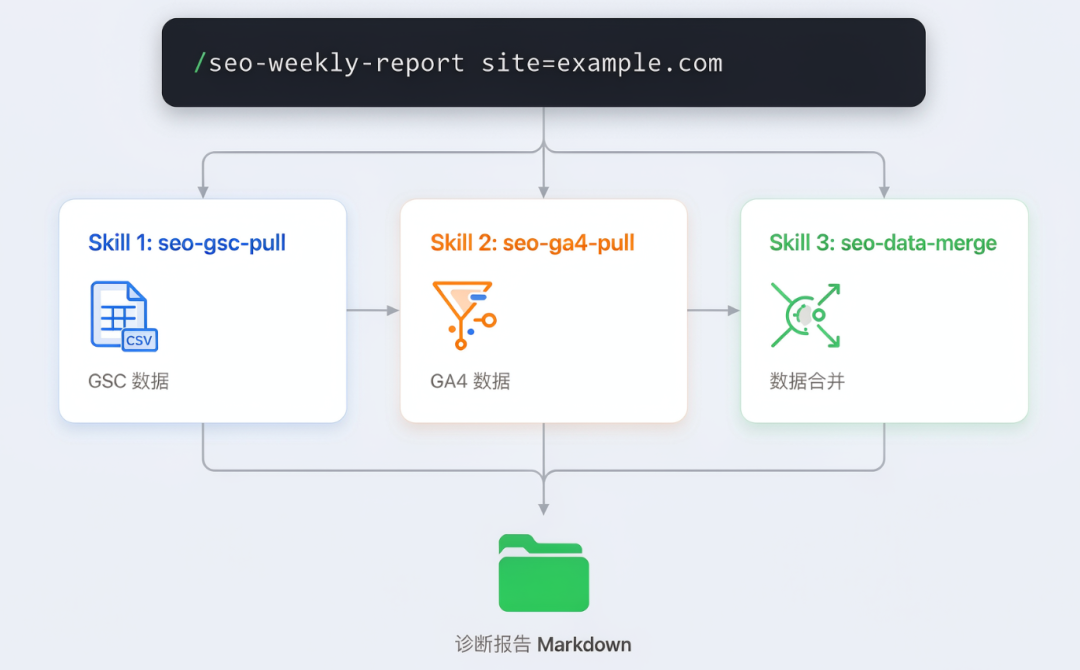
میں نے GSC+GA4 کے data retrieval→cleaning→merge→diagnosis→output workflow کو تین الگ Skills میں تقسیم کیا:
Skill|کام|Output
seo-gsc-pull|GSC query اور page dimensions کا ڈیٹا حاصل کرنا، خودکار pagination|دو CSV files: gsc_queries.csv، gsc_pages.csv
seo-ga4-pull|GA4 landing page اور conversion data حاصل کرنا، metrics خودکار طور پر match کرنا|ga4_landing.csv
seo-data-merge|تین جدولیں merge کرنا، URLs صاف کرنا، diagnostic ranking تیار کرنا|Markdown diagnostic report + merged CSV
تین حصوں میں تقسیم کرنے کا فائدہ یہ ہے کہ اگر GSC میں مسئلہ ہو تو صرف GSC والا حصہ چلائیں، اور اگر GA4 quota ناکافی ہو تو صرف GA4 والا حصہ چلائیں؛ دونوں ایک دوسرے کو نہیں روکیں گے۔ اس کے علاوہ مختلف کلائنٹس کی سائٹس کے لیے پہلے دو Skills کے data sources مختلف ہوسکتے ہیں، لیکن تیسرا Skill (merge اور diagnosis) دوبارہ استعمال ہوسکتا ہے، صرف site URL parameter تبدیل کرنا پڑتا ہے۔
ایک command سے پورا workflow چلانا
تین Skills الگ کرنے کے بعد میں نے Codex میں ایک "orchestration Skill" لکھا:
/seo-weekly-report site=example.comCodex اس ہدایت کو دیکھ کر باری باری تین Skills چلاتا ہے: GSC سے ڈیٹا حاصل کرنا، GA4 سے ڈیٹا حاصل کرنا، اور تشخیصی رپورٹ کو یکجا کرنا۔ آخر میں ٹرمینل میں P0/P1/P2 کے مطابق ترتیب دی گئی صفحہ بہ صفحہ تشخیصی رپورٹ دکھائی جاتی ہے۔ پورا عمل مکمل ہونے میں تقریباً 2 منٹ سے کچھ زیادہ وقت لگتا ہے۔
💡 "خودکاری" کا مطلب ایسا اسکرپٹ لکھنا نہیں جو کبھی خراب نہ ہو۔ اس کا مطلب ہے کسی بار بار کیے جانے والے کام کو ایسے عمل میں بدل دینا جسے ایک جملے سے شروع کیا جا سکے اور جو ڈیٹا کی تبدیلیوں کے مطابق خود کو ڈھال سکے۔
پانچواں، یہ نظام بنانے کے بعد میری عملی تبدیلی
مبالغہ نہیں، میری پیر کی صبح مکمل طور پر بدل گئی ہے۔
پہلے:
•GSC اور GA4 کا ڈیٹا دستی طور پر ایکسپورٹ، صاف اور یکجا کرنے میں 40 منٹ لگتے تھے•Excel میں رنگ لگا کر ترجیحات طے کرنے میں 20 منٹ لگتے تھے•ایک "اس ہفتے کا SEO خلاصہ" لکھ کر گروپ میں بھیجنے میں 20 منٹ لگتے تھے•گاہک جواب دیتا تھا: "موصول ہو گیا، زحمت کا شکریہ"
اب:
•پیر کو دفتر پہنچ کر ٹرمینل میں ایک سطر /seo-weekly-report ٹائپ کرتا ہوں•دو منٹ بعد تشخیصی رپورٹ reports/ ڈائریکٹری میں تیار ہوتی ہے•اسے کاپی کر کے WeChat میں پیسٹ کرتا ہوں، دو جملوں کے تبصرے شامل کرتا ہوں اور بھیج دیتا ہوں
لیکن اسی دوران ایک دلچسپ بات ہوئی۔ پہلے میں "کافی دیر مصروف رہ کر" ایک رپورٹ بھیجتا تھا، تو گاہک سمجھتا تھا کہ آپ نے بہت کام کیا ہے۔ اب آپ دو منٹ میں نتیجہ دے دیتے ہیں، تو کچھ گاہک الٹا سوچتے ہیں: "اتنی جلدی؟ کیا آپ نے واقعی غور سے دیکھا بھی ہے؟"
مضحکہ خیز ہے؟ لیکن یہ حقیقی انسانی فطرت ہے۔
اس لیے اب میں نے اپنی حکمت عملی بدل لی ہے۔ رپورٹ تیار ہونے کے بعد، میں P0 والے چند صفحات منتخب کرتا ہوں، 15 منٹ لگا کر انہیں ایک ایک کر کے کھولتا ہوں اور رپورٹ میں ایک جملہ "دستی جانچ کی رائے" کے عنوان سے شامل کرتا ہوں۔ یہ 15 منٹ ضائع نہیں ہوتے، بلکہ گاہک کو یہ احساس دلاتے ہیں کہ "کسی نے واقعی اسے دیکھا ہے"، نہ کہ یہ AI کی جانب سے نکالی گئی مشینی رپورٹ ہے۔
🔴 AI آپ کی طرف سے مشکل اور تکراری کام کرتا ہے۔ لیکن آپ کا فیصلہ، آپ کا تجربہ، اور ایک نظر مزید ڈالنے کی آپ کی آمادگی، یہ وہ حصے ہیں جنہیں خودکار نہیں بنایا جا سکتا۔ اور عین یہی وہ چیزیں ہیں جن کی گاہک سب سے زیادہ قدر کرتے ہیں۔

چھٹا، جو لوگ یہ نظام بنانا چاہتے ہیں ان کے لیے چند عملی مشورے
اگر آپ بھی Codex کے ذریعے اپنا SEO ڈیٹا کا مکمل سلسلہ چلانا چاہتے ہیں، تو یہ وہ چند باتیں ہیں جو میں نے حقیقی محنت اور وقت لگا کر سیکھی ہیں:
① شروع ہی میں کمال کے پیچھے نہ بھاگیں۔ پہلے GSC کو الگ سے مکمل طور پر چلا لیں۔
صرف ایک Skill بنائیں: گزشتہ 28 دنوں کا query data حاصل کرے اور CSV میں آؤٹ پٹ دے۔ جب یہ چلنے لگے گا، تو آپ کے پاس پہلے ہی "مکمل خودکار ranking tracking" کی صلاحیت موجود ہوگی۔ صفر سے شروع کر کے یہاں تک پہنچنے میں مجھے آدھا گھنٹہ لگا، جس کا زیادہ تر حصہ Google Cloud کی اجازتوں سے نمٹنے میں صرف ہوا۔ پہلا Skill کامیابی سے چلنے کے بعد ذہنی رکاوٹ بھی ختم ہو گئی۔
② تصدیقی فائلوں کو محفوظ رکھیں، یہی پورے سلسلے کا "اہم ترین کمزور مقام" ہے۔
Google Cloud کی Service Account JSON کلید کی فائل ایک بار افشا ہو جائے تو دوسرے لوگ آپ کے GSC اور GA4 کو پڑھ اور لکھ سکتے ہیں۔ اس فائل کو Git repository میں نہ رکھیں۔ راستے کے لیے environment variable استعمال کریں، اور Codex کے Skill میں `${GSC_CREDENTIALS_PATH}` جیسا حوالہ دیں، اسے hard-code نہ کریں۔
③ Codex کے لاگز میں ہر مرحلے کا دورانیہ درج کروائیں۔
Skill میں ایک جملہ شامل کریں: "براہ کرم ہر مرحلے کی کارروائی کے بعد اس کا دورانیہ درج کریں۔" یہ دکھاوے کے لیے نہیں، بلکہ یہ جاننے کے لیے ہے کہ رکاوٹ کہاں ہے: GSC API سے ڈیٹا حاصل کرنے میں، GA4 کی متعدد صفحات میں تقسیم شدہ درخواستوں میں، یا URL صاف کرنے کے منطق میں؟ مسئلہ معلوم ہو تو ہی ہدف کے مطابق بہتری لائی جا سکتی ہے۔
④ متعدد سائٹس پر دوبارہ استعمال کرنے سے پہلے، یہ یقینی بنائیں کہ نئی اور پرانی سائٹس کی GA4 property structure یکساں ہے۔
ایک ہی Skill گاہک A پر معمول کے مطابق چلتا ہے، مگر گاہک B پر خرابی دیتا ہے، تو 80% صورتوں میں وجہ یہ ہوتی ہے کہ دونوں GA4 properties میں custom dimensions اور event names مختلف ہوتے ہیں۔ نئی سائٹ پر پہلی بار چلانے سے پہلے، Codex سے کہیں کہ وہ پہلے ایک بار GA4 Metadata حاصل کر کے structure دیکھے۔
📊 میرا عملی ڈیٹا: ایک گاہک کے لیے شروع سے مکمل عمل تیار کرنے میں تقریباً 45 منٹ لگتے ہیں، جس میں Google کی اجازتوں کی ترتیب بھی شامل ہے۔ اس کے بعد ہر ہفتے اسے چلانے میں تقریباً 2 منٹ لگتے ہیں۔
GitHub پر Codex کے چند اوپن سورس SEO Skills موجود ہیں جنہیں براہ راست لے کر تبدیل کیا جا سکتا ہے۔ owensky-dev نے seo-gsc-ga4-analyst نامی Skill بنائی ہے، جبکہ AminForou نے mcp-gsc نامی MCP سرور بنایا ہے۔ آپ کو پہیہ دوبارہ ایجاد کرنے کی ضرورت نہیں۔ کوئی تیار Skill لے کر ایک بار چلائیں، آؤٹ پٹ دیکھیں، پھر اپنی ضروریات کے مطابق اسے تبدیل کریں۔ صفر سے لکھنے کے مقابلے میں یہ 10 گنا تیز ہے۔
یقیناً، تیار Skill سے حاصل ہونے والا آؤٹ پٹ آپ کی ضروریات سے مکمل طور پر مطابقت نہیں رکھتا۔ مثلاً owensky-dev کی Skill ڈیفالٹ طور پر 90 دن کا ڈیٹا حاصل کرتی ہے، جبکہ میں ذاتی طور پر 28 دن کی مدت کا تجزیہ کرنے کا عادی ہوں۔ Skill فائل میں ایسی معمولی تبدیلی کے لیے صرف ایک parameter تبدیل کرنا ہوتا ہے؛ Codex آپ کی ترمیم پڑھ کر اسی کے مطابق عمل کرے گا۔
پورے عمل، یعنی ایک خیال سے لے کر مستحکم طور پر چلنے والے نظام تک پہنچنے میں، مجھے تقریباً دو دوپہر لگیں۔ پہلی دوپہر اجازتوں اور API integration میں گزری، جبکہ دوسری دوپہر Skill لکھنے اور آؤٹ پٹ format کو بہتر بنانے میں۔ اس کے بعد ہر ہفتے یہ نظام ان دو دوپہروں کا وقت مجھے واپس بچا رہا ہے۔
گزشتہ ہفتے ایک ایسے ساتھی نے، جو بیرونِ ملک تجارت کی سائٹ چلاتا ہے، مجھ سے پوچھا: "آپ ڈیٹا دیکھنے کے لیے کون سا tool استعمال کرتے ہیں؟"
میں نے کہا: Codex۔
اس نے پوچھا کہ کیا یہ بہت مہنگا ہے۔
میں نے کہا: اتنا مہنگا نہیں جتنا پچھلے ہفتے آپ نے Excel میں وقت صرف کیا تھا۔
وہ چند سیکنڈ خاموش رہا۔ پھر بولا: "تو وہ Skill مجھے بھی بھیج دیں۔"