

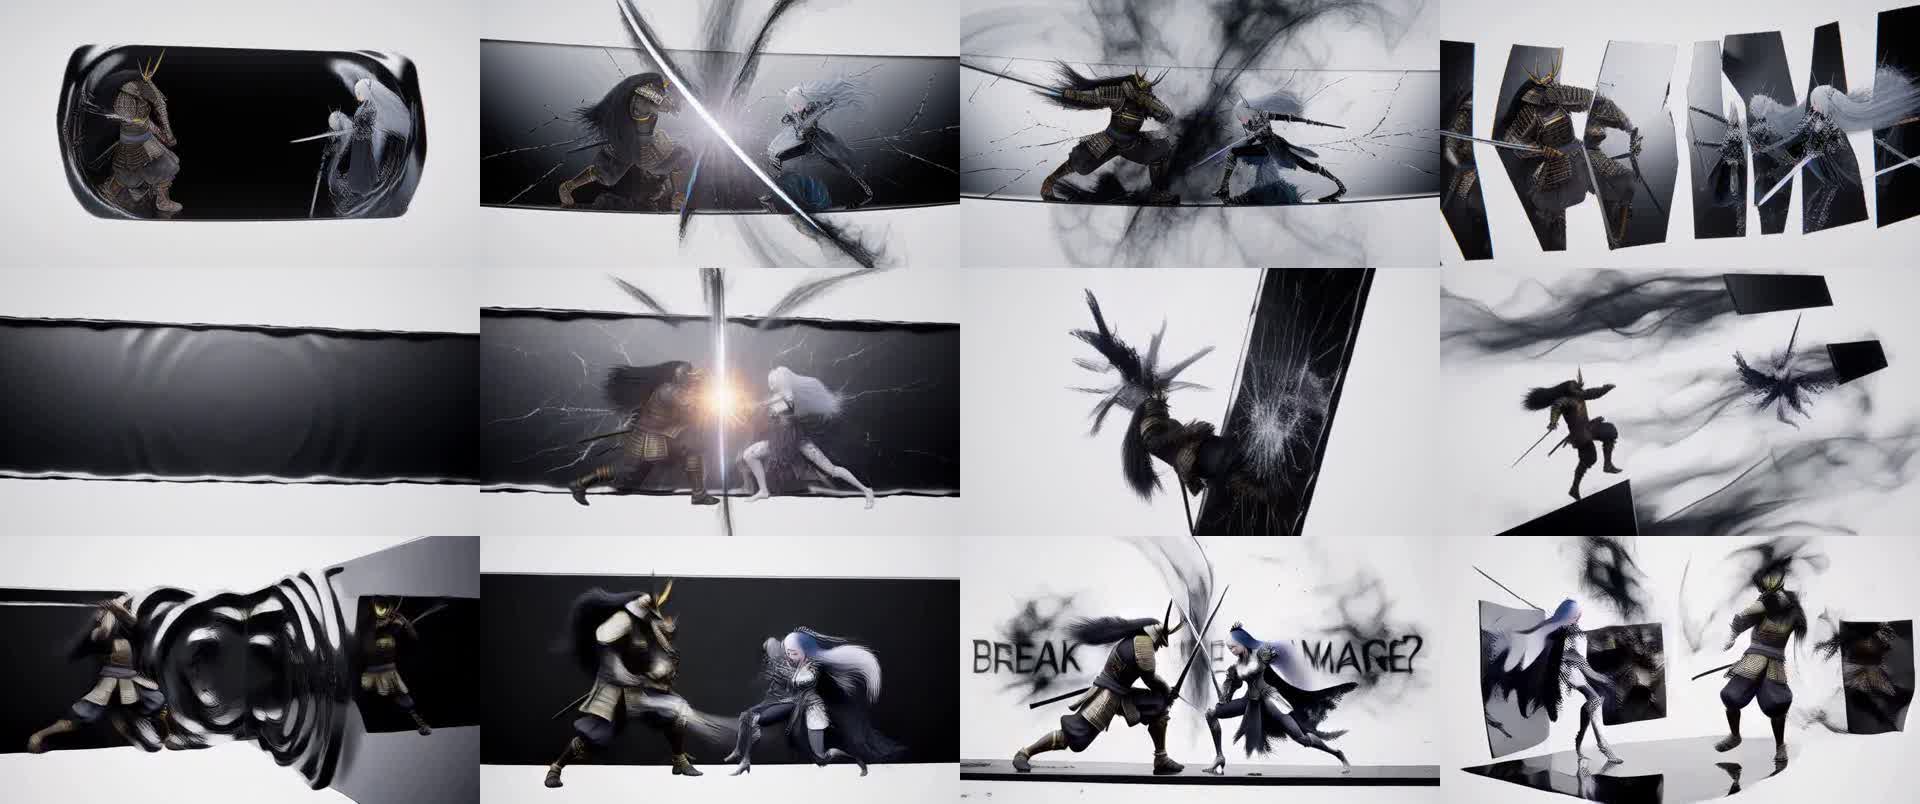
یہ پروجیکٹ کیا کرتا ہے
یہ ریپوزٹری Apple Silicon پر TensorFold کے لیے MiniMax H3 ویڈیو ماڈل پیکیج کرتی ہے۔ یہ TensorFold کی H3 فیملی کو MLX int8 Metal kernels اور LightX2V Turbo adapter کے ساتھ یکجا کرتی ہے تاکہ ہم وقت ساز سٹیریو آڈیو کے ساتھ ویڈیو تیار کی جا سکے۔
یہ پیک text-to-video کو سپورٹ کرتا ہے اور ورژن 1.1 سے فراہم کردہ پہلے فریم کے ذریعے image-to-video کو بھی سپورٹ کرتا ہے۔ 256 GB میموری والے Mac Studio M5 Ultra پر، Turbo adapter کے ساتھ 5 سیکنڈ کا 864x480 کلپ تقریباً 50 سیکنڈ لیتا ہے۔ دستاویزی benchmark حالات میں 768x448 کلپ تقریباً 40 سیکنڈ لیتا ہے۔
یہ ریپوزٹری سرور یا پروڈکٹ کے بجائے development render path ہے۔ یہاں کوئی tensorfold generate کمانڈ نہیں؛ ہر render کے لیے شامل scripts کے ذریعے ماڈل لوڈ ہوتا ہے۔
اہم خصوصیات
- Text-to-video: منظر بیان کریں اور ویڈیو و سٹیریو آڈیو کے ساتھ MP4 تیار کریں۔
- Image-to-video: پہلا فریم فراہم کریں اور اس کے بعد ہونے والی کارروائی بیان کریں۔
- Turbo generation: LightX2V adapter دستاویزی تیز رفتار طریقے میں render کو تین forwards تک محدود کر دیتا ہے۔
- MLX اور int8 kernels: منتخب transformer اور decoder آپریشنز مطابقت رکھنے والے M5 tensor hardware پر int8 Metal kernels استعمال کرتے ہیں۔
- قابلِ تکرار setup: installer، TensorFold، MLX، معاون libraries، model revisions اور adapter checksums کو مخصوص versions پر مقفل کرتا ہے۔
- اختیاری base-model rendering: adapter کو غیر فعال کریں اور base model کے قریب render کے لیے تقریباً 20 sampling steps استعمال کریں۔
ہارڈویئر اور سافٹ ویئر کی ضروریات
شائع کردہ کارکردگی کے اعداد و شمار 256 GB unified memory والے Mac Studio M5 Ultra پر macOS 27.0.1 چلا کر ناپے گئے۔ پروجیکٹ کے مطابق کم از کم 128 GB میموری درکار ہے، جبکہ adapter merge تقریباً 103 GB peak memory تک پہنچ سکتا ہے۔ adapter کے بغیر peak memory تقریباً 65 GB درج ہے۔
int8 kernels کے لیے Metal 4 tensor operations درکار ہیں، اس لیے رپورٹ کردہ acceleration مطابقت رکھنے والے M5 hardware کے لیے ہے۔ ان operations کے بغیر systems پر H3 family bfloat16 میں چلتی ہے اور README میں بیان کردہ C-based alternatives سے سست ہو سکتی ہے۔
آپ کو Homebrew، Python 3.11، uv اور FFmpeg بھی درکار ہوں گے۔ MiniMax H3 model download تقریباً 144 GB اور Turbo adapter تقریباً 1.96 GB ہے۔
پروجیکٹ انسٹال کریں
ریپوزٹری clone کریں اور مطلوبہ host tools انسٹال کریں:
git clone https://github.com/drowzeys/keys-Mac-TensorFold-MiniMax-H3-MLX.git
cd keys-Mac-TensorFold-MiniMax-H3-MLX
brew install python@3.11 uv ffmpeg
ایک مرحلے والا setup script چلائیں:
bash oneshot-setup.shinstaller ~/.local/opt/tensorfold-h3 پر isolated environment بناتا ہے اور H3 family کے ساتھ TensorFold 0.6.5 اور مخصوص dependency lock انسٹال کرتا ہے۔ Docker دستیاب ہونے پر یہ پروجیکٹ کے GHCR prebuilt carrier سے checksum-verified TensorFold payload حاصل کر سکتا ہے؛ بصورتِ دیگر Git سے مطابقت رکھنے والا source commit حاصل کرتا ہے۔
Setup مطلوبہ minimax-h3-mlx revision کو بھی clone کرتا ہے، MiniMax H3 FL2VA partition کو ~/h3-models/MiniMax-H3 میں download کرتا ہے، Turbo adapter download کرتا ہے اور test clip کو outputs/test.mp4 میں render کرتا ہے۔
موجودہ installation کو دوبارہ انسٹال کیے بغیر جانچنے کے لیے چلائیں:
bash oneshot-setup.sh --verifyابتدائی test render چھوڑنے کے لیے استعمال کریں:
bash oneshot-setup.sh --no-render
آپ PREFIX اور H3_MODEL_DIR environment variables کے ذریعے default installation اور model locations تبدیل کر سکتے ہیں۔
Text-to-video کلپ تیار کریں
prompt اور output filename کے ساتھ scripts/generate.sh استعمال کریں:
bash scripts/generate.sh "A hummingbird hovering over red flowers, soft wing hum" out.mp4default path configured Turbo adapter اور ریپوزٹری کی default generation settings استعمال کرتا ہے۔ prompt میں بصری منظر اور، جہاں مفید ہو، مطلوبہ آڈیو دونوں بیان کیے جاتے ہیں۔
متعین نتیجے کے لیے seed فراہم کریں اور معاون canvas منتخب کریں:
WIDTH=768 HEIGHT=448 SEED=7 bash scripts/generate.sh "A quiet train crossing a snowy valley at dawn" out.mp4آپ prompts کو text file میں رکھ سکتے ہیں۔ ایسی صورت میں prompt argument خالی دیں اور PROMPT_FILE مقرر کریں:
PROMPT_FILE=prompts/black-mirror-scene.txt SEED=2077 bash scripts/generate.sh "" out.mp4Image-to-video کلپ تیار کریں
FIRST_FRAME کو image file پر مقرر کریں۔ تصویر پہلا فریم بنے گی، جبکہ prompt اس کے بعد ہونے والی حرکت یا واقعے کی وضاحت کرے گا:
FIRST_FRAME=photo.jpg WIDTH=1344 HEIGHT=768 bash scripts/generate.sh "She turns to the camera and smiles" out.mp4تصویر کو منتخب canvas کے مطابق کھینچا جاتا ہے، اس لیے یکساں aspect ratio والی dimensions منتخب کریں یا render سے پہلے تصویر crop کریں۔ README میں 16:9 کے لیے 1344x768، 9:16 کے لیے 768x1344 اور square content کے لیے 768x768 تجویز کیا گیا ہے۔
MiniMax طرز کے image-to-video prompts میں پہلے فریم کی واضح نشاندہی کی جا سکتی ہے، مثلاً:
For the target video, at 0.00 seconds into the target video, <Picture 1> (from [Shot 1]) is fully referenced. The subject walks through the doorway and looks toward the window.پہلے فریم کی تخلیق Turbo اڈاپٹر اور 20 مراحل والے بنیادی راستے کے ساتھ دستیاب ہے۔ آخری فریم اور حوالہ جاتی تصویر کے موڈز اس پیک میں شامل نہیں کیے گئے۔
فریمز، ریزولوشن اور سیمپلنگ کو کنٹرول کریں
فریمز کی تعداد 17n + 5 کی صورت کے مطابق ہونی چاہیے۔ README میں معاون مثالوں کے طور پر 56، 73، 90، 124، 192، 243 اور 362 فریمز شامل ہیں۔ چوڑائی اور اونچائی 32 کے مضرب ہونی چاہیے، جبکہ جاری کردہ ماڈل کی حد کل کینوس کے لیے زیادہ سے زیادہ 768x1344 پکسلز ہے۔
تیز Turbo راستہ تین فارورڈز استعمال کرتا ہے۔ اڈاپٹر کو غیر فعال کرنے اور 20 مراحل کی رینڈرنگ کے لیے ADAPTER=none اور POINTS=21 سیٹ کریں:
ADAPTER=none POINTS=21 bash scripts/generate.sh "A lantern glowing beside a forest path" base-model.mp4README اس ترتیب کو بنیادی ماڈل کے زیادہ قریب قرار دیتا ہے، جبکہ Turbo تیزی سے واضح فریمز تیار کر سکتا ہے، لیکن کبھی کبھار کرداروں کو دہرا سکتا ہے۔ ایک ہی seed کے باوجود دونوں موڈز مختلف کمپوزیشنز تیار کر سکتے ہیں۔
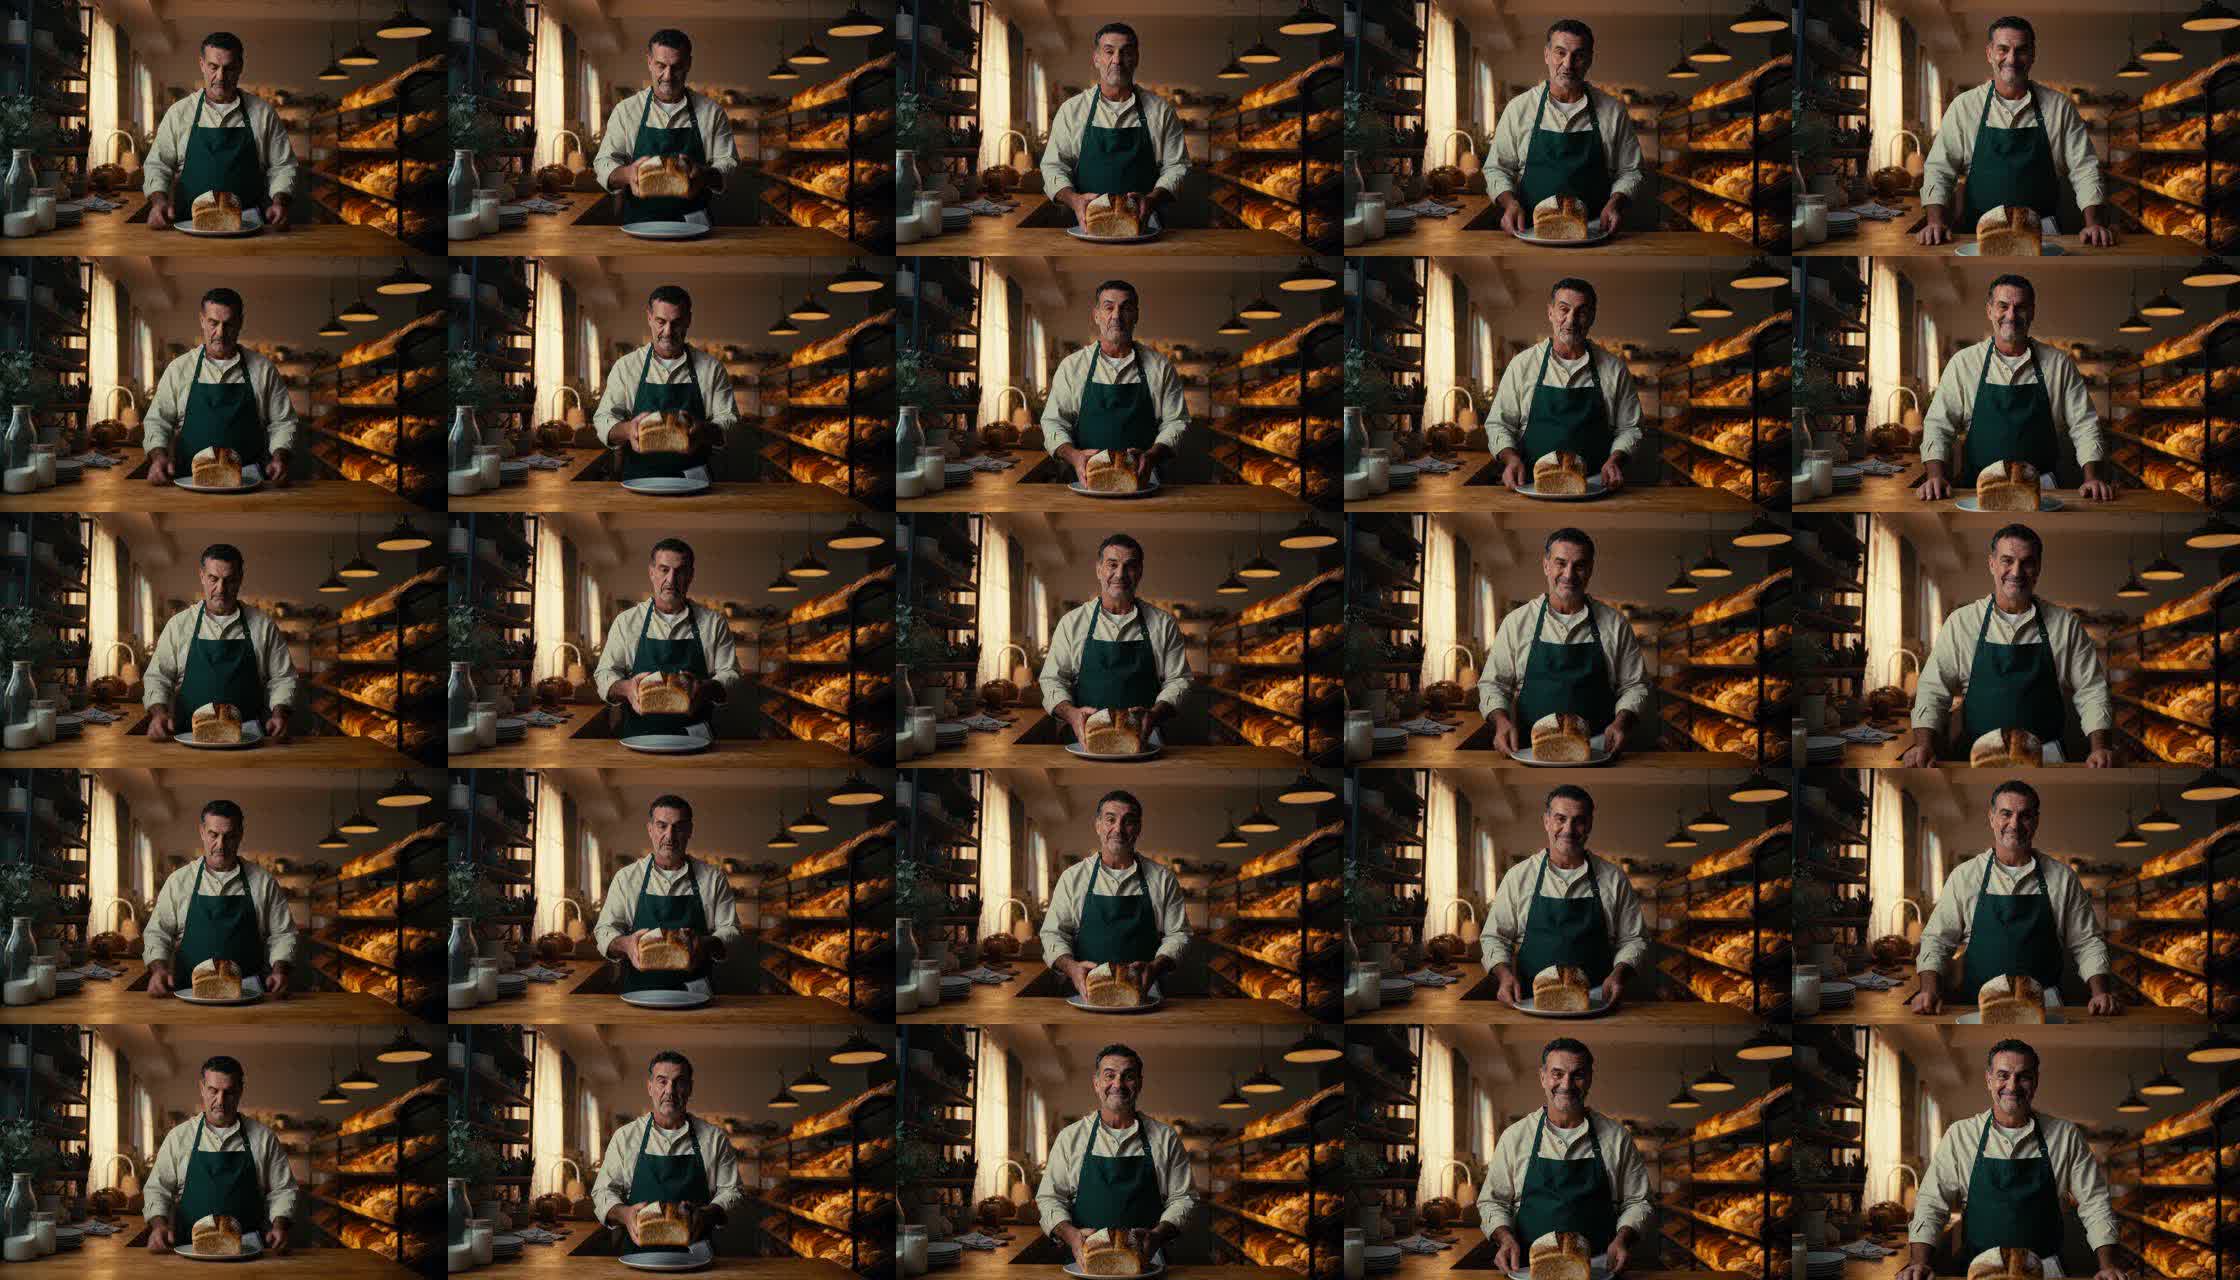
رفتار کے تبادلے کو سمجھیں
رفتار میں سب سے بڑا اضافہ Turbo اڈاپٹر کے 20 کے بجائے تین فارورڈز استعمال کرنے سے ہوتا ہے۔ معاون M5 ٹینسر ہارڈویئر پر int8 SwiGLU MLP، int8 QKV آپریشنز، اٹینشن آؤٹ پٹ اور ویڈیو ڈیکوڈر کرنلز مزید بہتری فراہم کرتے ہیں۔
دستاویزی 864x480 بینچ مارک میں، Turbo راستے نے ڈینوائزنگ کے لیے تقریباً 27.6 سیکنڈ اور مجموعی طور پر تقریباً 50 سیکنڈ لیے، جس میں ٹیکسٹ انکوڈنگ، لوڈنگ اور کوانٹائزیشن، اور ڈیکوڈنگ شامل ہیں۔ اسی تقابل میں 20 مراحل والی TensorFold int8 رینڈرنگ نے مجموعی طور پر تقریباً 210 سیکنڈ لیے۔
یہ اعداد ہارڈویئر کے لیے مخصوص ہیں اور انہیں عمومی نہیں سمجھنا چاہیے۔ ریپوزٹری یہ بھی بتاتی ہے کہ اٹینشن اب بھی MLX scaled dot-product attention استعمال کرتی ہے، کیونکہ ناپی گئی int8 فلیش طرز کی متبادل تکنیک نے رفتار میں مفید اضافہ فراہم نہیں کیا۔
اعلیٰ درجے کی تنصیب اور ورک فلو کے نکات
پہلے سے تیار carrier استعمال کریں
انسٹالر GHCR carrier استعمال کر سکتا ہے، لیکن carrier Mac runtime نہیں ہے۔ Metal کنٹینر کے اندر نہیں چلتا؛ carrier صرف TensorFold wheel، dependency lock، generation script اور native installation کے لیے checksums فراہم کرتا ہے۔
docker pull ghcr.io/drowzeys/keys-mac-tensorfold-minimax-h3-mlx:1.1
docker run --rm -v "$PWD":/out ghcr.io/drowzeys/keys-mac-tensorfold-minimax-h3-mlx:1.1 cp -a /payload/. /out/payload/
carrier کو دوبارہ بنانے اور push کرنے کے لیے ریپوزٹری یہ کمانڈ فراہم کرتی ہے:
PUSH=1 bash scripts/build-carrier.shمیموری کے استعمال کو مدنظر رکھیں
ماڈل لوڈ کرنا اور اڈاپٹر کو merge کرنا بہت زیادہ میموری استعمال کرتا ہے۔ رینڈر شروع کرنے سے پہلے غیر ضروری ایپلی کیشنز بند کر دیں، خاص طور پر Turbo اڈاپٹر استعمال کرتے وقت۔ ریپوزٹری کے مطابق ہر run میں AdaLN ٹیبلز کو ایک بار project کرنا اور weights جاری کرنا اس کے ناپے گئے راستے میں تقریباً 24 GiB بچاتا ہے۔
درست image-to-video کینوس منتخب کریں
چونکہ پہلی تصویر کو اس کی کمپوزیشن برقرار رکھنے کے لیے خودکار طور پر crop کرنے کے بجائے کھینچا جاتا ہے، اس لیے source image کو ہدف aspect ratio کے مطابق تیار کریں۔ اس سے portrait، landscape یا square clips بناتے وقت ناپسندیدہ distortion سے بچا جا سکتا ہے۔
متبادل اڈاپٹر احتیاط سے استعمال کریں
لوڈر FastH3 کو اڈاپٹر path اور POINTS=5 کے ذریعے پڑھ سکتا ہے، مثلاً ADAPTER=.../adapter_model.safetensors کے ساتھ۔ README کے مطابق اس path کو 864x480 پر آزمایا گیا، test prompt پر 76 سیکنڈ لگے، اور یہ Turbo کے مقابلے میں زیادہ مصروف دکھائی دیا۔ اسے 1344x768 کے لیے شائع کیا گیا تھا، جسے اس project میں آزمایا نہیں گیا۔
معیار کے تقابل کی درست تشریح کریں
README واضح کرتا ہے کہ معیار کی جامع درجہ بندی نہیں کی گئی۔ int8 path bfloat16 کمپوزیشن برقرار رکھتے ہوئے تفصیلات تبدیل کر سکتا ہے، اور تین فارورڈز والی Turbo رینڈرنگ bfloat16 Turbo رینڈرنگ سے مختلف ہو سکتی ہے۔ اس لیے بینچ مارک ٹیبلز یکساں motion یا audio quality کی ضمانت دینے کے بجائے ناپی گئی رفتار اور منتخب stills کا تقابل کرتی ہیں۔
لائسنس اور project کی حالت
یہ پیک model weights فراہم نہیں کرتا۔ MiniMax H3 ڈاؤن لوڈ کرنے سے پہلے MiniMax H3 Community License پڑھیں، جس میں اس کی علاقائی پابندیاں بھی شامل ہیں۔ ریپوزٹری کے credits بھی دیکھیں اور حسبِ ضرورت اصل MiniMax، TensorFold، MLX، H3، اڈاپٹر اور متعلقہ project مصنفین کا حوالہ دیں۔
یہاں استعمال ہونے والے H3 family کو جاری کردہ TensorFold version کا حصہ بننے کے بجائے upstream کے مجوزہ draft pull request کے طور پر بیان کیا گیا ہے۔ اس لیے setup کو دوبارہ تیار کرنے کے لیے دستاویزی revisions کو pin کرنا اہم ہے۔
نتیجہ
یہ ریپوزٹری مطابقت رکھنے والے Apple Silicon Macs پر MiniMax H3 ویڈیو جنریشن کو native طور پر چلانے کا ایک مرکوز طریقہ فراہم کرتی ہے۔ pinned environment انسٹال کرنے اور model ڈاؤن لوڈ کرنے کے بعد آپ text-to-video clips رینڈر کر سکتے ہیں، پہلے frame کو animate کر سکتے ہیں، تیز Turbo اڈاپٹر اور 20 مراحل والے بنیادی راستے کے درمیان تبدیل ہو سکتے ہیں، اور canvas، frame count، seed اور prompt settings کو ایڈجسٹ کر سکتے ہیں۔ میموری اور اسٹوریج کی نمایاں ضروریات کے لیے تیار رہیں، اور شائع شدہ timings کو عمومی ضمانتوں کے بجائے مخصوص M5 system کی پیمائش سمجھیں۔