

WeMM-Embedding کیا ہے؟
WeMM-Embedding عالمگیر کثیر الوسائط ایمبیڈنگ ماڈلز کا ایک خاندان ہے جسے WeChat Vision ٹیم نے تیار کیا ہے۔ یہ متن، تصاویر، ویڈیوز، بصری دستاویزات اور باہم مربوط کثیر الوسائط ان پٹس کو متحد ویکٹر نمائندگیوں میں تبدیل کرتا ہے۔ یہ ویکٹر ایسے ورک فلو کو سپورٹ کر سکتے ہیں جن میں مختلف موڈیلٹیز کے مواد کی نمائندگی اور باہمی موازنہ درکار ہو۔
ہر ماڈل آخری پرت کی مخفی حالت سے مخصوص <embedding> ٹوکن پوزیشن پر ایمبیڈنگ حاصل کرتا ہے اور پھر L2 نارملائزیشن لاگو کرتا ہے۔ آڈیو ان پٹ فی الحال معاونت یافتہ نہیں ہے۔
اہم خصوصیات
- متحد کثیر الوسائط نمائندگیاں: ایک ہی ماڈل خاندان متن، تصاویر، ویڈیوز، بصری دستاویزات اور باہم مربوط ان پٹس کو سنبھالتا ہے۔
- ماڈل کے متعدد سائز: 2B، 4B اور 9B پیرامیٹر والے ورژنز میں سے انتخاب کریں۔
- Matryoshka Representation Learning: جہاں اسٹوریج یا ریٹریول کی کارکردگی اہم ہو، وہاں معاونت یافتہ مختصر ویکٹر ڈائمینشنز استعمال کریں۔
- انفرنس کے دو انٹرفیس: Transformers اور Sentence Transformers دونوں کے لیے مثالیں فراہم کی گئی ہیں۔
- پروڈکشن سروسنگ: ریپوزٹری میں vLLM اور SGLang کے لیے کنفیگریشنز اور ریپر اسکرپٹس شامل ہیں۔
- تشخیصی ٹولنگ: شامل MMEB-v3 پائپ لائن سنگل نوڈ اور ملٹی نوڈ انفرنس کو سپورٹ کرتی ہے۔
ماڈل اور ڈائمینشن منتخب کریں
ماڈل زو میں Hugging Face پر تین ورژنز موجود ہیں۔ اپنے دستیاب کمپیوٹ اور مطلوبہ مکمل ایمبیڈنگ سائز کے مطابق ماڈل منتخب کریں۔
- WeMM-Embedding-2B: 64، 128، 256، 512، 1024 اور 2048 ڈائمینشنز کو سپورٹ کرتا ہے۔
- WeMM-Embedding-4B: 64، 128، 256، 512، 1024 اور 2560 ڈائمینشنز کو سپورٹ کرتا ہے۔
- WeMM-Embedding-9B: 64، 128، 256، 512، 1024، 2048 اور 4096 ڈائمینشنز کو سپورٹ کرتا ہے۔
چھوٹی معاونت یافتہ ڈائمینشن ویکٹر اسٹوریج اور بعد کی کمپیوٹیشن کم کرتی ہے۔ مثال کے طور پر، README کے مطابق 256 ڈائمینشنز والا 2B ماڈل MMEB-v2 پر اپنی مکمل ڈائمینشن والی تصویری اور ویڈیو کارکردگی کا 98.7% برقرار رکھتا ہے۔
انسٹالیشن اور سیٹ اپ
1. ریپوزٹری اور ماڈل حاصل کریں
ریپوزٹری کی مقامی کاپی سے کام کریں، پھر اس کے Hugging Face صفحے سے ماڈل ڈاؤن لوڈ کریں یا متعلقہ مثال کو اس طرح ترتیب دیں کہ معاونت کی صورت میں Hugging Face ماڈل شناخت کنندہ استعمال کرے۔
2. انحصارات انسٹال کریں
پروجیکٹ میں بیان کردہ ورژنز انسٹال کریں:
pip install -r requirements.txt3. Transformers کو قابل تکرار نتائج کے لیے مقرر کریں
پروجیکٹ انفرنس اور قابل تکرار نتائج کے لیے transformers==5.2.0 کی تجویز دیتا ہے، کیونکہ نئے ریلیزز کے پری پروسیسنگ رویے مختلف ہو سکتے ہیں۔
pip install transformers==5.2.0مثالیں چلانے سے پہلے اپنے ماڈل، ٹیسٹ امیج اور ٹیسٹ ویڈیو کے راستے تیار کریں۔
Transformers کے ساتھ بنیادی استعمال
Transformers کی مثال متن، تصویر اور ویڈیو ان پٹس کے لیے علیحدہ ایمبیڈنگز تیار کرتی ہے۔ اسے مقامی ماڈل پاتھ اور معاونت یافتہ آؤٹ پٹ ڈائمینشن کے ساتھ چلائیں:
python examples/transformers_inference.py \
  --model /path/to/WeMM-Embedding-2B \
  --image /path/to/image.jpg \
  --video /path/to/video.mp4 \
  --dimension 2048
پلیس ہولڈر راستوں کو اپنے سسٹم کی فائلوں سے تبدیل کریں۔ 2B ماڈل کے لیے 2048 مکمل ویکٹر سائز ہے۔ ماڈل کی مکمل ایمبیڈنگ ڈائمینشن کو واضح طور پر بتائے بغیر حاصل کرنے کے لیے --dimension حذف کر دیں:
python examples/transformers_inference.py \
  --model /path/to/WeMM-Embedding-2B \
  --image /path/to/image.jpg \
  --video /path/to/video.mp4
Sentence Transformers کے ساتھ بنیادی استعمال
Sentence Transformers کی مثال متن، تصویر اور ویڈیو ان پٹس کو SentenceTransformer.encode() کے ذریعے پروسیس کرتی ہے۔ یہ --dimension کے ذریعے Matryoshka ڈائمینشن کے انتخاب کو بھی سپورٹ کرتی ہے۔
python examples/sentence_transformers_inference.py \
  --model /path/to/WeMM-Embedding-2B \
  --image /path/to/image.jpg \
  --video /path/to/video.mp4 \
  --dimension 2048
چونکہ SentenceTransformer ماڈل کو براہِ راست لوڈ کر سکتا ہے، اس لیے آپ مقامی پاتھ کی جگہ Hugging Face ماڈل شناخت کنندہ استعمال کر سکتے ہیں:
python examples/sentence_transformers_inference.py \
  --model tencent/WeMM-Embedding-2B \
  --image /path/to/image.jpg \
  --video /path/to/video.mp4 \
  --dimension 2048
Matryoshka ایمبیڈنگز درست طریقے سے استعمال کریں
Matryoshka ایمبیڈنگز مکمل ویکٹر کو منتخب ماڈل کی معاونت یافتہ ڈائمینشنز میں سے کسی ایک تک مختصر کرنے کی سہولت دیتی ہیں۔ آخری محور کو کاٹیں اور پھر مختصر کیے گئے ویکٹر کو دوبارہ نارملائز کریں:
embedding = torch.nn.functional.normalize(
    embedding[..., :d],
    dim=-1
)
d کو صرف اپنے ماڈل کے لیے درج شدہ ڈائمینشن پر سیٹ کریں۔ دوسری نارملائزیشن اہم ہے، کیونکہ کاٹنے سے ویکٹر کا نورم تبدیل ہو جاتا ہے۔ فراہم کردہ کمانڈ لائن مثالیں استعمال کرتے وقت مطلوبہ Matryoshka ڈائمینشن --dimension کے ذریعے منتخب کریں۔
vLLM کے ساتھ ماڈل سروس کریں
ریپوزٹری کے مطابق vLLM 0.27.0 کے ساتھ ٹیسٹنگ کی گئی ہے۔ پولنگ سرور شروع کریں اور ماڈل کا ایمبیڈنگ چیٹ ٹیمپلیٹ فراہم کریں:
MODEL_PATH=/path/to/WeMM-Embedding-2B
vllm serve "$MODEL_PATH" \
  --runner pooling \
  --chat-template "$MODEL_PATH/embedding_chat_template.jinja"
اس کے مساوی ریپر scripts/serve_vllm.sh پر دستیاب ہے۔
SGLang کے ساتھ ماڈل سروس کریں
SGLang 0.5.9 پروجیکٹ میں دستاویز کردہ آزمودہ ورژن ہے۔ ایمبیڈنگ سرور شروع کرنے سے پہلے فراہم کردہ ویڈیو پیچ لاگو کریں:
MODEL_PATH=/path/to/WeMM-Embedding-2B
python scripts/patch_sglang_video.py
python -m sglang.launch_server \
  --model-path "$MODEL_PATH" \
  --is-embedding \
  --enable-precise-embedding-interpolation
ریپوزٹری ایک کمانڈ میں کام کرنے والے ریپر کے طور پر scripts/serve_sglang.sh بھی فراہم کرتی ہے۔
MMEB-v3 کی جانچ چلائیں
mmeb_v3_eval/ ڈائریکٹری میں رپورٹ کردہ MMEB-v3 نتائج کے لیے استعمال ہونے والا جانچ کا کوڈ موجود ہے۔ یہ سرکاری VLM2Vec پائپ لائن پر مبنی ہے اور اس میں WeMM-Embedding بیک بون، ہم آہنگ ڈیٹاسیٹ ہدایات، بیچ شدہ انفرنس، متعدد نوڈز اور متعدد GPUs پر عمل درآمد، اور 64 فریم کی ویڈیو سیمپلنگ شامل ہیں۔
پہلے جانچ کی ڈائریکٹری میں جائیں اور ڈیٹا ڈاؤن لوڈ کریں:
cd mmeb_v3_eval
DATA_ROOT=/path/to/MMEB-V3 bash scripts/download_data.sh
پھر اپنے ماڈل، ڈیٹاسیٹ اور آؤٹ پٹ کے راستوں کے ساتھ جانچ چلائیں:
MODEL_PATH=/path/to/WeMM-Embedding-2B \
DATA_BASEDIR=/path/to/MMEB-V3 \
OUTPUT_DIR=exps/wemm_embedding \
bash scripts/run_eval.sh
دستاویزی ڈیٹا سیٹ اپ اور سنگل نوڈ یا متعدد نوڈز کے کمانڈز کے لیے mmeb_v3_eval/README.md دیکھیں۔
اعلیٰ درجے کی تجاویز
- ابعاد کو ماڈل کے مطابق رکھیں: 2B ماڈل سے 2560 ابعاد یا 4B ماڈل سے 4096 ابعاد طلب نہ کریں۔ منتخب کردہ چیک پوائنٹ کے لیے درج صرف وہی ابعاد استعمال کریں۔
- مختصر کیے گئے ویکٹرز کو دوبارہ نارملائز کریں: اگر آپ مکمل ایمبیڈنگ کو دستی طور پر مختصر کرتے ہیں تو اس کے بعد ہمیشہ L2 نارملائزیشن لاگو کریں۔
- پری پروسیسنگ کو قابل تکرار رکھیں: نتائج کو دوبارہ تیار کرتے وقت تجویز کردہ Transformers ورژن استعمال کریں، کیونکہ ریلیزز کے درمیان پری پروسیسنگ تبدیل ہو سکتی ہے۔
- مناسب لوڈنگ طریقہ استعمال کریں: دستاویزی Transformers کمانڈ ماڈل پاتھ استعمال کرتی ہے، جبکہ Sentence Transformers کی مثال
tencent/WeMM-Embedding-2Bکو براہ راست بھی لوڈ کر سکتی ہے۔ - غیر معاون آڈیو کا خیال رکھیں: ماڈلز فی الحال آڈیو قبول نہیں کرتے، اس لیے رپورٹ کردہ MMEB-v3 آڈیو اسکور صفر ہے۔
- سہولت کے لیے سرونگ ریپرز استعمال کریں:
scripts/میں موجود شیل اسکرپٹس دستاویزی vLLM اور SGLang لانچ کنفیگریشنز کو پیک کرتی ہیں۔
کارکردگی کا پس منظر
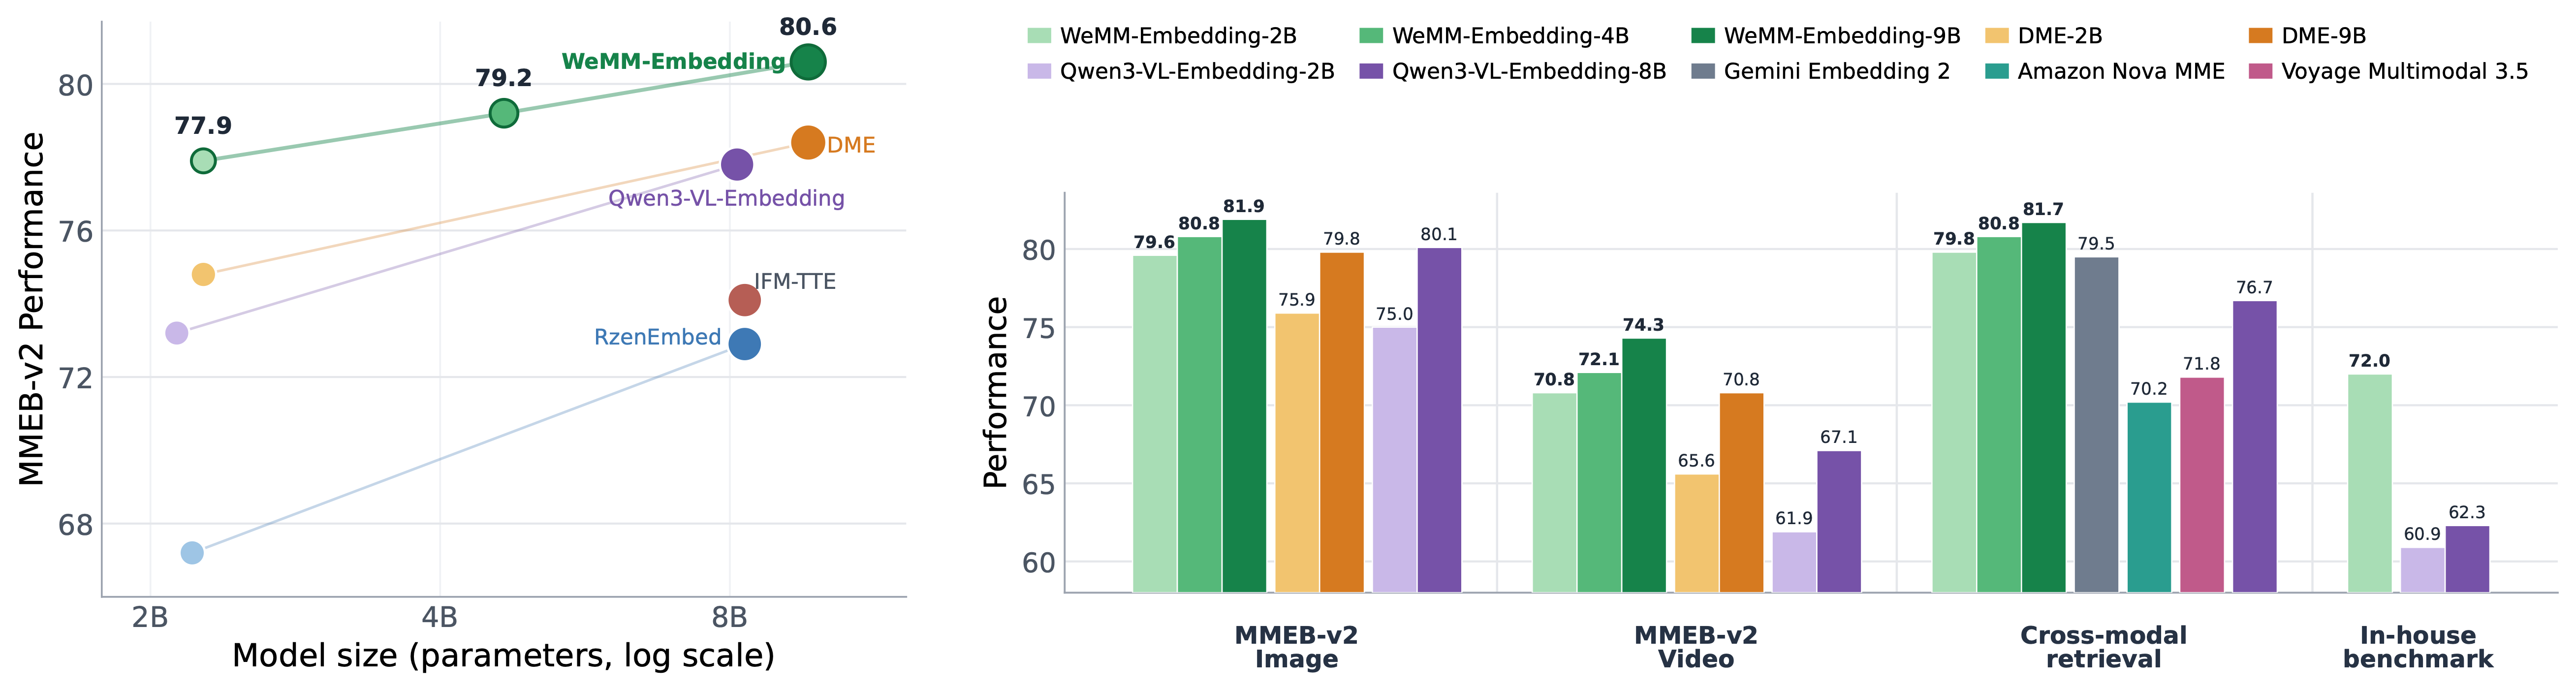
README میں 78 MMEB-v2 ڈیٹاسیٹس اور تمام 190 MMEB-v3 ٹاسکس کے نتائج رپورٹ کیے گئے ہیں۔ MMEB-v2 پر 2B، 4B، اور 9B ویریئنٹس کے اوسط اسکور بالترتیب 77.9، 79.2، اور 80.6 ہیں۔ MMEB-v3 پر ان کے رپورٹ کردہ مجموعی اسکور 56.0، 58.2، اور 59.5 ہیں۔ میٹرکس ٹاسک گروپ کے لحاظ سے مختلف ہوتے ہیں: تصویری اور ویڈیو ٹاسکس Hit@1 استعمال کرتے ہیں، بصری دستاویز اور متنی ٹاسکس NDCG@5 استعمال کرتے ہیں، جبکہ ایجنٹ، MCMR، اور آڈیو ٹاسکس Hit@1 استعمال کرتے ہیں۔
بینچ مارک اسکورز کی تشریح کرتے وقت دستاویزی ٹاسک کوریج کو مدنظر رکھنا چاہیے۔ MMEB-v3 غیر معاون ٹاسکس، بشمول WeMM-Embedding کے لیے آڈیو، کو صفر اسکور دیتا ہے۔
نتیجہ
WeMM-Embedding کئی بصری اور متنی ان پٹ اقسام سے نارملائزڈ نمائندگیوں کی تیاری کے لیے ایک ہی ماڈل فیملی فراہم کرتا ہے۔ 2B چیک پوائنٹ اور فراہم کردہ انفرنس مثال سے آغاز کریں، کمپیکٹ ویکٹرز مفید ہونے کی صورت میں معاون Matryoshka بُعد منتخب کریں، اور سرونگ یا جانچ کی ضرورت ہو تو vLLM، SGLang، یا MMEB-v3 پائپ لائن پر منتقل ہوں۔ بصورت دیگر درج نہ ہونے کی صورت میں Tencent کی تیار کردہ ریپوزٹری کا کوڈ Apache License 2.0 کے تحت جاری کیا گیا ہے۔