

AIBuildAI LLM-Post-Train Agent کیا ہے؟
AIBuildAI LLM-Post-Train Agent ایک تکراری، خود کو بہتر بنانے والا ایجنٹ ہے جو بڑے لسانی ماڈلز کی خودکار اور حسبِ ضرورت پوسٹ ٹریننگ کے لیے بنایا گیا ہے۔ یہ ایک مقررہ تربیتی طریقہ لاگو کرنے کے بجائے کسی کام کا جائزہ لیتا ہے، ممکنہ پوسٹ ٹریننگ الگورتھمز تیار کرتا ہے، تربیتی ڈیٹا جمع اور مرتب کرتا ہے، کوڈ لکھتا ہے، تجربات چلاتا ہے، نتائج کا جائزہ لیتا ہے اور ماڈل کو مسلسل بہتر بناتا ہے۔
اس ذخیرے میں ایجنٹ کو چلانے، پڑھنے اور اس میں ترمیم کرنے کے لیے سورس کوڈ موجود ہے۔ یہ ان اداروں اور محققین کے لیے تیار کیا گیا ہے جنہیں ملکیتی ڈیٹا، ماڈل فیملیز، جائزہ لینے کے طریقۂ کار اور تعیناتی کے اہداف کے مطابق پوسٹ ٹریننگ حکمتِ عملیاں درکار ہوتی ہیں۔
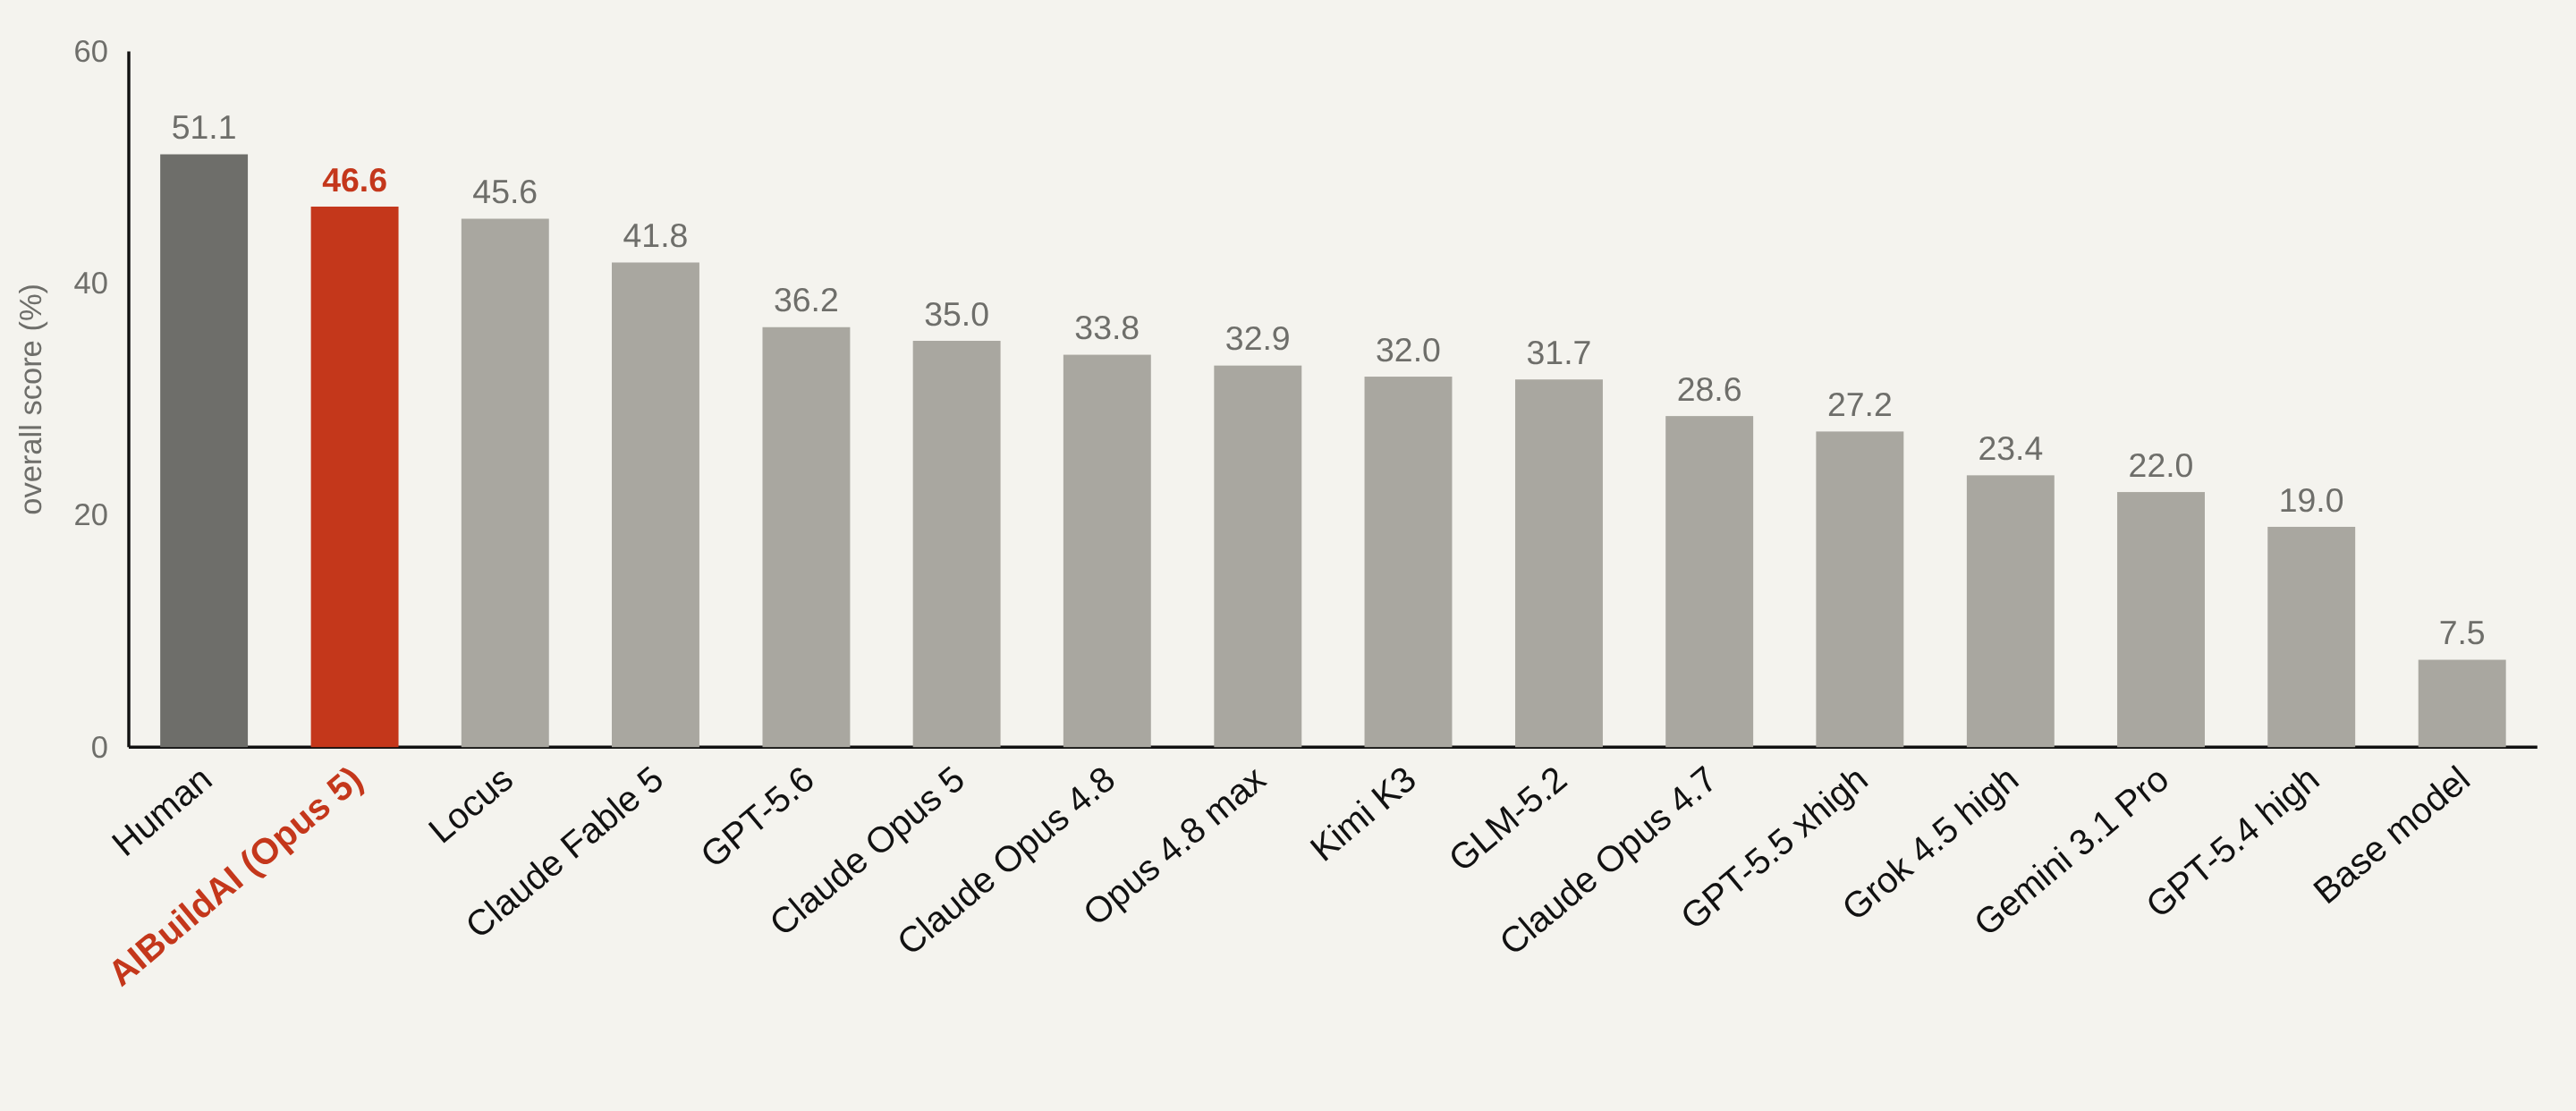
PostTrainBench پر یہ منصوبہ 46.6% کا مجموعی اسکور رپورٹ کرتا ہے، جو جانچے گئے ماڈلز اور ایجنٹس میں پہلے نمبر پر ہے اور صرف انسانی ماہر کے 51.1% کے بنیادی اسکور سے کم ہے۔
ایجنٹ کیسے کام کرتا ہے
عمل کسی کام اور اس کے اسکورنگ طریقۂ کار سے شروع ہوتا ہے۔ نظام کام کی ایک منجمد تفصیل تیار کرتا ہے، بنیادی کارکردگی مقرر کرتا ہے، تجربات شروع کرتا ہے، ہر مکمل امیدوار کو اسی اسکور پروگرام کے ذریعے جانچتا ہے اور بہترین نتیجے کو قابلِ استعمال نتیجے میں تبدیل کرتا ہے۔
دو صلاحیتیں اس نظام کو ایک عمومی کوڈنگ ایجنٹ سے ممتاز کرتی ہیں:
- علمی نظام: ایجنٹس MCP کے ذریعے AIBuildAI Knowledge Base سے سوالات کر سکتے ہیں۔ اس کی مرتب کردہ مہارتی دستاویزات پوسٹ ٹریننگ ورک فلو، طریقوں، ڈیٹاسیٹس اور فریم ورکس کا احاطہ کرتی ہیں۔
- میٹا سرچ: ایک میٹا ایجنٹ کام کا جائزہ لے سکتا ہے اور پہلے سے مقرر تجرباتی ساخت چلانے کے بجائے کام کے لیے مخصوص سرچ پروگرام لکھ سکتا ہے۔
ہر عمل کو ایک براہِ راست ویب ورک اسپیس، مستقل ایگزیکیوشن گراف، جرنل شدہ ورک یونٹس، سینڈ باکس کیے گئے ذیلی عمل اور وسائل کے کنٹرولز بھی حاصل ہوتے ہیں۔ عمل کے واقعات ایک نجی PostgreSQL کلسٹر میں ~/.aibuildai/postgresql کے تحت محفوظ کیے جاتے ہیں، جس سے عمل کو دوبارہ شروع اور دوبارہ چلانا ممکن ہوتا ہے۔
اہم خصوصیات
- LLM پوسٹ ٹریننگ تجربات کا خودکار ڈیزائن اور نفاذ۔
- کام کے مطابق سرچ حکمتِ عملیاں، جن میں میٹا سرچ اور کئی مقررہ سرچ طریقے شامل ہیں۔
- طریقوں، ڈیٹاسیٹس، فریم ورکس اور ورک فلو کے فیصلوں کے لیے علمی بازیافت۔
- ٹائپ شدہ ایجنٹس، تعیّن شدہ پروگرامز اور نیسٹڈ سرچز۔
- کام کے ذریعے متعین گریڈنگ اور امیدواروں کی یکساں درجہ بندی۔
- مقامی ورک اسپیس سروس کے ذریعے براہِ راست براؤزر پر نگرانی۔
- میموری اور عمل کے لیے Bubblewrap سینڈ باکسز اور cgroup-v2 حدود۔
- پچھلے اعمال سے حاصل کردہ مقامی طور پر تیار کردہ میموری۔
- مجموعی نتائج کے بعد اختیاری مقالہ نویسی اور PDF کمپائلیشن۔
- Claude اور Anthropic-compatible endpoints کے ذریعے دستیاب دیگر ماڈلز کی معاونت۔
نظام کے تقاضے
منصوبہ انسٹال کرنے سے پہلے تصدیق کریں کہ میزبان نظام یہ تقاضے پورے کرتا ہے:
- systemd صارف سیشن کے ساتھ x86_64 پر Linux۔
- Python 3.11 سے 3.13۔
- C ٹول چین، جس میں
gccاورmakeشامل ہوں۔ - zlib اور readline کے ترقیاتی ہیڈرز۔
bwrap، جوbubblewrapپیکیج فراہم کرتا ہے، اور غیر مراعات یافتہ صارف نیم اسپیسز فعال ہوں۔- GitHub releases اور
ftp.postgresql.orgتک نیٹ ورک رسائی۔ - Claude Code لاگ اِن، Anthropic API key، یا Anthropic-compatible endpoint کے ذریعے دستیاب کوئی اور ماڈل۔
- CUDA GPU تجویز کیا جاتا ہے، تاہم ایجنٹس دستیاب ہارڈویئر کا پتا لگا کر اسے استعمال کرتے ہیں۔
پہلا عمل سرکاری سورس ٹار بال سے ایک نجی PostgreSQL انسٹالیشن بناتا ہے۔ یہ ruff، tectonic، micromamba، caddy اور PostgreSQL جیسے ٹولز کی مخصوص ورژنز والی نقول بھی ~/.cache/aibuildai میں ڈاؤن لوڈ کرتا ہے۔ نظام میزبان کی مساوی انسٹالیشنز کے بجائے اپنی زیرِ ملکیت نقول استعمال کرتا ہے۔
آپ کو conda کی ضرورت نہیں۔ ایجنٹ اپنی micromamba انسٹالیشن کے ذریعے Program ماحول بناتا ہے۔
cgroup-v2 delegation چیک کریں
ہر عمل ایک cgroup-v2 درخت کے ذریعے محدود ہوتا ہے۔ systemd صارف مینیجر کو کم از کم memory اور pids کنٹرولرز delegate کرنے چاہییں۔ موجودہ ترتیب اس طرح چیک کریں:
U=$(id -u)
cat /sys/fs/cgroup/user.slice/user-$U.slice/user@$U.service/cgroup.subtree_control
آؤٹ پٹ میں memory اور pids شامل ہونے چاہییں۔ اگر ان میں سے کوئی موجود نہ ہو تو منتظم کو /etc/systemd/system/user@$U.service.d/ کے اندر موجود drop-in میں Delegate=pids memory cpu شامل کرنا ہوگا، systemd کو دوبارہ لوڈ کرنا ہوگا اور آپ کو دوبارہ لاگ اِن کرنا ہوگا۔
ایجنٹ انسٹال کریں
1. آپریٹنگ سسٹم کے پیکیجز انسٹال کریں
Debian یا Ubuntu پر compiler، مطلوبہ ہیڈرز اور bubblewrap انسٹال کریں:
sudo apt-get install build-essential zlib1g-dev libreadline-dev bubblewrap2. ذخیرہ کلون کریں
git clone https://github.com/aibuildai-inc/aibuildai-llm-posttrain-agent.git
cd aibuildai-llm-posttrain-agent
3. Python ورچوئل ماحول بنائیں
python -m venv .venv
source .venv/bin/activate
4. مخصوص ورژنز والی dependencies انسٹال کریں
pip install -r requirements.lock
pip install -e . --no-deps
editable installation سے aibuildai کمانڈ دستیاب ہوتی ہے۔ lock file استعمال کریں کیونکہ claude-agent-sdk کا مخصوص ورژن اسی codebase کے لیے تصدیق شدہ ہے۔
اگر آپ ذخیرے میں ترمیم کرنے اور اس کا quality gate چلانے کا ارادہ رکھتے ہیں تو development dependencies بھی انسٹال کریں:
pip install -r requirements-dev.lock5. اختیاری طور پر زیرِ ملکیت ٹولز تیار کریں
ٹولز کو پہلی بار چلانے کے دوران ڈاؤن لوڈ اور بلڈ کیا جا سکتا ہے۔ انہیں پہلے سے تیار کرنے کے لیے یہ کمانڈ چلائیں:
aibuildai setupماڈل تک رسائی کی ترتیب
آپشن 1: Claude Code لاگ اِن استعمال کریں
claude auth loginآپشن 2: API key فراہم کریں
export AIBUILDAI_API_KEY=sk-ant-...اگر AIBUILDAI_API_KEY سیٹ نہ ہو تو ایپلیکیشن پہلے ANTHROPIC_AUTH_TOKEN اور پھر ANTHROPIC_API_KEY کو چیک کرتی ہے۔
Anthropic-compatible دوسرا endpoint استعمال کریں
AIBUILDAI_BASE_URL کو endpoint پر سیٹ کریں اور اس کی key کو AIBUILDAI_API_KEY میں رکھیں:
export AIBUILDAI_BASE_URL=https://openrouter.ai/api
export AIBUILDAI_API_KEY=your-key
export AIBUILDAI_SMALL_FAST_MODEL=provider/model-id
deepseek- سے شروع ہونے والے سادہ model identifiers خودکار طور پر DeepSeek کے Anthropic-compatible endpoint کو ہدف بناتے ہیں۔ OpenRouter کے model identifiers میں provider prefix شامل ہوتا ہے اور ان کے لیے AIBUILDAI_BASE_URL اور AIBUILDAI_SMALL_FAST_MODEL دونوں درکار ہیں۔
اگر کوئی endpoint Claude کے model tiers کے لیے مختلف نام استعمال کرتا ہو تو انہیں AIBUILDAI_HAIKU_MODEL، AIBUILDAI_SONNET_MODEL اور AIBUILDAI_OPUS_MODEL کے ذریعے map کریں۔ جب sub-agents کو ان کے کردار کے لیے ترتیب دیے گئے model سے مختلف model پر چلانا ہو تو AIBUILDAI_SUBAGENT_MODEL استعمال کریں۔
اختیاری سروس کی ترتیبات
AIBUILDAI_KB_BASE_URLknowledge-base MCP service منتخب کرتا ہے۔ بطور ڈیفالٹ، client پروجیکٹ کے عوامی fixed snapshot کو استعمال کرتا ہے۔AIBUILDAI_KB_TOKENbearer token فراہم کرتا ہے، اگر knowledge service کو authentication درکار ہو۔AIBUILDAI_WEB_PORTمقامی workspace service کا port منتخب کرتا ہے۔AIBUILDAI_WEB_NAMEاسی host پر دوسری workspace service کا نام متعین کرتا ہے اور واضح web port درکار ہوتا ہے۔
بنیادی run بنائیں اور شروع کریں
ہر run ایک YAML فائل کے ذریعے بیان کیا جاتا ہے۔ دستاویزی ابتدائی configuration بنانے کے لیے یہ کمانڈ چلائیں:
aibuildai config > task.yamlتیار کردہ فائل میں ہر configuration field، اس کی default value اور اس کی documentation شامل ہوتی ہے۔ مطلوبہ top-level sections run، llm، work_units، search اور resources ہیں؛ starter انہیں پُر کرتا ہے۔
run شروع کرنے کے لیے یہ کمانڈ چلائیں:
aibuildai run task.yamlیہ کمانڈ http://127.0.0.1:<port>/run/<run-id> جیسا workspace URL دکھاتی ہے۔ run کو براہِ راست دیکھنے کے لیے اسے کھولیں۔ browser اختیاری ہے، اور اس کے بغیر بھی execution معمول کے مطابق جاری رہتی ہے۔
GSM8K مثال چلائیں
شامل کردہ مثال GSM8K کے جماعتی سطح کے ریاضی کے لفظی مسائل حل کرنے کے لیے Qwen/Qwen3-1.7B-Base کو post-train کرتی ہے۔ repository کے مطابق، یہ مثال ایک GPU پر تقریباً دو گھنٹے لیتی ہے۔
1. task folder بنائیں
bash examples/gsm8k-qwen3-1.7b-base/setup.sh ~/gsm8k-examplesetup تقریباً 4 GB ڈاؤن لوڈ کرتا ہے، جس میں base model weights اور GSM8K کے دونوں splits شامل ہیں۔ یہ task statement اور frozen grader کو ~/gsm8k-example/task/ میں لکھتا ہے اور run کے اپنے Program environment میں نصب ہونے والے packages کے لیے pip cache کو پہلے سے تیار کرتا ہے۔
نتیجے میں بننے والے task folder میں وہ base weights شامل ہوتے ہیں جنہیں agent tune کر سکتا ہے، 7,473 training problems، grader، اور 1,319 مسائل پر مشتمل test split جسے grader پڑھتا ہے۔
2. post-training شروع کریں
aibuildai run ~/gsm8k-example/task.yamlیہ مثال meta search، 90 منٹ کی exploration wall clock، اور ہر agent کے لیے متعلقہ budgets استعمال کرتی ہے۔ README ایک سنجیدہ run کے لیے ان budgets کو بڑھانے کی سفارش کرتا ہے۔
3. grading contract سمجھیں
grader کامیابی کی مکمل تعریف ہے۔ یہ model کو ایک سوال اور اس کے بعد answer prefix دیتا ہے، greedy decoding کرتا ہے، اور آخری #### کے بعد موجود عدد اخذ کرتا ہے۔ README کے مطابق، پہلے 200 test problems پر base model کا score 0.105 ہے، کیونکہ untuned base model ابتدا میں مطلوبہ answer format کی پابندی نہیں کرتا۔
4. final model کا جائزہ لیں
deliverable ایک merged model directory ہے۔ <run-home> کو تیار کردہ run directory کے نام سے بدلیں اور run کے Program environment کا استعمال کرتے ہوئے تمام test examples کا جائزہ لیں:
H=~/gsm8k-example/playground/gsm8k-qwen3-1.7b-base/<run-home>
$H/program-environment/env/bin/python ~/gsm8k-example/task/grade/evaluate.py --model-path $H/deliverable/final_model --limit -1
اپنے task کے ساتھ agent استعمال کریں
examples/gsm8k-qwen3-1.7b-base.yamlکو copy کریں، یاaibuildai configکے ذریعے مکمل starter بنائیں۔- ایک task folder بنائیں جس میں ہر وہ چیز شامل ہو جسے run استعمال کر سکتا ہے۔
- ہر مطلوبہ data file کے ساتھ پڑھنے کے قابل task description، مثلاً README، task statement یا paper شامل کریں۔
run.data_rootکو اس folder پر سیٹ کریں۔- model، search، budget، work-unit اور resource settings کا جائزہ لیں۔
- YAML فائل کو
aibuildai runکے ذریعے شروع کریں۔
setup کے دوران system پورے task folder کو پڑھتا ہے، statement کو run کے README کے طور پر freeze کرتا ہے، اور اسی سے run کا score program بناتا ہے۔ اس لیے task folder مکمل ہونا چاہیے اور اس میں مطلوبہ deliverable اور evaluation method واضح طور پر بیان ہونے چاہییں۔
configuration میں run.setup_from_scratch اور run.task_prompt بھی معاونت یافتہ ہیں۔ یہ settings Setup کو پہلے سے تیار task folder سے شروع کرنے کے بجائے task statement سے data اور evaluation حاصل کرنے کی اجازت دیتی ہیں۔
اہم configuration انتخاب
ماڈل کا انتخاب
llm.default.model ایجنٹس کے زیرِ استعمال بنیادی ماڈل منتخب کرتا ہے۔ استدلال کو effort اور max_thinking_tokens جیسی ترتیبات سے ایڈجسٹ کیا جا سکتا ہے۔ ماڈلز کو انفرادی کرداروں کے ساتھ منسلک کرنے کے لیے llm.by_role استعمال کریں، یا کردار کے مطابق روٹر کو ماڈل منتخب کرنے دینے کے لیے llm.auto استعمال کریں۔
تلاش کا طریقہ
search.kind تجربے کی حکمتِ عملی کو کنٹرول کرتا ہے۔ README میں بیان کردہ معاون اقدار یہ ہیں:
meta، جس میں ایک میٹا ایجنٹ کام کے لیے مخصوص تلاش پروگرام لکھتا ہے۔nb_tree، جو پورے تجربے پر درختی تلاش کرتا ہے۔nb۔tree، جو عمومی اسٹارٹر میں طے شدہ قدر ہے۔linear۔parallel۔
search.input کا مواد منتخب کردہ حکمتِ عملی پر منحصر ہوتا ہے۔ میٹا تلاش report آپشن قبول کرتی ہے، جبکہ متعین حکمتِ عملیاں اپنے پیرامیٹرز استعمال کرتی ہیں اور ان میں parallel اور early_stopping شامل ہو سکتے ہیں۔
وقت اور اخراجات کی حدود
run.budget.wall_clock_minutes کی طے شدہ قدر 1,440 منٹ ہے۔ حد پوری ہونے پر نئی تلاش شروع نہیں ہوتی، لیکن جاری کام اور ڈیلیوری کو مکمل ہونے دیا جاتا ہے۔ run.budget.cost_usd اختیاری طور پر پورے رن کے اخراجات کی نرم حد فراہم کرتا ہے۔
work_units کے تحت ہر اندراج کا اپنا بجٹ ہوتا ہے۔ ورک یونٹ مقررہ منٹ، گہرائی کے مطابق اسکیل کیا گیا وقت، یا اضافی گنجائش کے ساتھ متوقع دورانیہ استعمال کر سکتا ہے۔
وسائل کی حدود
ہر ورک یونٹ پر سخت CPU اور میموری حدود عائد کرنے کے لیے resources.work_unit.cpu_max_cores اور resources.work_unit.memory_max_gb استعمال کریں۔ ہر یونٹ cgroup کے ذریعے میموری اور پراسیسز کی حدود والے bubblewrap سینڈ باکس میں چلتا ہے، جبکہ ٹاسک فولڈر صرف پڑھنے کے لیے ماؤنٹ ہوتا ہے۔
اعلیٰ درجے کی تجاویز
علم کی بازیافت فعال کریں
جب آپ چاہتے ہیں کہ ایجنٹس AIBuildAI نالج بیس سے مشورہ کریں تو kb MCP کنفیگریشن شامل کریں۔ کلائنٹ مہارتیں تلاش کرنے، کسی مہارت کو لوڈ کرنے، اور حوالہ جات پڑھنے کے لیے ٹولز فراہم کرتا ہے۔ اس ذخیرے میں ورک فلو رہنمائی، طریقۂ کار کارڈز، ڈیٹاسیٹ کارڈز، اور فریم ورک کارڈز شامل ہیں۔
طے شدہ عوامی سروس ایک مقررہ ذخیرے کا اسنیپ شاٹ ہے۔ اپنا ورژن ہوسٹ کرنے کے لیے اوپن سورس نالج بیس ریپوزٹری تعینات کریں اور AIBUILDAI_KB_BASE_URL کو اس کی طرف اشارہ کریں۔
کام کے لیے مخصوص ٹوپولوجی کے لیے میٹا تلاش منتخب کریں
مقررہ درختی تلاش ہر ورک فلو کو فطری طور پر ظاہر نہیں کر سکتی، مثلاً تربیت سے پہلے sweep چلانا، اس کے بعد tournament منعقد کرنا، یا متعدد ماڈلز کو یکجا کرنا۔ search.kind: meta کے ساتھ ایک میٹا ایجنٹ کام کا جائزہ لیتا ہے، پائلٹ چلا سکتا ہے، شامل کردہ ڈیزائن مہارتوں اور نالج بیس سے مشورہ کرتا ہے، اور Python تلاش پیکیج لکھتا ہے۔
تیار کردہ پیکیج تین بنیادی اجزا سے بنتا ہے:
- ایجنٹ: ٹولز، پالیسیوں، اور ٹائپ شدہ آؤٹ پٹ والا LLM سیشن۔
- پروگرام: مخصوص وسائل کی حدود والے زیرِ انتظام ورکر میں ہونے والی متعین کمپیوٹیشن۔
- تلاش: ایسا آرکیسٹریٹر جو ٹائپ شدہ ان پٹس اور آؤٹ پٹس کے ذریعے ایجنٹس، پروگرامز، اور نیسٹڈ تلاشوں کو شروع اور مربوط کر سکتا ہے۔
پیکیج کی توثیق کی جاتی ہے اور اختیاری طور پر LaTeX ڈیزائن رپورٹ کے ذریعے اس کا جائزہ لیا جا سکتا ہے۔ اس کے بعد یہ اسی جرنل شدہ رن میں بطور چائلڈ تلاش چلتا ہے۔ ٹوپولوجی سے قطع نظر، رن کی قدر کسی بھی نوڈ کے حاصل کردہ بہترین اسکور کے برابر رہتی ہے۔
دوبارہ قابلِ استعمال مقامی میموری بنائیں
کسی کام کے لیے متعدد رنز جمع کرنے کے بعد ان کے اسباق کو قابلِ ترمیم مقامی میموری دستاویز میں یکجا کریں:
aibuildai memorize task.yamlہر ایجنٹ میں اس مقامی میموری کو شامل کرنے کے لیے memory.enable کو فعال کریں۔ آپ کے رنز سے سیکھی گئی معلومات آپ کی مشین پر رہتی ہیں اور ریموٹ نالج بیس میں شامل نہیں کی جاتیں۔
بیرونی ٹولز کو کنٹرول کریں
منتخب بلٹ اِن ٹولز کے استعمال سے ہر کردار کو روکنے کے لیے disallowed_tools استعمال کریں۔ مثال کے طور پر، جب جائزے کے قواعد آف لائن ورک فلو کا تقاضا کریں تو کوئی کام WebSearch اور WebFetch کو ممنوع قرار دے سکتا ہے۔
MCP انضمامات شامل کریں
mcps کنفیگریشن نالج بیس، Kaggle مقابلے میں جمع کرانے، یا حسبِ ضرورت MCP سرورز کو فعال کر سکتی ہے۔ Kaggle انضمام submission.max_submissions کے تحت زیادہ سے زیادہ جمع کرانے کی ترتیب کو سپورٹ کرتا ہے۔
مقالہ تیار کریں
تجمیع کے بعد مقالے کا مسودہ تیار کرنے کے لیے writer.enable فعال کریں، یا مکمل شدہ رن ڈائریکٹری پر مقالے کی کمانڈ چلائیں:
aibuildai write-paper <run-dir>یہ کمانڈ مکمل شدہ رن سے مقالے کا مسودہ تیار کرتی ہے اور اسے PDF میں کمپائل کرتی ہے۔
ماخذ میں تبدیلیوں کی توثیق کریں
اس پروجیکٹ لائن میں ٹیسٹ سوٹ شامل نہیں ہے۔ اس کی ریپوزٹری گیٹ یہ ہے:
./check.shیہ گیٹ pyright، ruff، semgrep، اور لاک فائل میں تبدیلی کی جانچ چلاتی ہے۔ اسے استعمال کرنے سے پہلے requirements-dev.lock انسٹال کریں۔
رن کے آؤٹ پٹس کو سمجھیں
ہر رن، ترتیب دیے گئے پلے گراؤنڈ روٹ کے تحت ایک ہوم ڈائریکٹری بناتا ہے:
{playground_root}/<task-name>/<timestamp>_<run-id>/
  run_config.json
  public/
  private/
  deliverable/
  workspace/
  program-environment/
resource_samples.jsonlrun_config.jsonمیں دوبارہ آغاز کے لیے استعمال ہونے والی حتمی کنفیگریشن اور رن ID شامل ہوتی ہے۔public/میں امیدواروں کے لیے Setup کے ذریعے تیار کردہ منجمد README اور ڈیٹا شامل ہوتا ہے۔private/میں اسکور پروگرام، میٹرک مینی فیسٹ، بنیادی کوشش، اور فاتح کا ریکارڈ شامل ہوتا ہے۔deliverable/میں چلانے کے قابل ماڈل پیکیج یا کام کے ذریعے متعین کوئی اور نتیجہ شامل ہوتا ہے۔workspace/میں کوششیں، آرٹیفیکٹس، عارضی ڈیٹا، اور ہر تلاش کی ورکنگ ڈائریکٹریز شامل ہوتی ہیں۔program-environment/میں رن کا الگ تھلگ Program ماحول شامل ہوتا ہے۔resource_samples.jsonlعمل درآمد کے دوران جمع کی گئی میزبان وسائل کی پیمائشیں ریکارڈ کرتی ہے۔
نتیجہ
AIBuildAI LLM-Post-Train Agent ماڈل کی پوسٹ ٹریننگ کے ورک فلو ڈیزائن، اجرا، درجہ بندی اور بہتری کے لیے ایک مکمل نظام فراہم کرتا ہے۔ انسٹالیشن کی تصدیق اور رَن کے ڈھانچے کو سمجھنے کے لیے فراہم کردہ GSM8K مثال سے آغاز کریں۔ پھر ایک واضح ٹاسک فولڈر اور گریڈر متعین کریں، مناسب سرچ حکمتِ عملی منتخب کریں، حقیقت پسندانہ بجٹ اور وسائل کی حدود مقرر کریں، اور حاصل ہونے والے تجربات کی نگرانی کے لیے لائیو ورک اسپیس استعمال کریں۔
مزید گہری معماری کی تفصیلات کے لیے ریپوزٹری کی معماری کی دستاویزات ملاحظہ کریں۔ یہ منصوبہ Apache License 2.0 کے تحت تقسیم کیا جاتا ہے۔