
LLaMA Factory (جسے اب LlamaFactory کا نام دیا گیا ہے) بڑے زبان ماڈلز کے لیے ایک متحدہ فائن ٹیوننگ فریم ورک ہے۔ یہ منصوبہ بیہانگ یونیورسٹی کے ڈاکٹر ژینگ یاووی کی ٹیم نے شروع کیا، اور اسے ACL 2024 کے مقالے سے علمی بنیاد حاصل ہے۔ فریم ورک "نو-کوڈ CLI + Web UI" ڈیزائن استعمال کرتا ہے، جس کا مقصد فائن ٹیوننگ کے عمل کو آسان بنانا ہے۔ LlamaFactory نے GitHub پر مجموعی طور پر 72,000 سے زیادہ Stars حاصل کیے ہیں اور یہ بڑے ماڈلز کی فائن ٹیوننگ کے شعبے میں ایک حوالہ جاتی نفاذ بن چکا ہے۔
>
1۔ منصوبے کا جائزہ
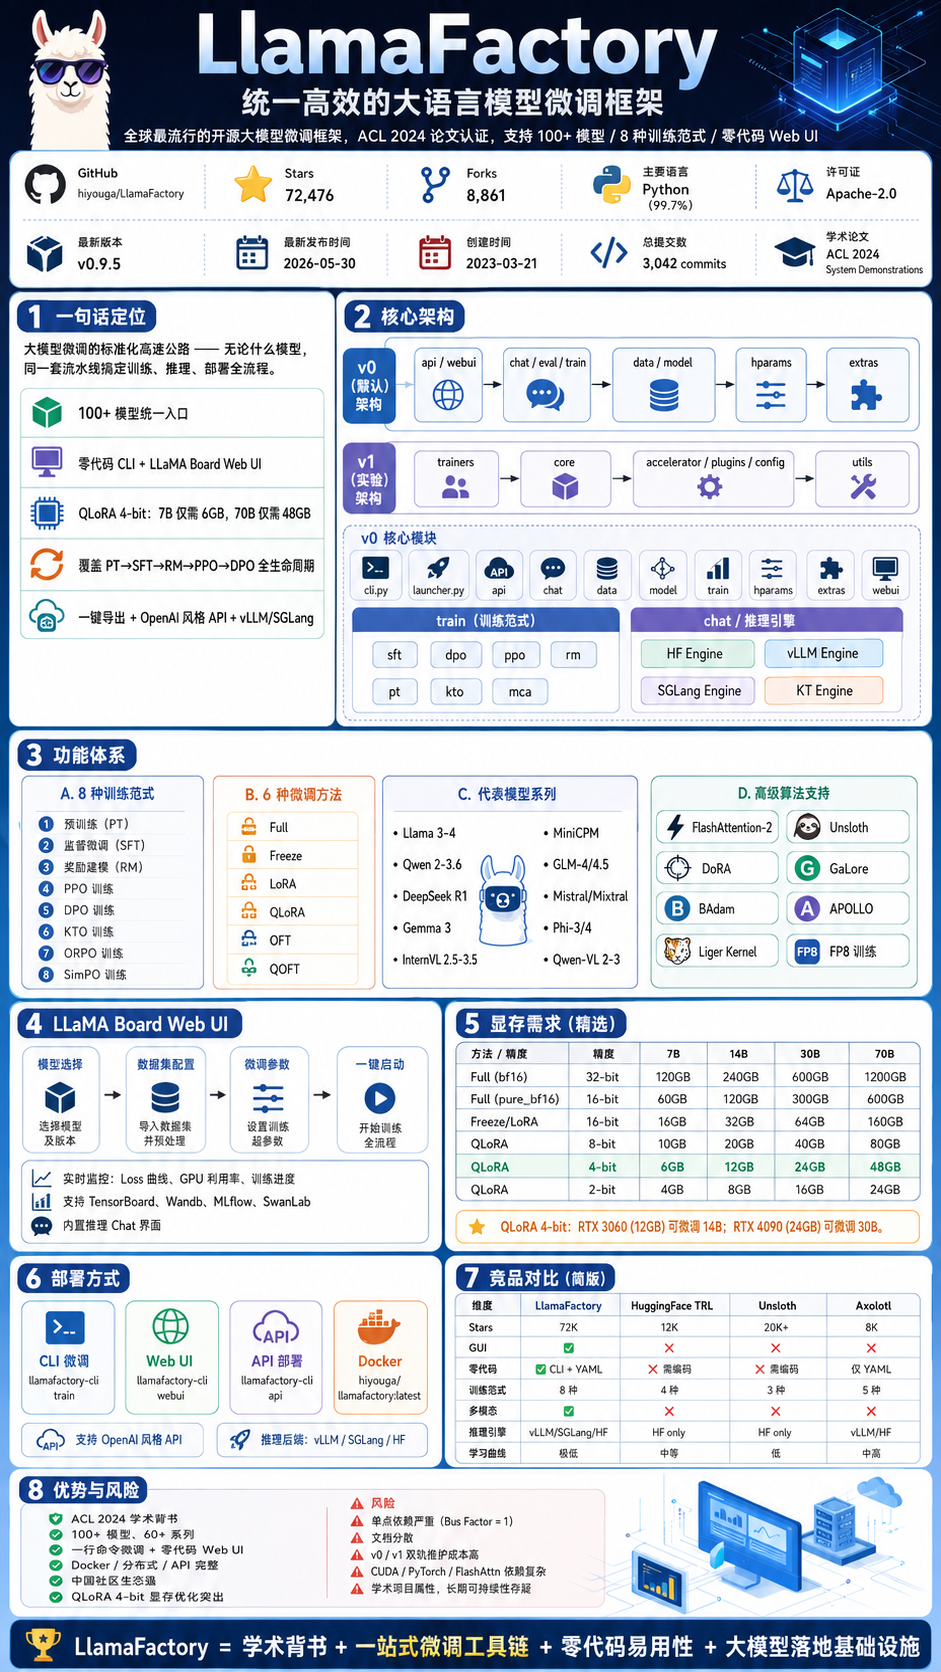
پہلو|تفصیل
منصوبے کا مکمل نام|LlamaFactory (سابقہ نام LLaMA-Factory)
GitHub پتہ|github.com/hiyouga/LlamaFactory
Stars|72,476 ⭐
Forks|8,861
بنیادی زبان|Python (99.7%)
لائسنس|Apache-2.0
تخلیق کی تاریخ|2023-03-21
تازہ ترین ورژن|v0.9.5 (2026-05-30)
کل commits|3,042 commits
مرکزی معاون|hiyouga (ژینگ یاووی، 2,188 commits، کل commits کا 72%)
علمی مقالہ|ACL 2024 System Demonstrations
ریپوزٹری کا حجم|~412.9 MB
کھلے مسائل|57
بانی ژینگ یاووی (hiyouga) بیہانگ یونیورسٹی کے ڈاکٹریٹ طالب علم ہیں۔ انہوں نے پہلے مصنف کی حیثیت سے ACL، CVPR، WWW جیسی بین الاقوامی اعلیٰ کانفرنسوں میں متعدد مقالے شائع کیے ہیں، اور AAAI، EMNLP جیسی کانفرنسوں کے جائزہ کار بھی رہے ہیں۔ ان کے اعزازات میں Huawei Cup، Blue Bridge Cup کا قومی اول انعام، بیہانگ یونیورسٹی کی سالانہ شخصیت اور Ascend اوپن سورس ایکوسسٹم کا نمایاں تعاون ایوارڈ شامل ہیں۔ تعاون کرنے والی ٹیم میں بیہانگ یونیورسٹی کے پروفیسر ژانگ رِی چونگ، ژانگ جون ہاؤ، یہ یان ہان، لو ژے یان، فینگ ژانگ چی اور ما یونگ چیانگ بھی شامل ہیں۔
2۔ منصوبے کی پوزیشننگ اور بنیادی قدر
2.1 ایک جملے میں پوزیشننگ
بڑے ماڈلز کی فائن ٹیوننگ کی معیاری پائپ لائن: کسی بھی ماڈل کے لیے متحدہ عمل، جس میں ڈیٹا کی تیاری، ماڈل کی تربیت،推理 کی توثیق اور تعیناتی سمیت مکمل سلسلے کے مراحل شامل ہیں۔
2.2 حل کیے جانے والے بنیادی مسائل
مسئلہ|LLaMA Factory کا حل
مختلف ماڈلز کے فائن ٹیوننگ کے عمل مختلف ہوتے ہیں، اس لیے منتقلی کی لاگت زیادہ ہے|الگورتھم-ماڈل-ڈیٹا کی "decoupling" ڈیزائن، 100+ ماڈلز کے لیے متحدہ داخلی راستہ
فائن ٹیوننگ کوڈ کی حدِ رسائی بلند ہے اور گہری مشین لرننگ کی مہارت درکار ہے|نو-کوڈ CLI + LLaMA Board Web UI (Gradio)
ویڈیو میموری ناکافی ہے، صارفین کی سطح کے GPU بڑے ماڈلز کو تربیت نہیں دے سکتے|QLoRA 4-bit: 7B کے لیے صرف 6GB، 70B کے لیے صرف 48GB درکار
اوپن سورس کمیونٹی میں یکجا ٹول چین کی کمی ہے|PT→SFT→RM→PPO→DPO کے پورے لائف سائیکل کا احاطہ
推理 کی تعیناتی پیچیدہ ہے|ایک کلک پر ایکسپورٹ + OpenAI طرز API + vLLM/SGLang
2.3 فلسفۂ ڈیزائن: الگورتھم-ماڈل-ڈیٹا کی "decoupling"
ایک خصوصی انٹرویو میں ژینگ یاووی نے ماڈل کی推理 کے عمل کو معیاری شاہراہ پر چلنے والی گاڑی سے تشبیہ دی۔ ماڈل خود مختلف اقسام کی گاڑیوں کے مانند ہے، جبکہ ڈیٹا گاڑی پر لادے گئے سامان کے برابر ہے۔ جب تک ماڈل اس شاہراہ پر کامیابی سے چل سکتا ہو، فائن ٹیوننگ کا عمل صرف پیرامیٹرز کو ایڈجسٹ کرکے مکمل کیا جا سکتا ہے۔
3۔ تکنیکی ساخت کا گہرا تجزیہ
3.1 دو متوازی آرکیٹیکچر کا ڈیزائن
LLaMA Factory بیک وقت v0 (مستحکم ورژن) اور v1 (تجرباتی ورژن) کے دو آرکیٹیکچر فراہم کرتا ہے، اور ماحولیاتی متغیر USE_V1 ترتیب دے کر دونوں کے درمیان سوئچ کیا جا سکتا ہے۔
v0 (پہلے سے طے شدہ): api/webui → chat/eval/train → data/model → hparams → extras
v1 (تجرباتی): trainers → core → accelerator/plugins/config → utils
v0 آرکیٹیکچر موجودہ مرکزی نفاذ ہے، جو مکمل فعالیت اور جامع دستاویزات فراہم کرتا ہے۔ v1 آرکیٹیکچر اب بھی تجرباتی مرحلے میں ہے اور زیادہ ماڈیولر تہہ دار ڈیزائن استعمال کرتا ہے۔
3.2 v0 کے بنیادی ماڈیولز کی تفصیل
src/llamafactory/
├── cli.py                    # CLI داخلی راستہ، llamafactory-cli کمانڈ کی تقسیم
├── launcher.py               # لانچر، USE_V1 کے مطابق تقسیم
├── api/                      # OpenAI طرز REST API
│   ├── app.py                # FastAPI ایپلیکیشن
│   ├── chat.py               # مکالماتی اینڈ پوائنٹ
│   └── protocol.py           # پروٹوکول کی تعریف
├── chat/                     #推理 انجن کی تہہ
│   ├── base_engine.py        # تجریدی بنیادی کلاس
│   ├── hf_engine.py          # مقامی HuggingFace推理
│   ├── vllm_engine.py        # vLLM اعلیٰ کارکردگی推理
│   └── sglang_engine.py      # SGLang推理
├── data/                     # ڈیٹا پروسیسنگ کی تہہ
│   ├── template.py           # 100+ ماڈلز کے Prompt ٹیمپلیٹس کی رجسٹری
│   ├── mm_plugin.py          # ملٹی موڈل (تصویر/ویڈیو/آڈیو) پروسیسنگ
│   ├── loader.py             # ڈیٹاسیٹ لوڈر
│   ├── processor/            # تربیتی مرحلے کے مطابق پروسیسرز
│   └── converter.py          # فارمیٹ کی تبدیلی (Alpaca/ShareGPT)
├── model/                    # ماڈل کی تہہ
│   ├── loader.py             # ماڈل+ٹوکنائزر لوڈنگ، کوانٹائزیشن، LoRA
│   └── patcher.py            # ماڈل مطابقت کے پیچز
├── train/                    # تربیت کی تہہ
│   ├── sft/                  # زیرِ نگرانی فائن ٹیوننگ
│   ├── dpo/                  # DPO ترجیحی اصلاح
│   ├── ppo/                  # PPO تقویتی سیکھنا
│   ├── rm/                   # انعامی ماڈلنگ
│   ├── pt/                   # پری ٹریننگ
│   ├── kto/                  # KTO تربیت
│   └── mca/                  # Megatron-Core موافقت
├── hparams/                  # پیرامیٹر کنفیگریشن کی تہہ
│   ├── model_args.py         # ماڈل پیرامیٹرز
│   ├── data_args.py          # ڈیٹا پیرامیٹرز
│   ├── finetuning_args.py    # فائن ٹیوننگ پیرامیٹرز
│   └── training_args.py      # تربیتی پیرامیٹرز (HF TrainingArguments سے ماخوذ)
├── extras/                   # ٹولز
│   ├── constants.py          # عالمی مستقلات/اینومز
│   └── packages.py           # انحصارات کی جانچ
└── webui/                    # LLaMA Board Web انٹرفیس
    ├── interface.py          # Gradio انٹرفیس کی تعمیر
    ├── runner.py             # تربیتی کام کا آغاز
    └── components/           # UI اجزا
3.3 تربیتی عمل (v0 Training Flow)
llamafactory-cli train xxx.yaml
  → run_exp() [tuner.py]
    → read_args() → YAML/JSON کنفیگریشن کی تشریح
    → get_train_args() → 4 قسم کے dataclass تیار کریں:
        ModelArguments + DataArguments + FinetuningArguments + TrainingArguments
    → مخصوص تربیتی فنکشن کی طرف روٹنگ:
        run_sft / run_dpo / run_ppo / run_rm / run_pt / run_kto
    → (اختیاری) export_model() → LoRA وزن ضم کرکے ایکسپورٹ
3.4推理 انجن میٹرکس
انجن|خصوصیات|موزوں منظرنامہ
HF Engine|مقامی HuggingFace، بہترین مطابقت|ترقیاتی ڈیبگنگ، محدود پیمانے کی推理
vLLM Engine|270%推理 رفتار میں اضافہ، PagedAttention|اعلیٰ کارکردگی والی آن لائن推理
SGLang Engine|RadixAttention، ساختی تخلیق|بیچ推理، پیچیدہ تخلیق
KT Engine|علم کی منتقلی کے لیے مخصوص|ماڈل ڈسٹلیشن
4۔ فعالیت کا نظام
4.1 معاونتی تربیتی نمونے (8 اقسام × 6 فائن ٹیوننگ طریقے = 48 امتزاج)
تربیتی نمونہ|Full|Freeze|LoRA|QLoRA|OFT|QOFT
پری ٹریننگ (PT)|✅|✅|✅|✅|✅|✅
زیرِ نگرانی فائن ٹیوننگ (SFT)|✅|✅|✅|✅|✅|✅
انعامی ماڈلنگ (RM)|✅|✅|✅|✅|✅|✅
PPO تربیت|✅|✅|✅|✅|✅|✅
DPO تربیت|✅|✅|✅|✅|✅|✅
KTO تربیت|✅|✅|✅|✅|✅|✅
ORPO تربیت|✅|✅|✅|✅|✅|✅
SimPO تربیت|✅|✅|✅|✅|✅|✅
4.2 معاونتی ماڈل سیریز (60+ سیریز، 100+ ویرینٹس)
منتخب نمائندہ ماڈلز:
ماڈل سیریز|پیرامیٹر پیمانہ|خصوصیت
Llama 3-4|1B–402B|Meta کا فلیگ شپ اوپن سورس ماڈل
Qwen 2-3.6|0.5B–397B|علی بابا کی Tongyi Qianwen کی مکمل سیریز
DeepSeek R1|1.5B–671B|استدلالی ماڈل کا ڈسٹل شدہ ورژن
Gemma 3|270M–27B|Google کا ہلکا پھلکا ماڈل
InternVL 2.5-3.5|1B–241B|ملٹی موڈل وژن لینگویج ماڈل
MiniCPM|0.5B–9B|آن ڈیوائس تعیناتی کے لیے بہتر بنایا گیا
GLM-4/4.5|9B–355B|智谱 ChatGLM سیریز
Mistral/Mixtral|7B–8x22B|ماہرین کا مرکب، MoE
Phi-3/4|3.8B–14B|Microsoft کے چھوٹے، اعلیٰ کارکردگی والے ماڈلز
Qwen-VL 2-3|2B–235B|وژن لینگویج ماڈل
4.3 اعلیٰ درجے کے الگورتھم کی معاونت
الگورتھم|فنکشن|شامل کیا گیا ورژن
FlashAttention-2|توجہ کی کمپیوٹنگ میں تیزی|2023-09
Unsloth|170% تربیتی رفتار میں اضافہ + 50% ویڈیو میموری کی بچت|2023-12
DoRA|وزن کی تجزیہ کاری والا LoRA|2024-02
GaLore|گریڈیئنٹ کی کم رُتبہ اصلاح|2024-03
BAdam|بلاک کوآرڈینیٹ ڈیسنٹ اصلاح|2024-04
APOLLO|اعلیٰ درجے کا آپٹیمائزر|2025-Q1
Liger Kernel|Triton کرنل ایکسلریشن|2025
FP8 تربیت|Transformer Engine معاونت|2025
4.4 LLaMA Board Web UI
Gradio پر مبنی زیرو کوڈ بصری انٹرفیس
ماڈل کا انتخاب → ڈیٹاسیٹ کی تشکیل → فائن ٹیوننگ پیرامیٹرز → ایک کلک سے تربیت شروع
ریئل ٹائم نگرانی: Loss منحنی، GPU استعمال، تربیتی پیش رفت
TensorBoard، Wandb، MLflow، SwanLab سمیت متعدد بیک اینڈ لاگز کی معاونت
اندرونی inference Chat انٹرفیس، تربیت کے فوراً بعد آزمائش ممکن
4.5 تعیناتی کے طریقے
# CLI فائن ٹیوننگ (ایک کمانڈ)
llamafactory-cli train examples/train_lora/qwen3_lora_sft.yaml

# Web UI
llamafactory-cli webui

# OpenAI طرز کی API تعیناتی
API_PORT=8000 llamafactory-cli api examples/inference/qwen3.yaml

# Docker
docker run -it --rm --gpus=all hiyouga/llamafactory:latest
پانچ، ہارڈویئر کی ضروریات (ویڈیو میموری کا تخمینہ)
طریقہ|درستگی|7B|14B|30B|70B
Full (bf16)|32-bit|120GB|240GB|600GB|1200GB
Full (pure_bf16)|16-bit|60GB|120GB|300GB|600GB
Freeze/LoRA|16-bit|16GB|32GB|64GB|160GB
QLoRA|8-bit|10GB|20GB|40GB|80GB
QLoRA|4-bit|6GB|12GB|24GB|48GB
QLoRA|2-bit|4GB|8GB|16GB|24GB
QLoRA کی 4‑bit کوانٹائزیشن ایک RTX 3060 (12 GB ویڈیو میموری) پر 14 B پیرامیٹر ماڈل اور ایک RTX 4090 (24 GB ویڈیو میموری) پر 30 B پیرامیٹر ماڈل کو فائن ٹیون کرنا ممکن بناتی ہے۔
چھ، ورژن کا ارتقا
ورژن|تاریخ|اہم تبدیلیاں
v0.1.0|2023-03|ابتدائی ریلیز، LLaMA فائن ٹیوننگ کی معاونت
ابتدائی مراحل|2023|SFT + LoRA/QLoRA، DPO، Web UI، FlashAttention-2، Unsloth
ابتدائی مراحل|2024 Q1-Q3|DoRA، GaLore، BAdam، FSDP+QLoRA، vLLM، ملٹی موڈل LLaVA، مقالے کی اشاعت
v0.9.1|2025 Q1|Llama 3.2 Vision، LLaVA-NeXT، Pixtral، Video-LLaVA
v0.9.2|2025 Q1|MiniCPM-o، SwanLab، APOLLO آپٹیمائزر
v0.9.3|2025 Q2|Llama 4، Gemma 3، Qwen3، InternVL3، Qwen2.5-Omni
v0.9.4|2025-12|🔄 ریپوزٹری کا نام بدل کر LlamaFactory رکھا گیا، Python 3.9-3.10 فرسودہ
v0.9.5|2026-05-30|Qwen3.5/3.6، Gemma 4، Transformers v5 مطابقت
v1.x (تجرباتی)|2026|نیا معماری ڈھانچہ trainers → core → accelerator، ماڈیولر ازسرنو تحریر
اہم سنگِ میل کی تشریح
ACL 2024 مقالے کی اشاعت —— علمی توثیق سے Stars کی تعداد 1 万 سے بڑھ کر 3 万+ ہو گئی
2024 کی دوسری ششماہی —— ملٹی موڈل معاونت (LLaVA/Video/آڈیو) نے نئی مارکیٹ کھولی
2025 —— ماہانہ ریلیز کی رفتار برقرار، Qwen3/DeepSeek/Llama4 کی معاونت، چینی اوپن سورس کمیونٹی کا اولین انتخاب
ریپوزٹری کا نام تبدیل —— LLaMA-Factory → LlamaFactory، Meta برانڈ پر انحصار کم کیا گیا
v1 تجرباتی معماری —— بڑی ازسرنو ساخت کی تیاری کا اشارہ
سات، کمیونٹی کا ماحولیاتی نظام
7.1 پروجیکٹ ایکوسسٹم میٹرکس
پروجیکٹ|تفصیل|Stars
LlamaFactory|بنیادی فائن ٹیوننگ فریم ورک|72K+
EasyR1|VLM ری اِنفورسمنٹ لرننگ (GRPO/DAPO/Reinforce++)|ابھرتا ہوا
FastEdit|مؤثر ماڈل فیکٹ ایڈیٹنگ|آرکائیو شدہ
llamafactory-community|کمیونٹی رابطہ مرکز|-
Easy Dataset|مصنوعی ڈیٹا تیار کرنے کا ٹول|تھرڈ پارٹی
DataFlow|ڈیٹا پروسیسنگ پائپ لائن|تھرڈ پارٹی
7.2 کمیونٹی کی مقبولیت
چینی AI کمیونٹی:CSDN، 知乎، 博客园 پر سیکڑوں ٹیوٹوریلز اور عملی تجربات
کارپوریٹ اپنانا:علی بابا کلاؤڈ، Huawei Ascend، Amazon AWS، NVIDIA کی سرکاری سفارش
تعلیمی منظرنامے:Fudan University اور کئی جامعات میں بڑے ماڈل کے کورسز کے تدریسی ٹول کے طور پر استعمال
چینی مطابقت:ModelScope (魔搭 کمیونٹی) اور OpenMind Hub مرر ڈاؤن لوڈ کی مقامی معاونت
LLaMA Factory Online:آن لائن پلیٹ فارم سروس فراہم کرتا تھا، 2026-06-20 کو بند کر دیا گیا
7.3 مسابقتی موازنہ
فریم ورک|Stars|بنیادی خصوصیت|ماڈل معاونت|استعمال میں آسانی
LlamaFactory|72K|ون اسٹاپ GUI/CLI، ACL مقالے کی توثیق|100+|⭐⭐⭐⭐⭐
HuggingFace TRL|12K|HF کا سرکاری ٹول چین، ایکوسسٹم کے ساتھ گہرا انضمام|تمام HF ماڈلز|⭐⭐⭐
Axolotl|8K|YAML پر مبنی، اعلیٰ سطح کے صارفین کے لیے تخصیص|اہم ماڈلز|⭐⭐⭐
Unsloth|20K+|انتہائی کارکردگی کی اصلاح (2-5x رفتار)|LLaMA/Mistral وغیرہ|⭐⭐⭐⭐
Firefly|5K|چینی بڑے ماڈلز کے لیے اصلاح|بنیادی طور پر چینی ماڈلز|⭐⭐⭐
LLaMA-Adapter|6K|علمی تحقیق پر مرکوز|LLaMA سیریز|⭐⭐
LlamaFactory کے بنیادی فوائد:
واحد ایسا فریم ورک جس کے پاس بیک وقت ACL مقالہ + 7 万 Stars + تجارتی نفاذ کے کیسز + زیرو کوڈ GUI موجود ہیں
ماڈلز کا سب سے وسیع احاطہ (GPT-2 سے Llama 4 تک، خالص متن سے ملٹی موڈل تک)
چینی کمیونٹی کا مضبوط ترین ایکوسسٹم (HuggingFace مرر + ModelScope انضمام)
آٹھ، SWOT تجزیہ
8.1 فوائد (Strengths)
فائدہ|تفصیل
🔬 علمی اتھارٹی|ACL 2024 مقالہ، علمی حوالہ جات 500+ سے زیادہ
🎯 انتہائی کم رکاوٹ|ایک کمانڈ سے فائن ٹیوننگ، Web UI کے ذریعے زیرو کوڈ آپریشن
🌐 وسیع ترین ماڈل کوریج|100+ ماڈلز، 60+ سیریز، متن/وژن/ویڈیو/آڈیو
🇨🇳 چینی کمیونٹی ایکوسسٹم|ModelScope/OpenMind مررز، چینی ٹیوٹوریلز کی بڑی تعداد
🔧 صنعتی درجے کا ٹول چین|Docker/تقسیم شدہ/API تعیناتی کی مکمل معاونت
💾 انتہائی ویڈیو میموری اصلاح|QLoRA 4-bit کے ذریعے صارفین کے درجے کے GPU پر 70B چلانا
8.2 نقصانات (Weaknesses)
نقصان|تفصیل
👤 واحد فرد پر شدید انحصار|hiyouga کے پاس 72% commits (2,188/3,042)، Bus Factor = 1
📚 دستاویزات منتشر|README بہت طویل (68KB)، Wiki/ReadTheDocs/کمیونٹی مضامین میں معلومات بکھری ہوئی
🐛 Issues کا انبار|صرف 57 Open Issues، مگر Issue سیکشن میں بحث کا حجم بہت بڑا
🏗️ v0/v1 دوہرا انحصار|دو معماری ڈھانچوں کی دیکھ بھال مہنگی، v1 طویل عرصے سے مستحکم نہیں
📦 پیکیج انحصارات پیچیدہ|CUDA/PyTorch/FlashAttn ورژن میٹرکس میں غلطی کا امکان بہت زیادہ
🔒 علمی پروجیکٹ کی نوعیت|کل وقتی آپریشن ٹیم کا فقدان، طویل مدتی پائیداری مشکوک
8.3 مواقع (Opportunities)
موقع|تفصیل
🚀 Agent فائن ٹیوننگ کے منظرنامے|Function Calling / Tool Use فائن ٹیوننگ کی طلب میں تیزی
🎥 ملٹی موڈل توسیع|Video/Audio/3D ماڈل فائن ٹیوننگ کی نئی مارکیٹ
☁️ کلاؤڈ نیٹیو SaaS|LLaMA Factory Online بند ہو چکا ہے، مگر انٹرپرائز مینیجڈ سروسز کی طلب برقرار ہے
🏢 انٹرپرائز تربیتی مارکیٹ|بڑے ماڈلز کی فائن ٹیوننگ کے تربیتی کورسز اور سرٹیفکیشن نظام
🔗 MCP انضمام|AI Agent انفراسٹرکچر کے لیے فائن ٹیوننگ بیک اینڈ
8.4 خطرات (Threats)
خطرہ|تفصیل
🏢 بڑی کمپنیوں کے اندرونی فریم ورک|علی PAI اور Huawei ModelArts مربوط حل فراہم کرتے ہیں
🔄 HF کی سرکاری مسابقت|HuggingFace TRL/peft ایکوسسٹم مسلسل مکمل ہو رہا ہے
📉 فائن ٹیوننگ کی طلب میں کمی|Prompt Engineering + RAG فائن ٹیوننگ کے بعض منظرناموں کی جگہ لے رہے ہیں
👨🎓 بانی کی گریجویشن|ڈاکٹر Zheng Yaowei کی گریجویشن کے بعد پروجیکٹ کی دیکھ بھال میں کمی ممکن ہے
نو، خطرات کا جائزہ
خطرے کی قسم|خطرے کی سطح|وضاحت
Bus Factor|🔴 زیادہ خطرہ|ایک مرکزی ڈویلپر کے ذمے 72% کمٹس ہیں، اس کے رخصت ہونے کی صورت میں پروجیکٹ کے رک جانے کا خطرہ بہت زیادہ ہے
تکنیکی قرض|🟡 درمیانہ خطرہ|v0/v1 دوہرا آرکیٹیکچر، 68KB README، دستاویزات کا بکھرا ہوا ہونا
انحصاری سلسلہ|🟡 درمیانہ خطرہ|CUDA/PyTorch/FlashAttn کے ورژن میٹرکس کی دیکھ بھال کی لاگت زیادہ ہے
تجارتی استعمال|🟢 کم خطرہ|Apache-2.0 لائسنس، کوئی تجارتی پابندی نہیں
کمیونٹی کی صحت|🟢 صحت مند|7.2 لاکھ Stars، عالمی سطح پر فعال کمیونٹی، کاروباری اداروں میں وسیع استعمال
دس، تکنیکی جھلکیاں اور جدت
10.1 "معیاری تیز رفتار شاہراہ" آرکیٹیکچر
روایتی فائن ٹیوننگ میں مختلف ماڈلز کے لیے الگ الگ موافقت درکار ہوتی ہے۔ LLaMA Factory ٹیمپلیٹ رجسٹریشن میکانزم کو monkey‑patch ٹیکنالوجی کے ساتھ استعمال کرتا ہے، جس سے موافقت کی لاگت نمایاں طور پر کم ہو جاتی ہے۔
# نیا ماڈل شامل کرنے کے لیے صرف 3 مراحل:
# 1. template.py کی TEMPLATES ڈکشنری میں Prompt ٹیمپلیٹ رجسٹر کریں
# 2. patcher.py میں ماڈل مطابقت کا پیچ شامل کریں (اگر ضرورت ہو)
# 3. mm_plugin.py میں ملٹی موڈل سپورٹ شامل کریں (اگر ضرورت ہو)
10.2 چار سطحی پیرامیٹر کنفیگریشن سسٹم
YAML/JSON کنفیگریشن فائل
  → parser.py کے ذریعے تجزیہ
    → ModelArguments (ماڈل کا انتخاب، کوانٹائزیشن)
    → DataArguments (ڈیٹاسیٹ، ٹیمپلیٹ، پری پروسیسنگ)
    → FinetuningArguments (LoRA rank/target، ٹریننگ کا طریقہ)
    → TrainingArguments (HF سے وراثت، ڈسٹری بیوٹڈ ٹریننگ/لاگز/checkpoint)
10.3 ڈیٹا پائپ لائن کو معیاری بنانا
یہ ٹول Alpaca اور ShareGPT کے دو اہم ڈیٹا فارمیٹس کو سپورٹ کرتا ہے، 50 سے زیادہ پہلے سے تیار ڈیٹاسیٹس کو خودکار طور پر تبدیل کر سکتا ہے، اور JSON، JSONL، CSV، Parquet، Arrow سمیت مختلف فائل فارمیٹس کے ساتھ مطابقت رکھتا ہے۔
10.4 تدریجی کوانٹائزیشن سپورٹ
16 بٹ مکمل درستگی سے 2 بٹ QLoRA تک درستگی کی چھ سطحوں کو سپورٹ کرتا ہے، اور A100 سرور کلسٹرز سے لے کر عام لیپ ٹاپس تک مختلف ہارڈویئر ماحول میں استعمال کیا جا سکتا ہے۔
گیارہ، مسابقتی مصنوعات کا تقابلی میٹرکس
پہلو|LlamaFactory|HuggingFace TRL|Unsloth|Axolotl
Stars|72K|12K|20K+|8K
ماڈل سپورٹ|100+ سیریز|تمام HF|LLaMA/Qwen/Mistral|اہم سیریز
GUI|✅ LLaMA Board|❌|❌|❌
بغیر کوڈ|✅ CLI + YAML|❌ کوڈنگ درکار|❌ کوڈنگ درکار|صرف YAML
ٹریننگ پیراڈائم|8 اقسام|4 اقسام (SFT/DPO/PPO/GRPO)|3 اقسام|5 اقسام
کوانٹائزیشن کی گہرائی|2-16bit|4-16bit|4-16bit|4-16bit
ملٹی موڈل|✅ تصویر/ویڈیو/آڈیو|❌|❌|❌
چینی ماحولیاتی نظام|✅ ModelScope + 魔搭|⚠️ VPN درکار|⚠️ VPN درکار|❌
علمی مقالہ|ACL 2024|-|-|-
انفرنس انجن|vLLM/SGLang/HF|صرف HF|صرف HF|vLLM/HF
سیکھنے کا منحنی خط|انتہائی کم|درمیانہ|کم|درمیانے سے زیادہ
بارہ، تعیناتی کے عملی نکات
12.1 فوری آغاز (3 مراحل)
# مرحلہ 1: انسٹالیشن
git clone --depth 1 github.com/hiyouga/LlamaFactory.git
cd LlamaFactory
pip install -e ".[torch,metrics]"

# مرحلہ 2: Web UI شروع کریں
llamafactory-cli webui

# مرحلہ 3: براؤزر میں localhost:7860 کھولیں، ماڈل → ڈیٹاسیٹ → ٹریننگ منتخب کریں!
12.2 پروڈکشن ماحول کے لیے تجاویز
# Docker تعیناتی (تجویز کردہ)
docker run -it --rm --gpus=all \
    -v ./hf_cache:/root/.cache/huggingface \
    -v ./data:/app/shared_data \
    -v ./output:/app/output \
    -p 7860:7860 -p 8000:8000 \
    hiyouga/llamafactory:latest

# API تعیناتی (OpenAI مطابقت)
API_PORT=8000 llamafactory-cli api \
    examples/inference/qwen3.yaml \
    infer_backend=vllm
12.3 Windows صارفین کے لیے اہم نکات
PyTorch کا GPU ورژن دستی طور پر انسٹال کرنا ہوگا:
pip install torch torchvision torchaudio --index-url download.pytorch.org/whl/cu126QLoRA کے لیے Windows کا مخصوص bitsandbytes پری کمپائل شدہ ورژن انسٹال کریں
Windows پر FlashAttention-2 کو دستی طور پر کمپائل کرنا ہوگا
سیریلائزیشن کی خرابی سے بچنے کے لیے
dataloader_num_workers: 0سیٹ کریں
تیرہ، مستقبل کے امکانات
v1 آرکیٹیکچر کا استحکام:تجرباتی برانچ کے 2026-2027 میں مرکزی آرکیٹیکچر بننے کی توقع ہے، جس میں ماڈیولرٹی زیادہ ہوگی
Agent فائن ٹیوننگ میں گہرائی:Tool Use / Function Calling فائن ٹیوننگ معیاری فیچر بن جائے گی
Reasoning ماڈلز کی فائن ٹیوننگ:DeepSeek-R1 ڈسٹلیشن + GRPO فائن ٹیوننگ (EasyR1 پروجیکٹ)
کلاؤڈ نیٹو میزبانی:LLaMA Factory Online کے بند ہونے کے بعد، تیسرے فریق کی میزبانی کے حل سامنے آ سکتے ہیں
ملٹی موڈل ٹریننگ کا اتحاد:متن/تصویر/ویڈیو/آڈیو کی ایک ہی فریم ورک میں فائن ٹیوننگ
چودہ، اسکور اور خلاصہ
پہلو|اسکور|تبصرہ
تکنیکی آرکیٹیکچر|9.5/10|ماڈیولر ڈیزائن، دوہرے آرکیٹیکچر کا ارتقا، بھرپور انجن میٹرکس
فنکشنل تکمیل|10/10|8 ٹریننگ پیراڈائم × 6 فائن ٹیوننگ طریقے × 100+ ماڈلز
آسانیِ استعمال|10/10|ایک کمانڈ سے فائن ٹیوننگ + بغیر کوڈ Web UI، صنعت میں بہترین
دستاویزات کا معیار|7.5/10|README جامع مگر بہت طویل، شدید بکھرا ہوا
کمیونٹی کی فعالیت|9.5/10|72K Stars، چینی کمیونٹی میں غیر معمولی مقبولیت
پروڈکشن کے لیے تیاری|9.0/10|Docker/API/ڈسٹری بیوٹڈ سپورٹ مکمل، کاروباری اداروں میں کافی آزمائش
پائیدار ترقی|6.5/10|Bus Factor=1، علمی پروجیکٹ کی نوعیت، طویل مدتی صورتحال مشکوک
جدت|8.5/10|ACL مقالہ، ٹیمپلیٹ رجسٹریشن میکانزم، چار سطحی پیرامیٹر سسٹم
مجموعی اسکور: 9.
ایک جملے میں خلاصہ
LLaMA Factory ایک اوپن سورس بڑے ماڈلز کی فائن ٹیوننگ فریم ورک ہے، جو ACL 2024 کے مقالے کی بنیاد پر تیار کیا گیا ہے اور GitHub پر تقریباً 72 000 ستاروں کی کمیونٹی پذیرائی حاصل کر چکا ہے۔ یہ فریم ورک “الگورتھم‑ماڈل‑ڈیٹا کی علیحدگی” کے ڈیزائن اصول کی پیروی کرتا ہے، بغیر کوڈ کمانڈ لائن انٹرفیس (CLI) اور Web UI فراہم کرتا ہے، اور 100 سے زیادہ ماڈلز کی فائن ٹیوننگ کو سپورٹ کرتا ہے، جس سے بڑے ماڈلز کی فائن ٹیوننگ کی تکنیکی رکاوٹ نمایاں طور پر کم ہو جاتی ہے۔ اسے بڑے ماڈلز پر مبنی ایپلی کیشنز کی عملی تعیناتی کے لیے بنیادی ڈھانچے کے طور پر استعمال کیا جا سکتا ہے۔