

deepseek-recipe کیا ہے؟
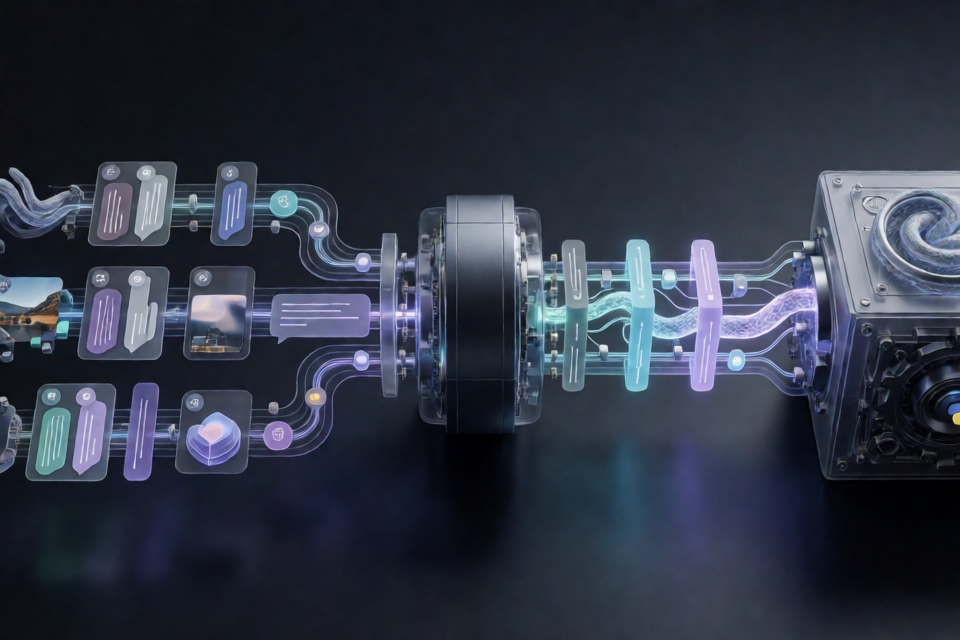
deepseek-recipe Rust لائبریریوں اور Python بائنڈنگز کا مجموعہ ہے جو API سروسز کو DeepSeek inference backends سے منسلک کرنے کے لیے استعمال ہوتا ہے۔ یہ معاون API فارمیٹس سے آنے والی درخواستوں کو مشترکہ Conversation نمائندگی میں تبدیل کرتا ہے، ان گفتگوؤں کو DeepSeek V4 یا V4.1 prompts کے طور پر رینڈر کرتا ہے، اور ماڈل کے آؤٹ پٹ کو متعلقہ response format میں واپس تبدیل کرتا ہے۔
یہ منصوبہ مکمل inference server کے بجائے protocol اور prompt-processing layer ہے۔ آپ کو model inference، HTTP transport، اور tool execution الگ سے فراہم کرنا ہوں گے۔
پروسیسنگ پائپ لائن کیسے کام کرتی ہے
- درخواست کو Messages، Chat Completions، یا Responses format میں وصول کریں۔
- درخواست کو لائبریری کے مشترکہ Conversation format میں تبدیل کریں۔
- گفتگو کو DeepSeek V4 یا V4.1 prompt کے طور پر رینڈر کریں، یا اسے token IDs میں encode کریں۔
- Prompt یا token IDs کو بیرونی inference backend کو بھیجیں۔
- تیار کردہ آؤٹ پٹ کو parse کریں، جس میں معاون thinking content، tool calls، JSON objects، اور stop sequences شامل ہیں۔
- کلائنٹ کے متوقع format میں مکمل یا streaming response واپس کریں۔
deepseek-recipe خود model نہیں چلاتا، tools execute نہیں کرتا، اور HTTP service فراہم نہیں کرتا۔ مثال کے Rust اور Python servers repository میں integration references کے طور پر دستیاب ہیں۔
اہم خصوصیات
- متحد protocol conversion: Messages، Chat Completions، اور Responses کی requests اور responses کو handle کرتا ہے۔
- DeepSeek prompt encoding: DeepSeek V4 اور V4.1 conversations کو prompts یا token IDs کے طور پر رینڈر کرتا ہے۔
- Streaming اور مکمل responses: دونوں response styles کی conversion کو سپورٹ کرتا ہے۔
- Generation settings: thinking mode، reasoning effort،
temperature،top_p، اور output token limits کو منتقل کرتا ہے۔ - Output parsing: thinking content، client tool calls، JSON object output، اور stop sequences کو پہچانتا ہے۔
- Multimodal input: base64 data یا external URLs کے ذریعے فراہم کردہ تصاویر قبول کرتا ہے۔ image package OpenCV کے ساتھ DeepSeek V4.1 preprocessing فراہم کرتا ہے۔
- Tool definitions: function tools کو سپورٹ کرتا ہے۔ Responses API اضافی طور پر tool namespaces اور
apply_patchcustom tool کو بھی سپورٹ کرتی ہے۔
Python installation اور setup
تقاضے
Python bindings کے لیے Python 3.10 یا اس کے بعد کا ورژن درکار ہے۔ شائع شدہ package کو pip کے ذریعے انسٹال کریں:
python3 -m pip install deepseek-recipeانسٹال شدہ module کو deepseek_recipe کے طور پر import کیا جاتا ہے۔
Chat Completions request کو تبدیل کریں
درج ذیل مثال Chat Completions request بناتی ہے، اسے مشترکہ Conversation representation میں تبدیل کرتی ہے، اور اس گفتگو کو DeepSeek V4.1 prompt کے طور پر رینڈر کرتی ہے:
from deepseek_recipe import (
    ChatCompletionRequest,
    ConversionOptions,
    DeepseekV41Encoding,
)

request = ChatCompletionRequest({
    "model": "deepseek-flash",
    "messages": [
        {"role": "user", "content": "Hello"}
    ],
})

converted = request.convert(ConversionOptions())
rendered = DeepseekV41Encoding().render_conversation(
    converted.conversation
)

print(rendered.prompt)
ہر مرحلہ سمجھیں
ChatCompletionRequestموصول ہونے والے Chat Completions data کو پڑھتا ہے۔request.convert(ConversionOptions())درخواست کو Conversation میں normalize کرتا ہے۔DeepseekV41Encoding()DeepSeek V4.1 encoding rules منتخب کرتا ہے۔render_conversationmodel-ready representation بناتا ہے۔rendered.promptوہ prompt رکھتا ہے جسے آپ کے بیرونی inference backend کو بھیجا جائے گا۔
Inference کے بعد، generated model output کو آپ کے کلائنٹ کے مطلوبہ API format میں تبدیل کرنے کے لیے منصوبے کے response-conversion اور output-parsing components استعمال کریں۔ درست integration اس بات پر منحصر ہے کہ آپ کا backend مکمل output واپس کرتا ہے یا generated data کو stream کرتا ہے۔
Rust installation اور setup
Crates شامل کریں
Rust project میں protocol conversion اور encoding crates شامل کریں:
cargo add deepseek-recipe@0.1 deepseek-recipe-encoding@0.1اگر آپ source سے build کر رہے ہیں یا image processing فعال کر رہے ہیں، تو build instructions اور image dependencies کے لیے repository کی development guide دیکھیں۔
DeepSeek V4.1 prompt رینڈر کریں
use deepseek_recipe::openai::ChatCompletionRequest;
use deepseek_recipe::request::{ConversionOptions, ProtocolRequest};
use deepseek_recipe_encoding::PromptEncoding;
use deepseek_recipe_encoding::v4::dsv41::DeepseekV41Encoding;
use serde_json::json;

fn main() -> Result<(), Box<dyn std::error::Error>> {
    let request: ChatCompletionRequest = serde_json::from_value(json!({
        "model": "deepseek-flash",
        "messages": [
            {"role": "user", "content": "Hello"}
        ],
    }))?;

    let converted = request.convert(ConversionOptions::default())?;
    let rendered = DeepseekV41Encoding::new()
        .render_conversation(&converted.conversation);

    println!("{}", rendered.prompt);
    Ok(())
}
یہاں Serde JSON کو ChatCompletionRequest میں deserialize کرتا ہے۔ ProtocolRequest trait request conversion فراہم کرتا ہے، جبکہ PromptEncoding conversation rendering فراہم کرتا ہے۔ اس کے بعد resulting prompt کو الگ سے managed inference engine کو دیا جا سکتا ہے۔
Encoding اور decoding demo دریافت کریں
Repository میں prompts رینڈر کرنے، special tokens کا معائنہ کرنے، اور مکمل model output کو Chat Completions، Responses، یا Messages formats میں decode کرنے کے لیے web interface شامل ہے۔
Repository root سے چلائیں:
cargo run -p encoding-decoding-demo --lockedپھر براؤزر میں http://127.0.0.1:7778 کھولیں۔
یہ ڈیمو پرامپٹ کی ساخت جانچنے اور یہ سمجھنے کے لیے مفید ہے کہ لائبریریوں کو سرور میں ضم کرنے سے پہلے تیار کردہ آؤٹ پٹ معاون API رسپانس فارمیٹس میں کیسے تبدیل ہوتا ہے۔
پیکیج کا جائزہ
deepseek-recipe: پروٹوکول کی تبدیلی اور ماڈل آؤٹ پٹ کی پارسنگ۔deepseek-recipe-core: گفتگو، پیغام، تصویر اور ٹول کی مشترکہ اقسام۔deepseek-recipe-encoding: DeepSeek V4 اور V4.1 پرامپٹ کی رینڈرنگ اور ٹوکن انکوڈنگ۔deepseek-recipe-image: تصاویر حاصل کرنا اور پری پروسیسنگ۔deepseek-recipe-python:deepseek_recipeامپورٹ کے ذریعے فراہم کردہ Python bindings۔encoding-decoding-demo: براؤزر پر مبنی پرامپٹ اور آؤٹ پٹ کا معائنہ۔server-rs: mock inference استعمال کرنے والی Axum API کی مثال۔server-py: mock inference استعمال کرنے والی FastAPI کی مثال۔
اعلیٰ سطحی انضمام کی تجاویز
پروٹوکول ہینڈلنگ کو inference سے الگ رکھیں
اپنی ایپلیکیشن کی حدود پر deepseek-recipe استعمال کریں۔ inference سے پہلے آنے والی درخواستوں کو تبدیل کریں اور اس کے بعد تیار کردہ آؤٹ پٹ کو parse کریں۔ ماڈل لوڈنگ، batching، scheduling اور ہارڈویئر مینجمنٹ اپنے inference backend کے اندر رکھیں۔
پرامپٹس یا ٹوکن IDs کا سوچ سمجھ کر انتخاب کریں
آپ گفتگو کو ٹیکسٹ پرامپٹس کے طور پر رینڈر کر سکتے ہیں یا انہیں ٹوکن IDs میں encode کر سکتے ہیں۔ جب آپ کا backend فارمیٹ شدہ متن قبول کرے تو پرامپٹ رینڈرنگ استعمال کریں۔ جب آپ کا backend براہِ راست tokenizer IDs کے ساتھ کام کرے تو ٹوکن انکوڈنگ استعمال کریں۔ repository کی tokenizer guide میں گفتگو کو encode کرنے اور backend کے ٹوکن IDs کو decode کرنے کا طریقہ بیان کیا گیا ہے۔
اسٹریمنگ کو ابتدا تا انتہا فیچر کے طور پر منصوبہ بند کریں
Rust اور Python دونوں ماڈل آؤٹ پٹ کو streaming responses میں تبدیل کرنے کی سہولت دیتے ہیں۔ آپ کے transport اور inference backend کو بھی ڈیٹا stream کرنا ہوگا؛ لائبریری یہ تہیں فراہم نہیں کرتی۔ incremental model output کو client-facing API سے جوڑتے وقت streaming response guide کی پیروی کریں۔
inference سے پہلے تصاویر کو سنبھالیں
درخواستوں میں تصاویر base64 content یا بیرونی URLs کے ذریعے شامل ہو سکتی ہیں۔ مخصوص image component، OpenCV کے ساتھ تصاویر حاصل کرنے اور DeepSeek V4.1 پری پروسیسنگ کی سہولت دیتا ہے۔ source سے build کرتے وقت یقینی بنائیں کہ مطلوبہ image dependencies انسٹال ہوں۔
ٹول execution کو لائبریری سے باہر رکھیں
یہ project tool definitions کی نمائندگی اور client tool calls کی parsing کر سکتا ہے، لیکن یہ ان ٹولز کو execute نہیں کرتا۔ آپ کی ایپلیکیشن کو ہر call کی توثیق کرنی ہوگی، متعلقہ function یا custom tool چلانا ہوگا، اور نتیجہ گفتگو کے اگلے turn میں شامل کرنا ہوگا۔
موجودہ حدود کا خیال رکھیں
project کے گرد API ڈیزائن کرنے سے پہلے ان فیچرز کو مدنظر رکھیں جو ابھی معاونت یافتہ نہیں ہیں:
logprobsیاtop_logprobsکے ذریعے ٹوکن احتمالات۔- Document content، audio یا video input، اور
file_idکے ذریعے retrieval۔ - سرور کے ذریعے execute کیے جانے والے tools، جیسے
web_search۔ - JSON Schema اور regular-expression output constraints۔
- tool
strictsettings کا enforcement۔ - جب
n > 1ہو تو متعدد Chat Completions choices۔ apply_patchکے علاوہ Responses custom tool definitions۔- Responses conversation storage یا
previous_response_idکے ذریعے context retrieval۔ encrypted_contentکے ذریعے encrypted thinking content۔
نتیجہ
deepseek-recipe کئی API پروٹوکولز کو معمول پر لانے، DeepSeek V4 اور V4.1 inputs بنانے، اور تیار کردہ آؤٹ پٹ کو client-facing responses میں واپس تبدیل کرنے کے لیے قابلِ دوبارہ استعمال Rust اور Python components فراہم کرتا ہے۔ بنیادی request conversion example سے آغاز کریں، demo کے ذریعے رویے کا معائنہ کریں، پھر conversion pipeline کو اپنے inference، transport اور tool-execution infrastructure سے جوڑیں۔
project code اور عوامی documentation MIT License کے تحت دستیاب ہیں۔