

DeepSelect کیا ہے؟
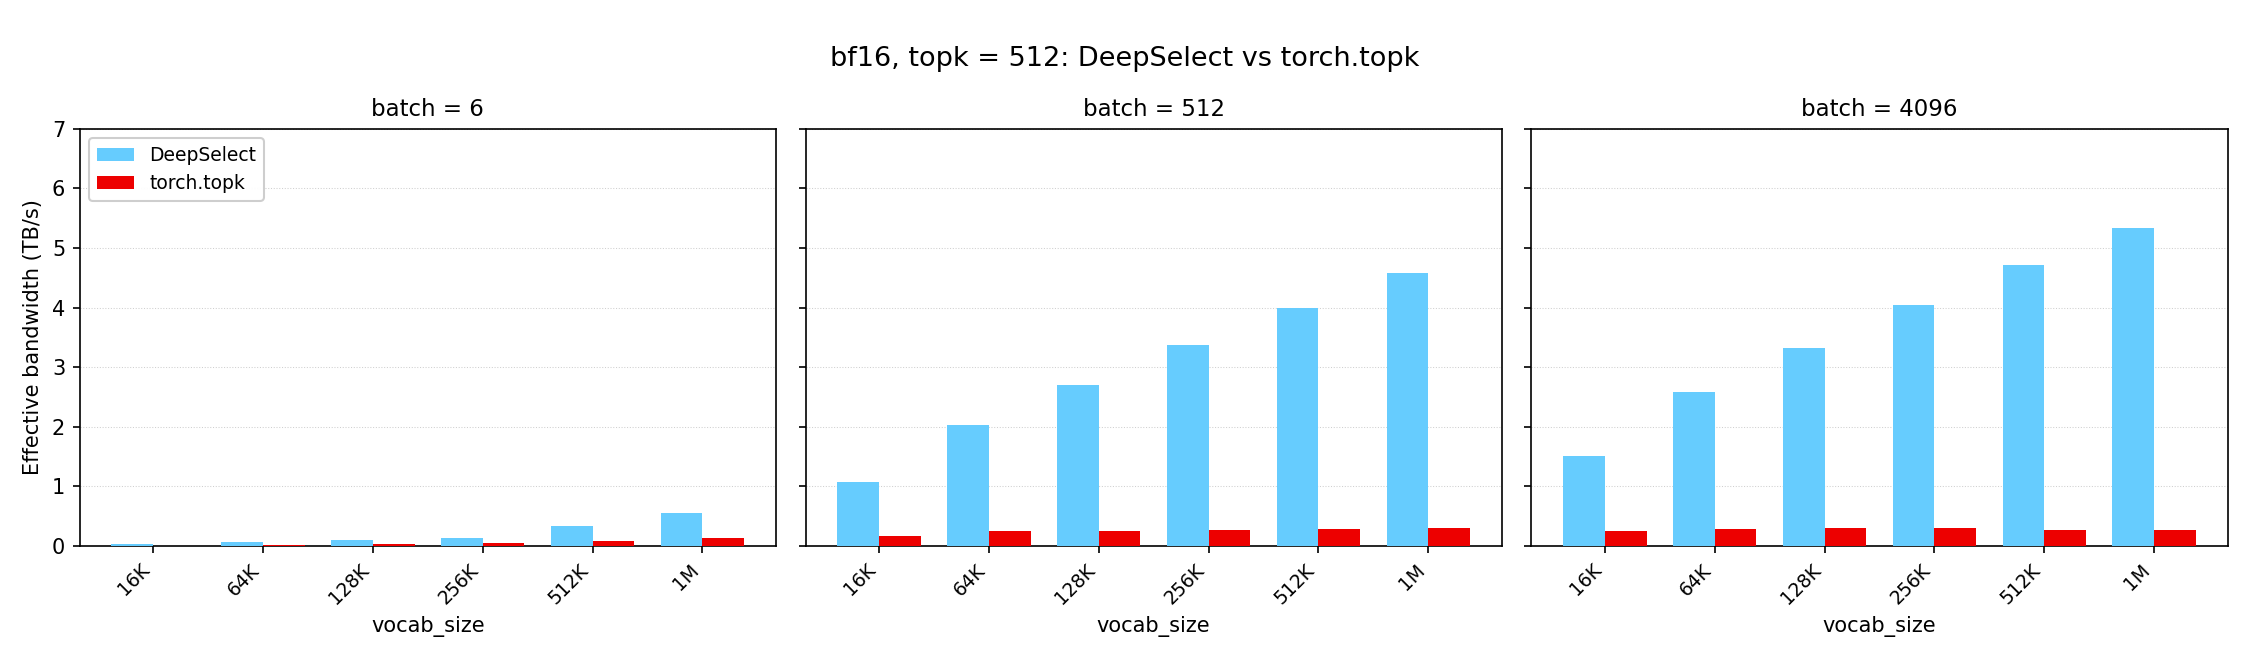
DeepSelect، DeepSeek Sparse Attention اور sampling میں استعمال ہونے والے TopK kernel کا ایک اعلیٰ کارکردگی والا implementation ہے۔ پروجیکٹ README کے مطابق، لائبریری کے معاون workloads کے لیے یہ vanilla torch.topk کے مقابلے میں 2–20 گنا رفتار فراہم کر سکتا ہے۔
ہر ممکنہ TopK configuration کو بہتر بنانے کی کوشش کرنے کے بجائے، DeepSelect دو scenarios پر توجہ مرکوز کرتا ہے: torch.bfloat16 inputs استعمال کرنے والا Lightning Indexer workload اور torch.float32 inputs استعمال کرنے والا sampling workload۔
معاون workloads
Lightning Indexer scenario
- Input type:
torch.bfloat16 - Batch size: 1 سے شروع، چھوٹے اور بڑے دونوں batches کے لیے optimizations کے ساتھ
- Vocabulary size: 1 سے شروع، چھوٹی اور بڑی دونوں vocabularies کے لیے optimizations کے ساتھ
- TopK size: چھوٹا اور
4096سے زیادہ نہیں
بہتر کارکردگی کے لیے sorted_index کو disabled رکھیں، جب تک نتائج کو ترتیب دینا ضروری نہ ہو۔ اگر values درکار نہ ہوں تو ان کا output چھوڑنے کے لیے return_value=False مقرر کریں۔
Sampling scenario
- Input type:
torch.float32 - Batch size: 1 سے شروع
- Vocabulary size: تقریباً 128K
- TopK size: چھوٹا اور
4096سے زیادہ نہیں
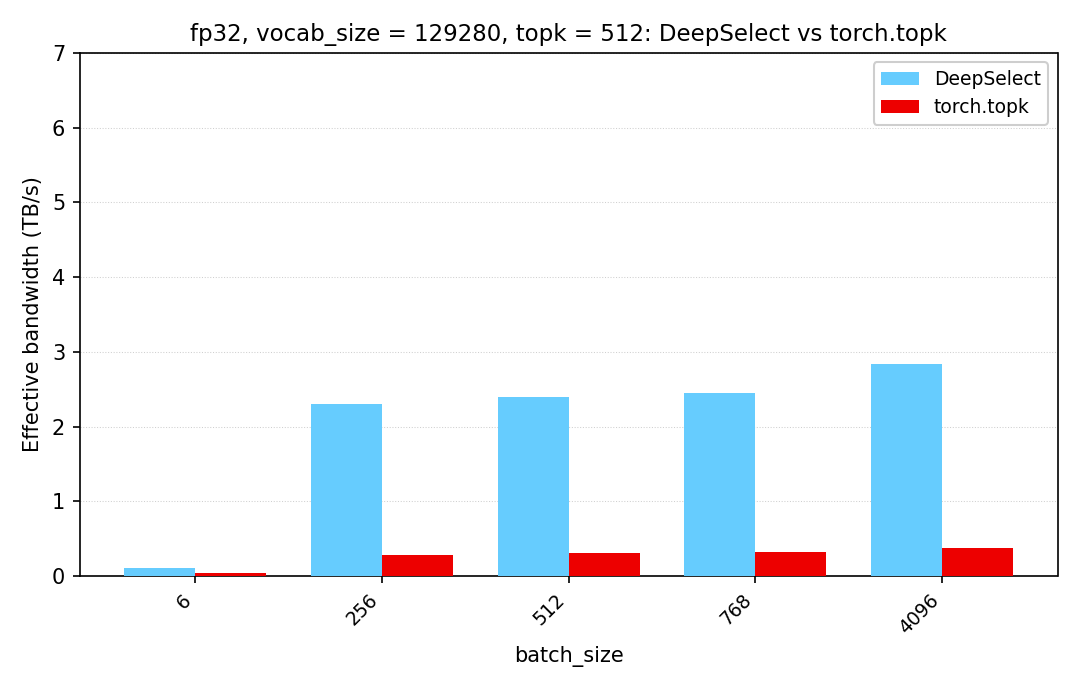
Repository کارکردگی کو floating-point throughput کے بجائے مؤثر memory bandwidth کے ذریعے ماپتی ہے، کیونکہ TopK floating-point arithmetic انجام نہیں دیتا۔ اس کا benchmark اسی input پر torch.topk کے مقابلے میں کارکردگی رپورٹ کرتا ہے۔
اہم خصوصیات
- DeepSeek Sparse Attention اور sampling workloads کے لیے مخصوص TopK kernels
- متعلقہ target scenarios میں
torch.bfloat16اورtorch.float32inputs کی معاونت torch.int32یاtorch.int64index output کی configuration- کم overhead کے لیے اختیاری value output، جب صرف indices درکار ہوں
- ہر row کے exclusive upper bound کے ذریعے variable-length rows
- indices کے لیے user-managed output buffers
- بلٹ اِن NaN checking
Installation
Repository کو clone کریں، اس کے submodules initialize کریں، اور project directory سے package install کریں:
git clone https://github.com/deepseek-ai/DeepSelect.git
cd DeepSelect
git submodule update --init --recursive
pip install -v .
Examples میں CUDA tensors استعمال ہوتے ہیں، اس لیے inputs کو device="cuda" پر بنائیں۔
بنیادی TopK استعمال
PyTorch اور DeepSelect import کریں، دو dimensions والا input tensor بنائیں، اور deep_select.topk کال کریں:
import torch
import deep_select

batch_size = 4
vocab_size = 204800
topk = 1024

x = torch.randn(
    batch_size,
    vocab_size,
    dtype=torch.bfloat16,
    device="cuda",
)

values, indices = deep_select.topk(
    x,
    topk,
    sorted_index=True,
    indices_type=torch.int32,
    return_value=True,
)

print(values.shape)   # (4, 1024)
print(indices.shape)  # (4, 1024)
Input کی shape (batch_size, vocab_size) ہونی چاہیے۔ اس کا آخری dimension contiguous ہونا چاہیے، اور اس کا row stride deep_select.get_stride_requirement()[0] bytes کا multiple ہونا چاہیے۔
واپس آنے والی values کا data type x جیسا ہی ہوتا ہے۔ Indices کے لیے indices_type کے ذریعے منتخب کیا گیا type استعمال ہوتا ہے، جو torch.int32 یا torch.int64 ہو سکتا ہے۔ sorted_index=True ہونے پر ہر row کے واپس آنے والے indices ascending order میں ترتیب دیے جاتے ہیں۔
صرف indices واپس حاصل کرنا
اگر downstream code کو منتخب values کی ضرورت نہ ہو تو value output کو disabled کریں:
values, indices = deep_select.topk(
    x,
    topk,
    sorted_index=False,
    indices_type=torch.int32,
    return_value=False,
)
README کے مطابق، value output چھوڑنے سے رفتار تقریباً 10% بڑھ جاتی ہے۔ جب تک ترتیب ضروری نہ ہو، sorted output طلب کرنے سے گریز کریں، کیونکہ sorting اضافی overhead پیدا کرتی ہے۔
Stride Alignment کا انتظام
DeepSelect input rows اور output rows کے لیے alignment requirements عائد کرتا ہے۔ انہیں runtime پر دیکھیں:
input_alignment, output_alignment = deep_select.get_stride_requirement()

print("Input row-stride alignment:", input_alignment, "bytes")
print("Output row-stride alignment:", output_alignment, "bytes")
اگر کسی input کا row stride مطلوبہ input alignment کا multiple نہ ہو تو اسے DeepSelect کو دینے سے پہلے tensor کو pad کریں۔ آخری dimension contiguous رہنا چاہیے۔
DeepSelect بطور default دونوں outputs allocate کرتا ہے۔ ان کے strides deep_select.get_stride_requirement()[1] bytes کے مطابق aligned ہوتے ہیں، جس کا مطلب ہے کہ واپس آنے والے tensors non-contiguous ہو سکتے ہیں۔ Outputs استعمال کرنے والے code کو standard contiguous strides فرض نہیں کرنے چاہییں۔
موجودہ index buffer استعمال کرنا
جب indices کو caller کے managed buffer میں لکھنا ہو تو API output_idx= قبول کرتی ہے۔ اس buffer کو اسی output stride requirement پر پورا اترنا چاہیے۔ Custom buffer configure کرنے سے پہلے مکمل function signature کے لیے deep_select/interface.py دیکھیں۔
Variable-Length Rows کے ساتھ کام کرنا
ہر row کے لیے exclusive upper bound مقرر کرنے کے لیے end استعمال کریں۔ یہ اس وقت مفید ہے جب ایک ہی batch کی rows میں مختلف valid lengths ہوں:
import torch
import deep_select

batch_size = 2
vocab_size = 129280

x = torch.randn(
    batch_size,
    vocab_size,
    dtype=torch.float32,
    device="cuda",
)

end = torch.tensor(
    [129280, 100000],
    dtype=torch.int32,
    device="cuda",
)

values, indices = deep_select.topk(
    x,
    1000,
    end=end,
    sorted=True,
    indices_type=torch.int64,
)
یہاں پہلی قطار تمام 129280 عناصر استعمال کر سکتی ہے، جبکہ دوسری قطار پہلے 100000 عناصر تک محدود ہے۔ اگر کسی قطار کی لمبائی مطلوبہ TopK سائز سے کم ہو، تو DeepSelect اس کے آؤٹ پٹس میں value_oob_fill_value اور idx_oob_fill_value شامل کر کے انہیں مطلوبہ سائز تک مکمل کرتا ہے۔
NaN کا انتظام
NaN کی جانچ ہمیشہ فعال رہتی ہے۔ پہلے سے طے شدہ طور پر abort_when_nan_found=True ہوتا ہے، اس لیے NaN ملنے پر کرنل trap() کو کال کر کے عمل روک دیتا ہے۔ جن قطاروں کی مؤثر لمبائی مطلوبہ TopK سائز سے کم یا اس کے برابر ہو، ان میں NaN کی جانچ نہیں کی جاتی۔
اگر NaN موجود ہونے کا امکان ہو تو کرنل شروع کرنے سے پہلے ان پٹ ڈیٹا کی توثیق یا صفائی کریں، خاص طور پر پہلے سے طے شدہ عمل روکنے والے رویے کو برقرار رکھتے وقت۔
کارکردگی اور جدید تجاویز
- موزوں TopK حد کے اندر رہیں۔ DeepSelect چھوٹی TopK قدروں کو
4096تک، بشمول4096، سپورٹ کرتا ہے۔ اس سے بڑی قدریں سپورٹ نہیں کی جاتیں۔ - مطلوبہ ورک لوڈ کے مطابق انتخاب کریں۔ پروجیکٹ میں بیان کردہ Lightning Indexer منظرنامے کے لیے
torch.bfloat16، اور sampling منظرنامے کے لیےtorch.float32استعمال کریں۔ - ممکن ہو تو sorting چھوڑ دیں۔ انڈیکس یا قدر کے مطابق ترتیب دینے سے کارکردگی کم ہوتی ہے، اس لیے اسے صرف اسی وقت طلب کریں جب بعد کی پروسیسنگ کو اس کی ضرورت ہو۔
- ممکن ہو تو values چھوڑ دیں۔ جب صرف انڈیکس استعمال کیے جائیں تو
return_value=Falseمقرر کریں۔ - alignment کا آغاز ہی میں جائزہ لیں۔ کارکردگی کے لحاظ سے اہم لوپ میں غیر مطابقت رکھنے والے tensors کو درست کرنے کے بجائے
get_stride_requirement()کے مطابق tensor shapes اور padding کی منصوبہ بندی کریں۔ - contiguous outputs فرض نہ کریں۔ DeepSelect آؤٹ پٹ قطاروں کے strides کو align کرتا ہے، اس لیے نتیجے میں ملنے والے tensors non-contiguous ہو سکتے ہیں۔
- حقیقی shape پر benchmark کریں۔ TopK کی کارکردگی input type، batch size، vocabulary size، اور TopK size پر منحصر ہوتی ہے۔ ایپلیکیشن میں استعمال ہونے والی عین configuration کی جانچ کریں۔
فراہم کردہ benchmark چلانا
repository میں اپنی test script کے اندر performance mode شامل ہے:
python3 tests/test.py --perf-onlyیہ benchmark انہی inputs پر DeepSelect کا torch.topk سے موازنہ کرتا ہے اور مؤثر memory bandwidth استعمال کرتے ہوئے تناسب رپورٹ کرتا ہے۔
نتیجہ
DeepSelect مطابقت رکھنے والے DeepSeek Sparse Attention اور sampling ورک لوڈز کے لیے خصوصی TopK kernels فراہم کرتا ہے۔ دو جہتی aligned CUDA tensor سے آغاز کریں، topk کو 4096 یا اس سے کم رکھیں، اور جہاں ضرورت نہ ہو sorting یا value output کو غیر فعال کریں۔ production integration کے لیے stride requirements کی توثیق کریں، ممکنہ non-contiguous outputs کو مدِنظر رکھیں، اور اپنی ایپلیکیشن میں استعمال ہونے والی عین tensor shapes پر benchmark کریں۔