

ری کرنٹ لوپڈ ٹرانسفارمر کیا ہے؟
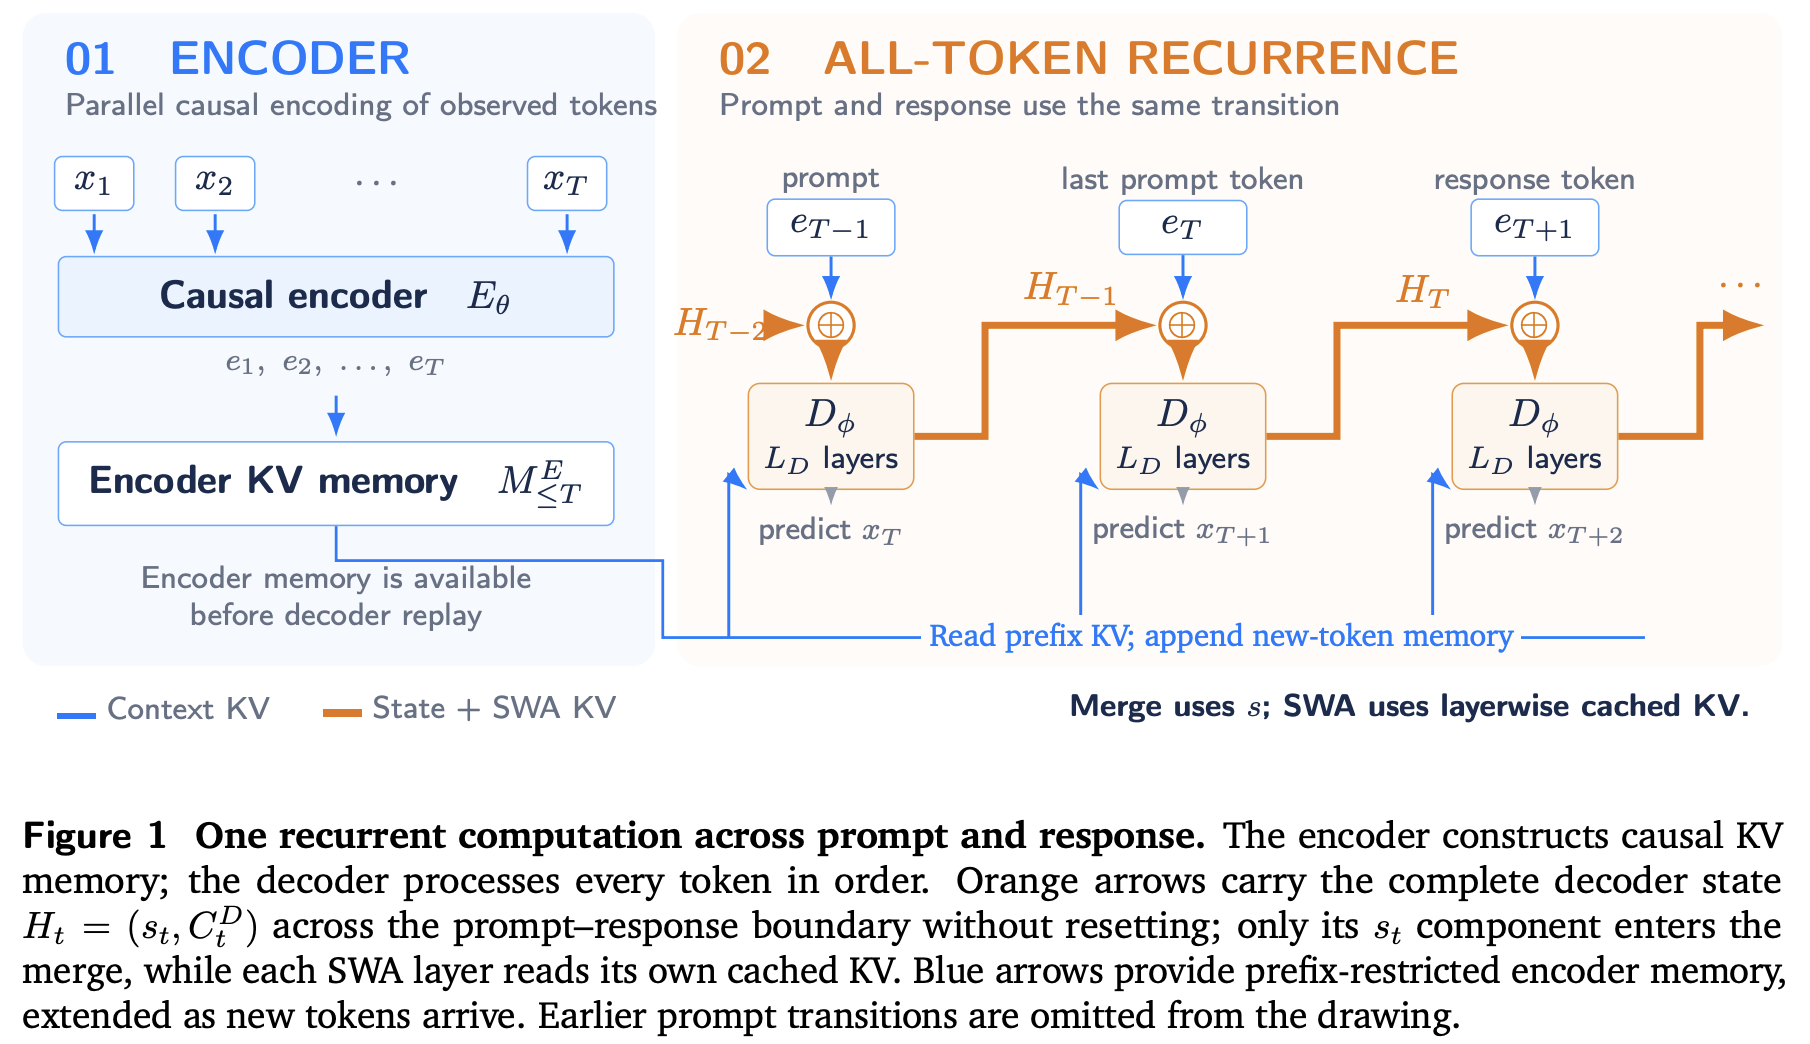
ری کرنٹ لوپڈ ٹرانسفارمر (RLT) ایک تحقیقی آرکیٹیکچر ہے جسے ترتیب کے ہر ٹوکن میں latent computation منتقل کرنے کے لیے ڈیزائن کیا گیا ہے۔ ایک causal encoder عالمی key–value memory تیار کرتا ہے، جبکہ ایک recurrent decoder اس memory کو sliding-window attention اور اپنی سابقہ آخری hidden state سے ملنے والے feedback کے ساتھ یکجا کرتا ہے۔
اس سے ایک قابلِ توسیع temporal computation path بنتا ہے۔ اگر decoder میں L_D layers ہوں، تو t tokens کی processing سے tL_D decoder blocks کے ذریعے ایک recurrent path بنتا ہے، حالانکہ model ہر token کے لیے صرف مقررہ تعداد میں blocks چلاتا ہے۔
اس project میں “لامحدود temporal depth” سے مراد یہ ہے کہ computation path sequence length کے ساتھ بڑھ سکتا ہے۔ اس کا مطلب یہ نہیں کہ model کسی ایک token کے اندر لامحدود computation کرتا ہے۔
اہم ڈیزائن اصول
1. وقت کے دوران latent reasoning
ایک token کے لیے آخری decoder output اگلے token کے لیے input بن جاتا ہے۔ نتیجتاً، model prompt اور generated response کے درمیان boundary کو reset point سمجھنے کے بجائے پورے prompt اور generated response میں latent state منتقل کر سکتا ہے۔
2. Model اور hardware کا مشترکہ ڈیزائن
مجوزہ ڈیزائن کئی ممکنہ optimization مواقع فراہم کرتا ہے:
- معلوم tokens پر causal-encoder computation کو parallel چلانا
- آزاد sequences کے درمیان batching
- encoder سے حاصل شدہ memory کا دوبارہ استعمال
- recurrent decoder execution کے گرد activation checkpointing
یہ design opportunities اور research goals ہیں۔ رپورٹ بڑے پیمانے پر hardware speedups کی پیمائش کا دعویٰ نہیں کرتی۔
3. Training اور reinforcement learning کے لیے مشترکہ semantics
Pretraining، supervised fine-tuning، sampling، اور current-policy reinforcement learning replay، سب ایک ہی مکمل state transition استعمال کرتے ہیں۔ اس state میں prompt recurrence کے ساتھ decoder کے sliding-window key–value caches بھی شامل ہیں۔
آرکیٹیکچر کیسے کام کرتا ہے
کسی token x_t کے لیے causal encoder ایک representation e_t اور encoder سے حاصل شدہ global memory M_≤t تیار کرتا ہے۔ Decoder state میں recurrent output اور layerwise sliding-window attention cache دونوں شامل ہوتے ہیں:
H_t = (s_t, C_t^D)
H_0 = (s_*, empty)
State transition یہ ہے:
(s_t, C_t^D) = D_phi(
  Merge(e_t, s_(t-1)),
  M_≤t,
  C_(t-1)^D,
  t
)
اگلے token کی distribution آخری recurrent output سے calculate کی جاتی ہے:
p(x_(t+1) | x_(1:t)) = softmax(W_o RMSNorm_o(s_t))Context کی تین صورتیں
- Global encoder context: Decoder cross-attention صرف موجودہ position کے ذریعے encoder memory پڑھتا ہے، جس سے causal behavior برقرار رہتا ہے۔
- Local decoder memory: Sliding-window attention حالیہ decoder key–value entries اور موجودہ token کی entry پڑھتا ہے۔
Wسائز کی window میں موجودہ token شامل ہوتا ہے، اس لیے اگلی update کے لیے زیادہ سے زیادہW - 1تاریخی entries باقی رہتی ہیں۔ - Temporal feedback: سابقہ آخری decoder output کو موجودہ encoder representation کے ساتھ merge کیا جاتا ہے۔
Sequence کے prompt سے response میں منتقل ہونے پر نہ recurrent output reset ہوتا ہے اور نہ decoder cache۔
Concrete model configuration
رپورٹ میں 48 encoder layers اور 48 decoder layers والی configuration بیان کی گئی ہے۔ Compatible attention اور feed-forward weights stages کے درمیان shared ہیں۔ Decoder blocks encoder memory پر cross-attention بھی انجام دیتے ہیں، اس لیے layer counts کا یکساں ہونا floating-point operation counts کے یکساں ہونے کا مطلب نہیں ہے۔
Installation اور Repository Setup
README ایک documented software package کے بجائے architectural report پیش کرتا ہے۔ اس میں dependency requirements، installation command، public training script، یا runnable API فراہم نہیں کی گئی۔ پھر بھی آپ paper اور supporting material پڑھنے کے لیے repository clone کر سکتے ہیں:
git clone https://github.com/yifanzhang-pro/recurrent-looped-tranformer.git
cd recurrent-looped-tranformer
شامل کردہ Recurrent_Looped_Transformer.pdf سے آغاز کریں۔ آپ project website بھی دیکھ سکتے ہیں اور prefill–decode kernel mismatch note کا جائزہ لے سکتے ہیں۔
چونکہ README کسی executable implementation کی دستاویز نہیں دیتا، اس لیے repository کی description سے package installation instructions یا ready-to-run model code اخذ نہیں کیا جانا چاہیے۔
بنیادی استعمال: RLT Execution Model کی پیروی
رپورٹ کو لاگو کرنے کا سب سے مفید طریقہ اسے implementation blueprint کے طور پر استعمال کرنا ہے۔ درج ذیل conceptual pseudocode ایک state transition کا خلاصہ پیش کرتا ہے؛ یہ repository کی فراہم کردہ API نہیں ہے:
state = (initial_recurrent_state, empty_decoder_cache)

for each token x_t:
    e_t = causal_encoder_representation(x_t)
    memory = encoder_memory_through_position(t)

    merged = Merge(e_t, state.recurrent_output)
    state = recurrent_decoder(
        merged,
        memory,
        state.decoder_cache,
        position=t
    )

    next_token_distribution = output_head(state.recurrent_output)
Prompt prefill
- معلوم prompt tokens پر causal encoder کو batch کے طور پر چلائیں۔
- Decoder کے ذریعے ہر prompt token پر recurrence چلائیں۔
- اس recurrence کے دوران decoder sliding-window key–value cache تیار کریں۔
- Generation کے لیے آخری recurrent output اور cache محفوظ رکھیں۔
پرامپٹ پری فل کے دوران صرف اینکوڈر چلانے سے رپورٹ میں بیان کردہ مکمل RLT حالت دوبارہ تشکیل نہیں پائے گی۔
آٹو ریگریسو جنریشن
- اگلے ٹوکن کی تقسیم معلوم کرنے کے لیے سابقہ حالت استعمال کریں۔
- اس تقسیم سے ایک ٹوکن سیمپل کریں۔
- سیمپل کیے گئے ٹوکن کو بتدریج انکوڈ کریں۔
- اس ٹوکن کو recurrent decoder کے ذریعے بالکل ایک بار گزاریں۔
- recurrent output اور sliding-window cache دونوں کو اپ ڈیٹ کریں۔
یہ ترتیب کسی generated token کو دوبارہ گزارنے سے بچاتی ہے اور تربیت کے دوران استعمال ہونے والی وہی state-transition semantics برقرار رکھتی ہے۔
پری ٹریننگ اور supervised fine-tuning
پری ٹریننگ کے دوران اینکوڈر causal انداز میں چلتا ہے اور recurrent decoder مکمل backpropagation through time استعمال کرتا ہے۔ ہر درست next-token target کی نگرانی کی جاتی ہے۔
supervised fine-tuning کے دوران تمام context tokens پر state اپ ڈیٹ کی جاتی ہے، لیکن loss صرف assistant targets پر لاگو ہوتا ہے۔ پرامپٹ recurrent state کی تشکیل میں پھر بھی شامل رہتا ہے، چاہے اس کے tokens کی نگرانی نہ کی جائے۔
Current-Policy Reinforcement Learning Replay
Current-policy replay کے لیے موجودہ ماڈل weights کے تحت sequence history کو مکمل طور پر دوبارہ تشکیل دینا ضروری ہے۔ اس میں recurrent outputs، encoder memory، اور decoder کی تمام sliding-window caches شامل ہیں۔
- موجودہ parameters استعمال کرتے ہوئے encoder representations اور memory دوبارہ بنائیں۔
- recurrent state اور decoder caches دوبارہ بنانے کے لیے ہر سابقہ token کو replay کریں۔
- کسی action token کو استعمال کرنے سے پہلے اس کے احتمال کا جائزہ لیں۔
- اگلی state تک پہنچنے کے لیے action کو ایک بار استعمال کریں۔
Weight update کے بعد parameter-dependent caches پرانی ہو جاتی ہیں، اس لیے درست replay کے لیے انہیں دوبارہ بنانا ضروری ہے۔ مکمل gradients recurrent outputs، decoder key–value entries، اور encoder memory سے گزرتے ہیں۔ ان میں سے کسی بھی حصے کو detach کرنا gradient approximation ہے۔
Behavior log-probabilities اسی distribution سے مطابقت رکھنی چاہییں جو sampling کے لیے حقیقتاً استعمال ہوئی ہو۔ درست importance sampling کے لیے support coverage بھی ضروری ہے۔ مشترکہ execution semantics ساختی prompt-boundary mismatch کو کم کرتی ہیں، لیکن kernels کے درمیان numerical parity یا unbiased off-policy objective کی ضمانت نہیں دیتیں۔
ابتدائی مصنوعی نتائج
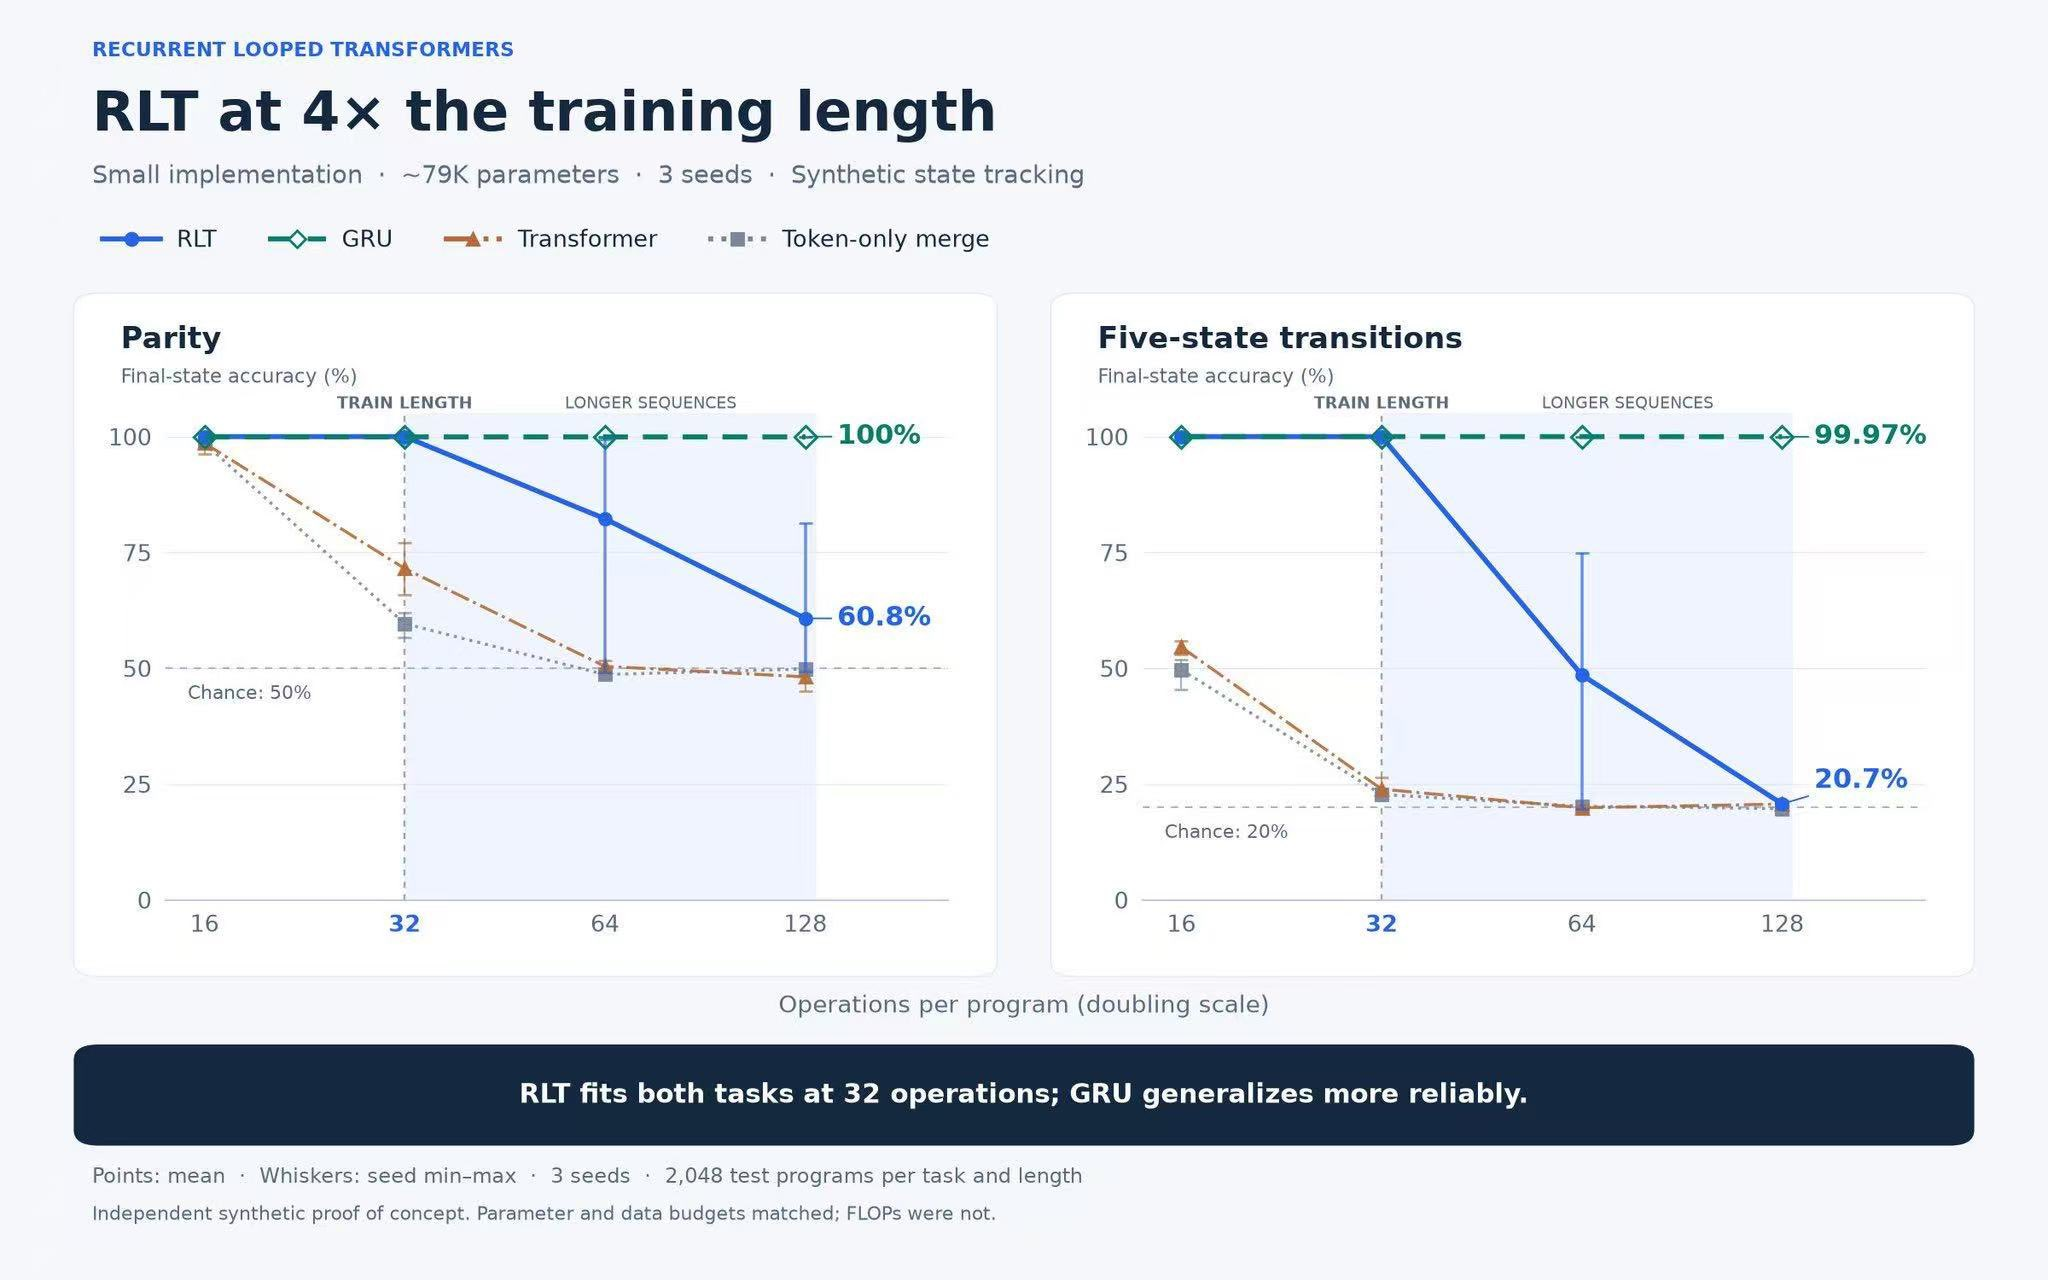
README میں ایک چھوٹی implementation کے ذریعے آزاد proof-of-concept state-tracking تجربات رپورٹ کیے گئے ہیں، جس میں تقریباً 79,000 parameters اور three random seeds استعمال ہوئے۔ ماڈلز کو 32 operations کی sequences پر تربیت دی گئی اور زیادہ سے زیادہ 128 operations پر جانچا گیا، جبکہ ہر task اور length کے لیے 2,048 test programs استعمال کیے گئے۔
Parity task
- 32 operations پر RLT نے تقریباً 100% final-state accuracy حاصل کی۔
- 64 operations پر یہ تقریباً 82% تک پہنچا۔
- 128 operations پر یہ 60.8% رہا۔
- Parity کے لیے chance accuracy 50% ہے۔
Five-state transition task
- 32 operations پر RLT نے تقریباً 100% final-state accuracy حاصل کی۔
- 64 operations پر یہ تقریباً 49% تک پہنچا۔
- 128 operations پر یہ 20.7% رہا۔
- اس task کے لیے chance accuracy 20% ہے۔
نتائج ظاہر کرتے ہیں کہ RLT نے training length پر دونوں tasks کو fit کیا، لیکن لمبی sequences پر اس کی accuracy کم ہو گئی۔ Approximate کے طور پر نشان زد values اصل figure سے پڑھی گئیں، جبکہ 128-operation RLT values عددی طور پر درج تھیں۔
Parameter اور data budgets یکساں رکھے گئے، لیکن floating-point operation budgets یکساں نہیں تھے۔ یہ تجربات synthetic demonstrations ہیں، large-scale reasoning improvements، hardware acceleration، یا reinforcement learning scaling کے شواہد نہیں۔
اعلیٰ درجے کی implementation تجاویز
- مکمل state کو ناقابلِ تقسیم سمجھیں:
s_tاورC_t^Dدونوں محفوظ رکھیں۔ صرف recurrent vector بحال کرنے سے documented transition دوبارہ پیدا نہیں ہوتی۔ - Response boundaries پر reset نہ کریں: Prompt recurrence اور اس کی decoder cache براہِ راست response generation میں منتقل ہونی چاہیے۔
- Window کو درست طور پر متعین کریں:
Wسائز کی sliding window میں موجودہ token شامل ہوتا ہے، اس لیے اگلی update کے لیے صرفW - 1تاریخی entries دستیاب رہتی ہیں۔ - Updates کے بعد caches دوبارہ بنائیں: Current-policy replay کے لیے موجودہ weights سے بنائی گئی caches درکار ہوتی ہیں، نہ کہ سابقہ policy سے محفوظ کی گئی values۔
- Sampling اور replay کی ترتیب ہم آہنگ رکھیں: سابقہ state سے generated action کا جائزہ لیں، پھر اسے ایک بار استعمال کریں۔
- درست gradients اور approximations میں فرق رکھیں: Recurrent state، decoder caches، یا encoder memory کو detach کرنے سے gradient path تبدیل ہو جاتا ہے۔
- Compute کو الگ سے ناپیں: یکساں parameter یا data budgets یکساں FLOPs ثابت نہیں کرتے، خاص طور پر اس لیے کہ decoder layers encoder-memory cross-attention شامل کرتی ہیں۔
- Numerical behavior کی توثیق کریں: مشترکہ high-level execution semantics خودکار طور پر prefill اور decode kernels کے درمیان فرق ختم نہیں کرتیں۔
نتیجہ
Recurrent Looped Transformer عالمی causal encoder memory، مقامی decoder sliding-window attention، اور token-to-token recurrent feedback کو یکجا کرتا ہے۔ اس کا بنیادی implementation rule consistency ہے: ہر prompt اور response token کو pretraining، fine-tuning، generation، اور current-policy replay کے دوران اسی مکمل state transition میں شامل ہونا چاہیے۔
ابتدائی تجربات چھوٹے state-tracking tasks پر مفید length generalization کی تجویز دیتے ہیں، لیکن training length سے آگے performance پھر بھی کم ہو جاتی ہے۔ اس لیے اس architecture کو validated large-scale reasoning system کے بجائے research proposal اور proof of concept سمجھنا چاہیے۔