
- Oylik tashriflar
- 0
- Narxlar
- Belgilanmagan
- Ro‘yxatga kiritilgan
- —
- Yangilangan
- 2026-10-08
01VoxMem nima?
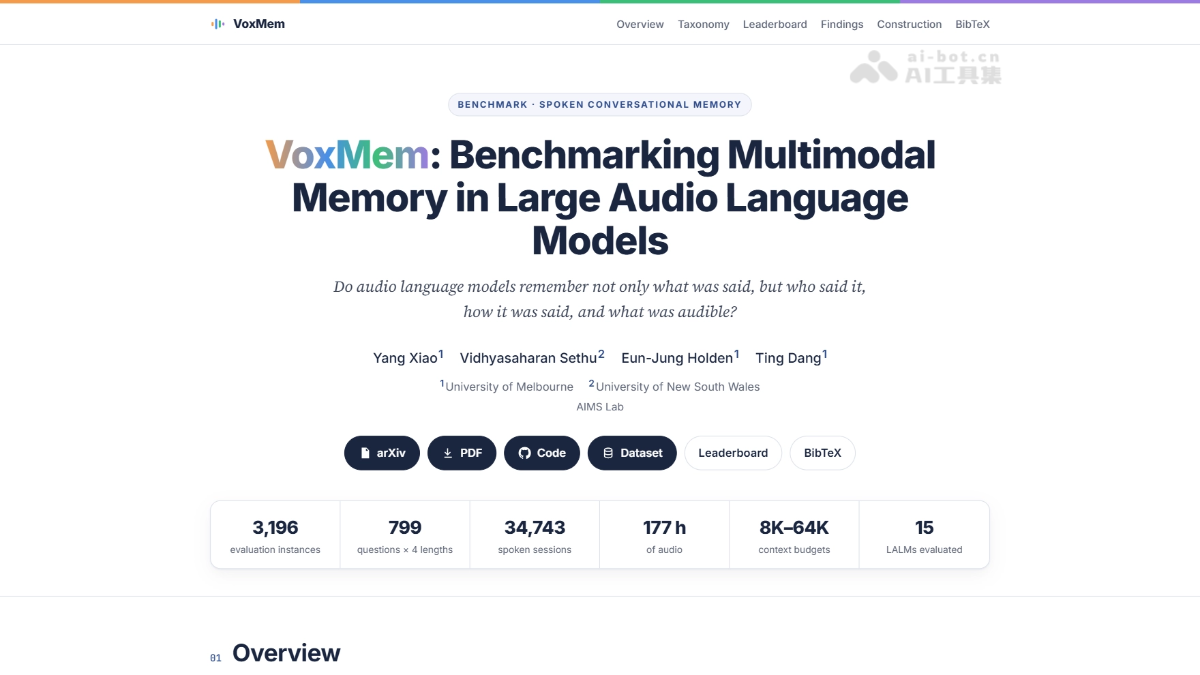
VoxMem — Melburn universiteti va Yangi Janubiy Uels universiteti jamoalari tomonidan ishlab chiqilgan audio katta modellar xotirasi benchmarki. U 4 turdagi akustik dalilni ilk bor qamrab oladi: semantika, so‘zlovchi, ohang, atrof-muhit tovushi × 4 xil xotira amali: ajratib olish, sessiyalararo xulosa chiqarish, vaqt bo‘yicha kuzatish va javob berishdan bosh tortishdan iborat ikki o‘lchovli baholash tizimi. U 8K dan 64K tokenli ko‘p sessiyali tarixni qamrab oladi. 15 ta model sinovi shuni ko‘rsatdiki, 32K sharoitida hech bir modelning umumiy aniqligi 40% dan oshmagan. Modellar nima aytilganini eslab qolishi mumkin, ammo kim aytganini va qanday aytilganini eslab qolishda qiynaladi; audio kontekstni shunchaki uzaytirish barqaror ovozli muloqotni ta’minlash uchun yetarli emas.
02VoxMem’ning asosiy funksiyalari
Ko‘p sessiyali ovozli xotirani baholash: ko‘p sessiyali va turli davomiylikdagi ovozli tarix sharoitida audio til modellari avvalgi suhbat mazmunini eslab, qayta tiklay olishini tizimli tekshiradi.
Akustik dalillarning to‘rt turi: nutq semantikasi, so‘zlovchi shaxsi, paralingvistik belgilar va atrof-muhit tovushi birgalikda baholanadi. Oxirgi uch tur transkripsiya orqali tiklab bo‘lmaydigan “audioga xos” ma’lumotlardir.
Xotiraning to‘rt amal turi: axborotni ajratib olish, ko‘p sessiyali xulosa chiqarish, vaqt bo‘yicha o‘zgarishlarni kuzatish va dalil yetarli bo‘lmaganda javob berishdan bosh tortish. Ular juftlab kesishilganda 15 ta amaldagi baholash katagi hosil bo‘ladi.
Nazorat qilinadigan tarix uzunligi: bir xil savol uchun 8K/16K/32K/64K tokenli to‘rtta tarix uzunligida dalillar mutlaqo o‘zgarmaydi, faqat chalg‘ituvchi sessiyalar qo‘shiladi. Bu uzunlikning xotiraga ta’sirini alohida ajratish imkonini beradi.
Ochiq baholash tizimi: kod va ma’lumotlar to‘liq ochiq manbali. Standart ishga tushirish, baholash skriptlari va Leaderboard taqdim etiladi; API modellari hamda mahalliy modellarni qayta sinash qo‘llab-quvvatlanadi.
03VoxMem’ning texnik tamoyillari
WeChat’da kuzatib boring va “开源” deb javob yuboring, AI ochiq manba loyihalari guruhiga qo‘shiling
Ikki o‘lchovli tasniflash tizimi: VoxMem’ning asosiy dizayni akustik dalil × xotira amali ikki o‘lchovli tasniflash jadvalidir. Akustik dalil nimani eslab qolish kerakligini belgilaydi: ovozli ma’lumot semantika, so‘zlovchi, paralingvistika va atrof-muhit tovushi kabi to‘rt turga ajratiladi. Xotira amali esa undan qanday foydalanishni belgilaydi: bitta sessiyadan axborotni qaytarib olish (IE), bir nechta sessiyalar bo‘yicha dalillarni birlashtirish (MSR), vaqt ketma-ketligida holat o‘zgarishini kuzatish (TET) va dalil yetarli bo‘lmaganda javob berishdan bosh tortish (AR). Semantika × IE kombinatsiyasi sof matn qidiruviga aylanib ketgani sababli ataylab chiqarib tashlangan. Qolgan 15 ta katak to‘liq baholash makonini tashkil etadi va akustik xotira qobiliyatlari tizimli, tasodifiy emas, tarzda tekshirilishini ta’minlaydi.
Ma’lumotlarni uch bosqichda yaratish: ma’lumotlar “rejalashtirish — dialog yozish — nutz sintezi” jarayoni asosida yaratiladi: avval har bir savol uchun savol, javob, dalillar taqsimoti va amal qilish cheklovlarini belgilovchi tuzilmaviy reja tuziladi; keyin foydalanuvchi va yordamchi tomonlarining dialog matnlari alohida yaratiladi. Ikkala tomon ham so‘zlovchi, ohang yoki fon tovushlarini tilga olmaydi, shu orqali javobning matndan sizib chiqishiga yo‘l qo‘yilmaydi; oxirida TTS yordamida nutq sintez qilinadi. Har bir foydalanuvchiga doimiy ovoz tembri beriladi, ohang belgilari uslub nazorati orqali kiritiladi, atrof-muhit tovushi esa 10dB signal-shovqin nisbatida aralashtiriladi. Har bir belgili navbat uchun belgilar olib tashlangan juft nusxa ham sifat nazorati uchun saqlanadi.
Chalg‘ituvchi sessiyalar va uzunlikni nazorat qilish: har bir tarix dalil sessiyalari, chalg‘ituvchi sessiyalar va to‘ldiruvchi sessiyalardan iborat. Chalg‘ituvchi sessiyalarning mavzusi dalil mavzusiga o‘xshash, ammo qiymatlari boshqacha bo‘ladi. Ular faqat matnga qaraydigan va aniqligi 51–56% bo‘lgan klassifikator yordamida tekshiriladi; shu tariqa model yuzaki mavzu mosligi orqali javobni topa olmaydi. Uzunlik nazoratida to‘rtta tarix darajasi qat’iy ichma-ich joylashtiriladi va tarixni uzaytirish uchun faqat aloqasiz to‘ldiruvchi sessiyalar qo‘shiladi. Savol, javob va dalillar to‘rtta darajada aynan bir xil bo‘ladi; aniqlikdagi o‘zgarish faqat tarixning uzayishi bilan izohlanadi va savol murakkabligi aralashuvi chiqarib tashlanadi.
04VoxMem’dan qanday foydalanish kerak
Repozitoriyni klonlash: GitHub’dan kodni yuklab oling: git clone https://github.com/swagshaw/voxmem va loyiha katalogiga kiring.
Bog‘liqliklarni o‘rnatish: pip install -r requirements.txt buyrug‘ini ishga tushiring. Ixtiyoriy ravishda pip install "datasets" buyrug‘i orqali audioni avtomatik ravishda massivga dekodlashni yoqishingiz mumkin.
API kalitini sozlash: API modelini baholash uchun tegishli SDK’ni o‘rnating va kalitni sozlang, masalan, pip install openai dan so‘ng export OPENAI_API_KEY=.
Smoke testini ishga tushirish: avval jarayonni tekshirish uchun python run_voxmembench.py --config 8k_speaker_information --model abstain --allow-abstention --limit 25 --out predictions_smoke.jsonl buyrug‘ini ishga tushiring. Keyin score_voxmembench.py --judge exact-match orqali baholang va javobdan bosh tortish qatlami rad etish kerak bo‘lgan savollarda 1.0, javob berish mumkin bo‘lgan savollarda 0.0 olishini tekshiring.
Rasmiy baholash: konfiguratsiyani (masalan, 32k to‘liq to‘plami yoki 32k_speaker_information quyi to‘plami) va maqsadli modelni tanlab ishga tushiring, masalan: python run_voxmembench.py --config 32k --model openai:gpt-4o-audio-preview --allow-abstention --out predictions_32k.jsonl; mahalliy modellar uchun maxsus adapter funksiyasini --adapter orqali ko‘rsating va vaznlar katalogini --model-dir bilan belgilang.
LLM hakami orqali baholash: python score_voxmembench.py --predictions predictions_32k.jsonl --judge openai:gpt-4o-mini --out metrics_32k.json buyrug‘ini ishga tushiring. Hakam faqat savol, standart javob va berilgan javobni ko‘rib, ochiq javoblarning ekvivalentligini aniqlaydi.
05VoxMem’ning asosiy afzalliklari
Audio uchun xos xotirani tizimli qamrab olgan birinchi benchmark: mavjud benchmarklarning faqat so‘z mazmunini tekshirish cheklovini yengib, kim aytgani, qanday aytilgani va nima eshitilgani kabi matndan tashqari akustik ma’lumotlarni yagona baholash tizimiga birinchi bor kiritadi.
Ikki o‘lchovli tasniflash dizayni puxta: 4 turdagi akustik dalil × 4 xil xotira amalidan iborat 15 ta amaldagi katak tasodifiy savollar o‘rnini egallaydi va ovozli xotira qobiliyatini to‘liq, ortogonal tarzda tahlil qilish imkonini beradi.
Ko‘p sessiyali sozlama haqiqiy vaziyatlarga yaqin: inson va mashina o‘rtasidagi ovozli muloqotda vaqt davomida kechadigan ko‘p sessiyalarni modellashtiradi. Bu bitta uzun monolog emas, balki modelning takroran uchraydigan so‘zlovchilar va holat yangilanishlarini uzoq muddat eslab qolishini tekshiradi.
Uzunlik ta’siri to‘liq ajratilgan: bir xil savol uchun 8K dan 64K gacha bo‘lgan to‘rtta tarix uzunligida dalillar qat’iy ichma-ich joylashtiriladi va o‘zgarmaydi. Shu tariqa “tarixning uzayishi” ta’siri savol murakkabligi va dalil turidan ilk bor aniq ajratiladi.
Sizib chiqishdan himoyalangan tuzilma va ikki bosqichli sifat nazorati: dialog ishtirokchilarining hech biri akustik belgilarni tilga olmaydi, juft nusxalar taqqoslanadi va faqat transkripsiya orqali javob berish mumkin bo‘lgan savollar ikki bosqichli tekshiruvda chiqarib tashlanadi. Shu bilan savolga haqiqatan “o‘qish” emas, “tinglash” orqali javob berish talab qilinadi.
Chalg‘ituvchi dizayn orqali qisqa yo‘llardan foydalanish qiyin: mavzusi o‘xshash, ammo qiymatlari boshqacha chalg‘ituvchi sessiyalar 51–56% aniqlikka ega matn klassifikatori bilan tekshiriladi va kalit so‘zlar orqali javob topish imkoniyati bartaraf etiladi.
06VoxMem loyihasi manzillari
Loyiha rasmiy sayti: https://swagshaw.github.io/voxmem/
GitHub repozitoriysi: https://github.com/swagshaw/voxmem
HuggingFace modellari: https://huggingface.co/datasets/AudioMemory/voxmembench
arXiv texnik maqolasi: https://arxiv.org/pdf/2609.32607
07VoxMem’ning qo‘llanish sohalari
Ovozli yordamchilar va aqlli karnaylarning uzoq muddatli xotirasini tanlash: ishlab chiqaruvchilar VoxMem yordamida nomzod modellarning sessiyalar bo‘yicha foydalanuvchi xohishlari, oila a’zolari ovozi va avvalgi va’dalarni eslab qolishini yagona tizimda tekshirishi mumkin. Bu mahsulot ishga tushgach, “o‘tgan hafta aytilgan gapni darhol unutish” muammosining oldini oladi.
Avtomobil ichidagi va taqiladigan qurilmalardagi ovozli muloqotni baholash: avtomobil salonidagi muhit tovushi shovqinli, foydalanuvchi ohangi esa o‘zgaruvchan bo‘lishi mumkin. VoxMem’ning atrof-muhit tovushi va paralingvistik belgilar o‘lchovlari model xotirasining haqiqiy shovqinli sharoitlardagi ishonchliligini tekshiradi.
Ko‘p so‘zlovchili mijozlarga xizmat ko‘rsatish va konferensiya tizimlari sifat nazorati: call-markazlar va yig‘ilish bayonnomalari kabi vaziyatlarda “qaysi gapni kim aytgani”ni to‘g‘ri bog‘lash zarur. VoxMem’ning so‘zlovchini bog‘lashdagi noto‘g‘ri atributsiya o‘lchovi bunday tizimlardagi “bir kishining gapini boshqasiga nisbat berish” muammosini bevosita aniqlashga yordam beradi.
Hamroh robotlar va keksalarga g‘amxo‘rlik mahsulotlarida hissiy xotirani tekshirish: keksa odamning o‘tgan hafta xo‘rsinib aytgan gapi yoki ohangida sezilgan charchoqni faqat paralingvistik belgilar yetkaza oladi. VoxMem’ning vaqt bo‘yicha kuzatish o‘lchovi mahsulot holatning vaqt davomida o‘zgarishini sezishi mumkinligini tekshiradi.
© Ogohlantirish: domenlar va havola qilingan kontent vaqt o‘tishi bilan o‘zgarishi mumkin. AIEZZ uchinchi tomon veb-saytlarini nazorat qilmaydi. Tashqi kontent va xatarlarni mustaqil ravishda ko‘rib chiqing.
Foydalanuvchi sharhlari0