
- Oylik tashriflar
- 0
- Narxlar
- Belgilanmagan
- Ro‘yxatga kiritilgan
- —
- Yangilangan
- 2026-10-09
01Naive-N0.5-Flash nima
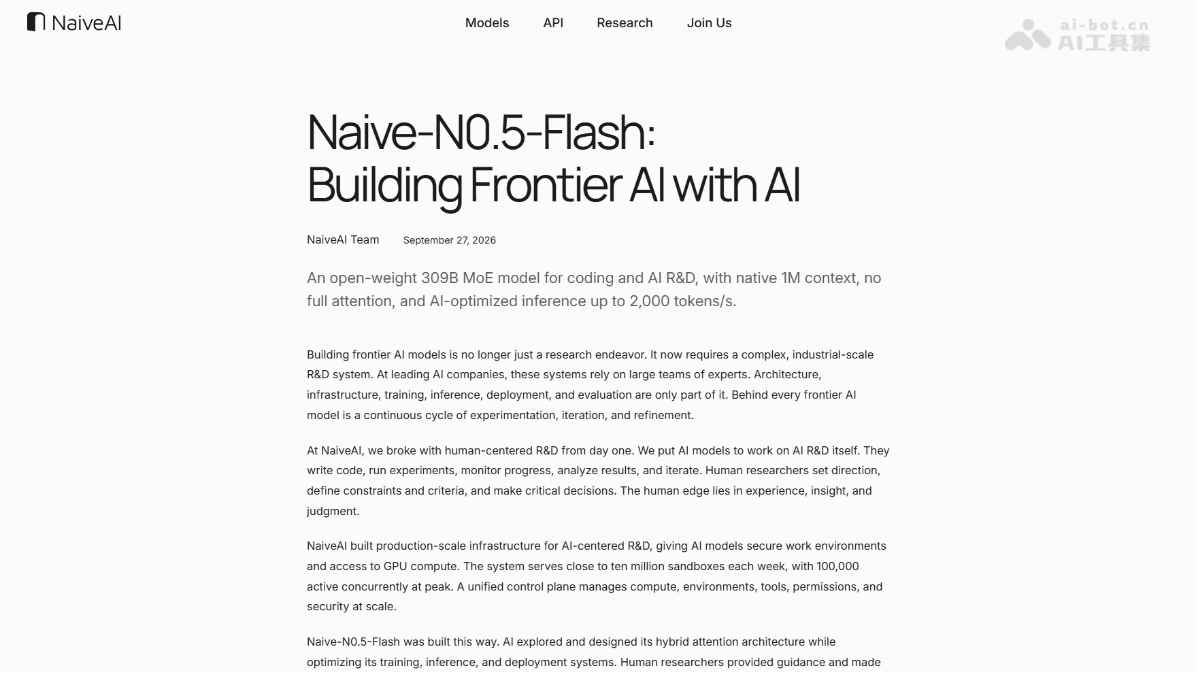
Naive-N0.5-Flash — NaiveAI ochiq manba sifatida taqdim etgan ilk MoE katta modeli bo‘lib, dasturlash va AI tadqiqot-ishlab chiqish senariylariga mo‘ljallangan. Naive-N0.5-Flash Xiaomi MiMo-V2.5 bazaviy modeliga asoslangan, 309B MoE arxitekturasiga ega, SWA+DSA aralash siyrak e’tibor mexanizmidan foydalanadi, 1M kontekstni tabiiy ravishda qo‘llab-quvvatlaydi va to‘liq e’tibor qatlamlariga ega emas. Model AI tomonidan chuqur ishtirok etilgan holda ishlab chiqilgan, unga mos NaiveRT xulosa chiqarish tizimida bir oqimli dekodlash tezligi 2122 tokens/s ga yetadi.
02Naive-N0.5-Flash ning asosiy funksiyalari
Uzoq kontekstli dasturlash: 1M tokenlik kontekstni tabiiy ravishda qo‘llab-quvvatlaydi, juda katta kod omborlari va uzoq davom etadigan dasturiy muhandislik vazifalarini qayta ishlay oladi.
AI tadqiqot-ishlab chiqish yordami: maqolalarni o‘qiydi, usullarni takrorlaydi, tajribalarni ishga tushiradi, natijalarni tahlil qiladi va model ishlab chiqishning barcha bosqichlarida bevosita ishtirok etadi.
Xulosa chiqarishni tezlashtirish: NaiveRT tizimi bilan standart rejimda 50 tokens/s, yuqori tezlik rejimida esa bir oqimli dekodlash tezligi 2,122 tokens/s ga yetadi.
Avtonom ilmiy tadqiqot: maqsad, hisoblash resurslari budjeti va baholash protokoli berilganda, tadqiqotni boshidan oxirigacha mustaqil olib bora oladi.
03Naive-N0.5-Flash ning texnik prinsiplari
WeChat’da kuzatib, “开源” deb javob yuboring va AI ochiq manba loyihalari muhokama guruhiga qo‘shiling
SWA–DSA aralash siyrak e’tibor mexanizmi: model MiMo-V2.5 bazaviy modeliga asoslangan bo‘lib, dastlabki qimmat global e’tibor qatlamlari DeepSeek siyrak e’tibor mexanizmi bilan almashtirilgan. Ular sirg‘aluvchi oyna e’tibori bilan 5:1 nisbatda navbatma-navbat joylashtiriladi va butun tarmoqda hech qanday to‘liq e’tibor qatlami mavjud emas. SWA 128 tokenlik mahalliy oynani qayta ishlaydi, DSA esa yengil indeksator orqali butun tarixga baho beradi va asosiy hisoblash uchun top-2048 tokenni tanlaydi.
Yengil indeksator dizayni: DSA’dagi MLA GQA bilan almashtirilgan, indeksator so‘rov kallaklari 64 tadan 16 tagacha kamaytirilgan. Natijada indeks tanlash yo‘li uchun sarflanadigan vaqt 44% ga qisqaradi, shu bilan birga 1M kontekstli Agent vazifalarida unumdorlik pasaymaydi.
Uch bosqichli o‘qitish jarayoni: avval 50B token davomida asosiy tarmoq muzlatiladi va KL-divergensiya yo‘qotishi yordamida indeksator hamda to‘liq e’tibor taqsimoti moslashtiriladi; keyin siyrak e’tiborga o‘tilib, 3T tokenlik qo‘shimcha oldindan o‘qitish amalga oshiriladi, yangi axborot tanlash mexanizmiga moslashiladi hamda dasturlash va tadqiqot qobiliyatlari kuchaytiriladi; oxirida 200B tokenlik nazoratli nozik sozlash bajarilib, o‘rganish tezligi pasaytiriladi. Jarayon davomida 1M kontekst saqlanadi, top-k qaytarib chaqirish tahlili va sonli barqarorlikni tuzatish AI tomonidan avtomatik bajariladi.
Aralash ketma-ketlik parallelligi va videoxotirani optimallashtirish: SWA faqat mahalliy oynaga, DSA esa butun tarixga muhtojligi sababli ular uchun alohida Halo ketma-ketlik parallelligi qo‘llanadi; videoxotira tomonida aktivlarni yukdan chiqarish darajasi operator darajasigacha aniqlashtiriladi, tanlovning qayta hisoblash sababli o‘zgarishiga yo‘l qo‘ymaslik uchun top-k indekslar aniq saqlanadi. 512 ta karta yordamida taxminan 4 kunda 1T tokenni o‘qitish mumkin.
NaiveRT xulosa chiqarishni optimallashtirish: ulkan operatorlarni birlashtirish, yuqori va quyi oqim yadrolarini ustma-ust bajarish uchun PDL hamda spekulyativ dekodlash siklini to‘liq GPU’da bajarish orqali bir dekodlash bosqichidagi kechikish 12.3ms dan 3.4ms gacha qisqartiriladi; shuningdek, tasodifiy urug‘ asosida bitma-bit deterministik tanlashni qo‘llab-quvvatlaydi va RL o‘qitishida tanlash natijasi bilan o‘qitish logprob qiymatining mos kelishini ta’minlaydi. Barcha optimallashtirishlar uchun mezon sifatida uchidan uchigacha bo‘lgan haqiqiy model yo‘li olinadi.
04Naive-N0.5-Flash dan qanday foydalaniladi
Uskunani tekshirish: FP8 ni qo‘llab-quvvatlaydigan NVIDIA GPU kerak; model og‘irliklari taxminan 315GB bo‘lib, qo‘shimcha videoxotira zaxirasi talab etiladi.
Og‘irliklarni olish: Hugging Face’dan NaiveAI/Naive-N0.5-Flash-FP8 omborini yuklab oling.
Bog‘liqliklarni o‘rnatish: pip install "transformers[torch,kernels]>=5.17.0" buyrug‘ini bajaring.
Modelni yuklash: AutoTokenizer va AutoModelForCausalLM yordamida trust_remote_code=True, device_map="auto" parametrlari bilan yuklang.
Kiritishni tayyorlash: xabarlar dialogini apply_chat_template orqali uzating va kiritish tensorlarini yarating.
Natijani generatsiya qilish: javobni yaratish uchun model.generate(), chiqishni dekodlash uchun tokenizer.decode() funksiyasini chaqiring.
Parametrlarni sozlash: umumiy holatlar uchun temperature=1.0, top_p=0.95 tavsiya etiladi.
Yuqori unumdor xulosa chiqarishni takrorlash: 2,122 tokens/s tezlik kerak bo‘lsa, NaiveRT ochiq manba kodini, Docker Compose muhitini va mos benchmark skriptlarini olib, mustaqil joylashtiring.
05Naive-N0.5-Flash ning asosiy afzalliklari
Juda uzun kontekst: 1M tokenlik kontekstni tabiiy ravishda qo‘llab-quvvatlaydi, butun tarmoqda to‘liq e’tibor qatlamlari mavjud emas, shu sababli uzun ketma-ketliklarni dekodlash xarajati odatiy arxitekturalarga qaraganda ancha past.
Yetakchi xulosa chiqarish tezligi: NaiveRT tizimi bilan bir oqimli dekodlash tezligi 2,122 tokens/s ga yetadi, spekulyativ dekodlash kechikishi SGLang’ga nisbatan 72.4% ga kamayadi.
Tadqiqot-ishlab chiqish qobiliyati yuqori: PaperBench 63.2, MLE-bench-30 73.7%, NanoGPT SpeedRun 73.8s natijalari bilan AI tadqiqot-ishlab chiqish baholashlarining bir nechtasida shu darajadagi modellardan ustun.
AI-native tadqiqot-ishlab chiqish: model arxitektura dizayni va tizim optimallashtirishda AI ishtirokida yaratilgan bo‘lib, inson maqsadlarni belgilaydigan, AI esa iteratsiyalarni bajaradigan “AI tadqiqot olib boradigan AI” paradigmasini amalda namoyon etadi.
Avtonom ilmiy tadqiqot salohiyati: maqsad va budjet berilganda tadqiqotni boshidan oxirigacha mustaqil yakunlay oladi, 400 soat ichida AutoWM dunyo modelini o‘qitib, WorldArena’da birinchi o‘ringa chiqdi.
06Naive-N0.5-Flash loyihasi manzillari
Loyiha rasmiy sayti: https://naive.ai/en/research/
GitHub ombori: https://github.com/NaiveAI-Labs/Naive-N0.5-Flash
HuggingFace model ombori: https://huggingface.co/NaiveAI/Naive-N0.5-Flash
07Naive-N0.5-Flash ning qo‘llanilish senariylari
AI tadqiqot-ishlab chiqish yordamchisi: tadqiqotchilarga maqolalarni o‘qish, usullarni takrorlash, tajribalarni ishga tushirish va natijalarni tahlil qilishda yordam beradi, masalan, PaperBench va MLE-bench turidagi tadqiqot-ishlab chiqish vazifalarida.
Uzoq davom etadigan dasturiy muhandislik: tabiiy 1M kontekst yordamida katta kod omborlarini qayta ishlaydi, fayllararo tushunish, xatolarni tuzatish va ombor darajasida kod yaratishni bajaradi.
Uzoq kontekstli Agent vazifalari: terminal bilan ishlash, vositalarni ko‘p marta chaqirish kabi uzoq interaktiv senariylarda vazifalar tarixini to‘liq saqlaydi.
RL o‘qitish infratuzilmasi: NaiveRT’ning yuqori bir oqimli dekodlash tezligi va bitma-bit deterministik tanlash mexanizmi bilan uzoq davom etadigan mustahkamlovchi o‘qitish rollout’larini tezlashtiradi hamda ortda qoluvchi namunalar sonini kamaytiradi.
© Ogohlantirish: domenlar va havola qilingan kontent vaqt o‘tishi bilan o‘zgarishi mumkin. AIEZZ uchinchi tomon veb-saytlarini nazorat qilmaydi. Tashqi kontent va xatarlarni mustaqil ravishda ko‘rib chiqing.
Foydalanuvchi sharhlari0