
- Oylik tashriflar
- 0
- Narxlar
- Belgilanmagan
- Ro‘yxatga kiritilgan
- —
- Yangilangan
- 2026-10-16
01MiDashengLM-Spatial nima?
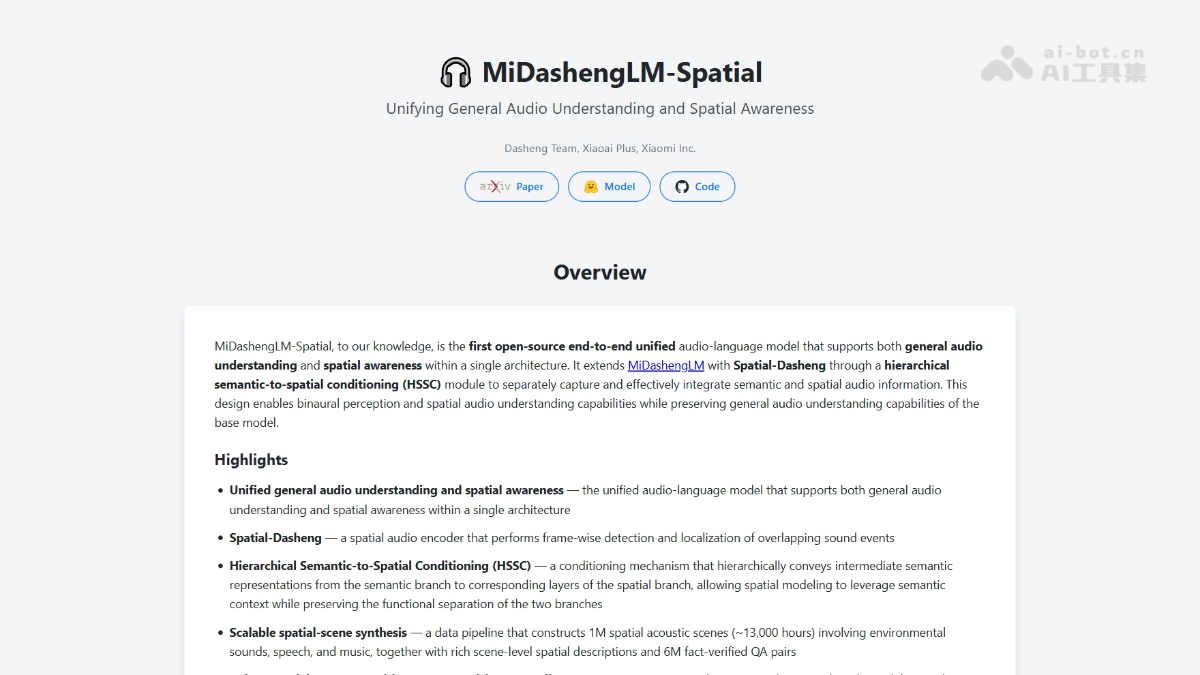
MiDashengLM-Spatial — Xiaomi kompaniyasining Dasheng jamoasi tomonidan ochiq kodda taqdim etilgan fazoviy audio tushunish uchun katta model bo‘lib, sanoatda yagona arxitektura doirasida umumiy audio tushunish va fazoviy idrokni birlashtirgan ilk end-to-end modeldir. MiDashengLM-Spatial MiDashengLM-7B asosida qurilgan bo‘lib, unga Spatial-Dasheng kodlagichi va ierarxik semantikadan fazoviy shartlarga o‘tish moduli qo‘shilgan. U tovush manbalarining yo‘nalishi, harakat trayektoriyasi hamda bir nechta tovush manbalari o‘rtasidagi makon-vaqt munosabatlarini anglaydi va ustma-ust tushgan tovush manbalarini har bir kadr bo‘yicha joylashuvini aniqlashni qo‘llab-quvvatlaydi. 1M ta fazoviy sahna va 6M ta QA o‘quv ma’lumoti bilan ta’minlangan hamda Apache 2.0 litsenziyasi ostida chiqarilgan loyiha aqlli uylar va avtomobil kabinalarida qo‘llanadi.
02MiDashengLM-Spatial asosiy funksiyalari
Tovush manbasini aniqlash: tovush chapdan, o‘ngdan yoki to‘g‘ridan-to‘g‘ri old tomondan kelayotganini aniqlaydi.
Harakat trayektoriyasini anglash: tovush manbasining fazoda qaysi yo‘nalishda va qanday yo‘l bo‘ylab harakatlanayotganini anglaydi.
Guruhlarning makon-vaqt munosabatlarini tahlil qilish: bir nechta tovush manbalari o‘rtasidagi nisbiy fazoviy joylashuvni, masalan, qaysi biri chaproqda ekanini yoki bir tomonda joylashgan-joylashmaganini aniqlaydi.
Fazoviy mazmunni tushunish: “nima eshitildi” va “tovush qayerdan keldi” ma’lumotlarini birlashtirib, masalan, qaysi suhbatdosh avval buyurtma berganini aniqlash kabi savollarga javob beradi.
Fazoviy audio tavsifi: sahnadagi barcha tovush manbalarining joylashuvi, harakati va vaqt bo‘yicha munosabatlarini to‘liq, ochiq shaklda tavsiflaydi.
Fazoviy nutqni matnga aylantirish: mazmunni suhbatdoshlar gapirish tartibida matnga aylantiradi va har bir suhbatdoshning yo‘nalishini belgilaydi.
03MiDashengLM-Spatial texnik prinsiplari
WeChat’da kuzatib, “ochiq kod” deb javob yuboring va AI ochiq kodli loyihalar guruhiga qo‘shiling
Yagona ikki tarmoqli arxitektura: model MiDashengLM-7B asosida qurilgan va Spatial-Dasheng fazoviy audio kodlagichi bilan kengaytirilgan. Natijada semantik va fazoviy tarmoqlar parallel ishlaydi: biri mazmunni tushunish, ikkinchisi esa yo‘nalishni anglash uchun javob beradi. Shu tariqa bitta modelda umumiy audio tushunish va fazoviy idrok bir vaqtda amalga oshiriladi.
Spatial-Dasheng kodlagichi: binaural kirish asosida ustma-ust tushgan tovush manbalarini har bir kadr bo‘yicha aniqlaydi va joylashtiradi, ITD/ILD kabi binaural belgilarni ushlab, tovush manbasining yo‘nalishi va harakat trayektoriyasini nozik darajada fazoviy modellashtiradi.
Ierarxik semantikadan fazoviy shartlarga o‘tish (HSSC): semantik tarmoqning oraliq qatlamlaridagi tasvirlarni bosqichma-bosqich fazoviy tarmoqning mos qatlamlariga uzatuvchi shartlash mexanizmi. Bu fazoviy modellashtirishga semantik kontekstdan foydalanish imkonini beradi, shu bilan birga ikkala tarmoqning funksional mustaqilligini saqlaydi.
Kengaytiriladigan fazoviy sahna ma’lumotlari quvuri: simulyatsiya orqali 1 millionta fazoviy akustik sahna yaratiladi. Ular atrof-muhit tovushlari, nutq va musiqani qamrab oladi hamda sahna darajasidagi fazoviy tavsiflar va 6 millionta faktni tekshiruvchi QA juftligi avtomatik yaratiladi. Bu fazoviy qobiliyatlarni keng miqyosda o‘qitishni ta’minlaydi.
Sim-to-Real umumlashuvi: sintetik ma’lumotlarda o‘qitilgan model haqiqiy binaural yozuvlarda barqaror fazoviy idrok qobiliyatini namoyish etadi. Fazoviy qobiliyatga ega bo‘lish bilan birga, asosiy modelning umumiy audio tushunish samaradorligi pasaymaydi.
04MiDashengLM-Spatial’dan qanday foydalanish kerak
Kod omborini klonlang: git clone https://github.com/xiaomi-research/midashenglm-spatial.git.
Inferens muhitini yarating va bog‘liqliklarni o‘rnating: conda create -n midashengspatial python=3.13 -y && conda activate midashengspatial, so‘ng pip install -r requirements.txt buyrug‘ini bajaring.
Model og‘irliklarini oling: alohida yuklab olish shart emas, kod mispeech/midashenglm-spatial modelini HuggingFace’dan avtomatik yuklaydi.
Binaural audioni tayyorlang: (2, T) shaklidagi ikki kanalli haqiqiy binaural audio kiriting.
Model va protsessorni yuklang: modelni AutoModelForCausalLM va AutoProcessor yordamida trust_remote_code=True parametri bilan yuklang.
Suhbat xabarlarini tuzing: messages obyektini o‘qitish tartibiga, ya’ni “avval audio, keyin matn” ketma-ketligiga muvofiq tuzing. Masalan, audio + “Write a general audio caption describing the sound source and its spatial information.”
Inferensni bajaring: kirishni processor.apply_chat_template orqali qayta ishlagach, model.generate chaqiruvini bajaring va natijani batch_decode orqali chiqaring.
Namunaga muvofiq ishga tushiring: ombordagi example/inference.py faylida to‘g‘ridan-to‘g‘ri ishga tushiriladigan to‘liq namuna mavjud.
05MiDashengLM-Spatial’ning asosiy afzalliklari
Sanoatda birinchi: yagona arxitektura ichida umumiy audio tushunish va fazoviy idrokni bir vaqtda qo‘llab-quvvatlaydigan ilk ochiq kodli yagona audio-til modeli.
Yetakchi fazoviy idrok qobiliyati: STAR-Bench fazoviy xulosa chiqarish to‘plamida aniqlik 70.3% ga yetadi. Bu inson darajasidagi 73.7% natijaga yaqin va Gemini-3.6-Flash’ning 47.0% natijasidan ancha yuqori.
Haqiqiy va ishonchli idrok: Channel-Swap ACR 72.6% ga yetadi, bu chap va o‘ng yo‘nalishlarni aniqlash haqiqiy eshitish belgilariga asoslanishini tasdiqlaydi.
Qobiliyat yo‘qotilmaydi: bir kanalli audio savol-javob, nutqni tanish va audio tavsifi kabi umumiy mezonlarda natijalar asosiy MiDashengLM-7B modeliga deyarli teng. Fazoviy qobiliyat umumiylik hisobiga olinmaydi.
Ustma-ust tushgan tovush manbalarini tahlil qilish: Spatial-Dasheng kodlagichi ustma-ust tushgan tovush manbalarini har bir kadr bo‘yicha aniqlash va joylashtirishni qo‘llab-quvvatlaydi hamda haqiqiy sahnalarda bir nechta odamning bir vaqtda gapirishi kabi murakkab holatlarni qayta ishlay oladi.
06MiDashengLM-Spatial loyihasi manzillari
Loyiha rasmiy sayti: https://jinbo-hu.github.io/midashenglm-spatial-demo/
GitHub ombori: https://github.com/xiaomi-research/midashenglm-spatial
HuggingFace model ombori: https://huggingface.co/mispeech/midashenglm-spatial
arXiv texnik maqolasi: https://arxiv.org/pdf/2610.11156
07MiDashengLM-Spatial qo‘llanilish sohalari
Aqlli kabina bilan o‘zaro aloqa: avtomobil ichidagi qaysi o‘rindiqda o‘tirgan yo‘lovchi gapirayotganini aniqlab, zonal nutqni tanish va buyruqlarni bajarishni ta’minlaydi.
Aqlli uy akustik idroki: kolonka yoki uy qurilmalari orqali uydagi tovushlarning yo‘nalishi va harakatini anglaydi.
AR/VR fazoviy audiosi: virtual dunyo uchun eshitish darajasida fazoviy tushunishni ta’minlab, tovush manbasini aniqlash, fazoviy tavsif yaratish va immersiv o‘zaro aloqani amalga oshiradi.
Eshitish vositalari va imkoniyati cheklanganlar uchun qurilmalar: eshitishida nuqsoni bo‘lgan odamlarga tovush qaysi yo‘nalishdan kelayotganini anglashda yordam beradi, atrof-muhitni idrok etish va harakatlanish xavfsizligini oshiradi.
© Ogohlantirish: domenlar va havola qilingan kontent vaqt o‘tishi bilan o‘zgarishi mumkin. AIEZZ uchinchi tomon veb-saytlarini nazorat qilmaydi. Tashqi kontent va xatarlarni mustaqil ravishda ko‘rib chiqing.
Foydalanuvchi sharhlari0