
- Lượt truy cập hàng tháng
- 0
- Giá
- Chưa đặt
- Được liệt kê
- —
- Đã cập nhật
- 2026-10-08
01VoxMem là gì
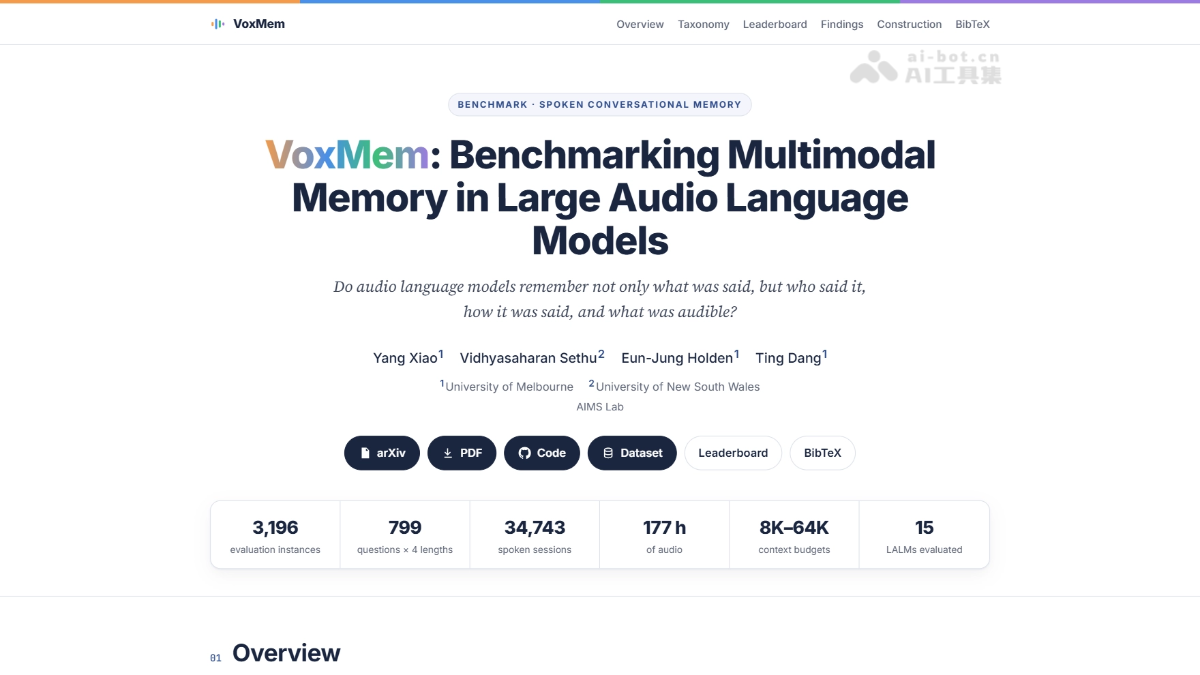
VoxMem là bộ tiêu chuẩn đánh giá bộ nhớ cho mô hình âm thanh lớn do các nhóm nghiên cứu tại Đại học Melbourne và Đại học New South Wales phát triển. Lần đầu tiên bao phủ 4 loại bằng chứng âm học: ngữ nghĩa, người nói, ngữ điệu và âm thanh môi trường × 4 thao tác bộ nhớ: trích xuất, suy luận xuyên phiên, theo dõi theo thời gian và từ chối trả lời, tạo thành khung đánh giá hai chiều bao phủ lịch sử nhiều phiên từ 8K đến 64K token. Kết quả thử nghiệm trên 15 mô hình cho thấy ở mức 32K, không mô hình nào đạt độ chính xác tổng thể trên 40%. Mô hình có thể nhớ nội dung đã nói nhưng khó nhớ ai nói và nói như thế nào; chỉ kéo dài ngữ cảnh âm thanh là chưa đủ để tạo ra tương tác giọng nói bền vững.
02Các tính năng chính của VoxMem
Đánh giá bộ nhớ giọng nói đa phiên: Trong thiết lập lịch sử giọng nói kéo dài qua nhiều phiên và nhiều khoảng thời gian, hệ thống kiểm tra khả năng mô hình ngôn ngữ âm thanh lớn ghi nhớ và truy hồi nội dung hội thoại trước đó.
Bao phủ 4 loại bằng chứng âm học: Đồng thời đánh giá ngữ nghĩa lời nói, danh tính người nói, tín hiệu cận ngôn ngữ và âm thanh môi trường. Ba loại sau là thông tin “bản địa âm thanh” không thể khôi phục từ bản chép lời.
Phân loại 4 thao tác bộ nhớ: Bao gồm trích xuất thông tin, suy luận đa phiên, theo dõi diễn biến theo thời gian và từ chối trả lời khi bằng chứng không đủ; kết hợp từng đôi tạo thành 15 ô đánh giá hợp lệ.
Kiểm soát độ dài lịch sử: Cùng một câu hỏi có bằng chứng hoàn toàn không đổi ở bốn độ dài lịch sử 8K/16K/32K/64K token, chỉ bổ sung các phiên gây nhiễu, cho phép tách riêng ảnh hưởng của độ dài đối với bộ nhớ.
Hệ thống đánh giá mở: Toàn bộ mã nguồn và dữ liệu đều được công khai, cung cấp công cụ chạy, chấm điểm và Leaderboard được chuẩn hóa, hỗ trợ tái lập với mô hình API và mô hình cục bộ.
03Nguyên lý kỹ thuật của VoxMem
Theo dõi WeChat và trả lời “开源” để tham gia nhóm trao đổi dự án mã nguồn mở AI
Khung phân loại hai chiều: Thiết kế cốt lõi của VoxMem là bảng phân loại hai chiều gồm bằng chứng âm học × thao tác bộ nhớ. Bằng chứng âm học trả lời câu hỏi cần ghi nhớ điều gì, chia thông tin giọng nói thành bốn loại: ngữ nghĩa, người nói, cận ngôn ngữ và âm thanh môi trường; thao tác bộ nhớ trả lời cách sử dụng thông tin, bao gồm truy hồi thông tin từ một phiên đơn (IE), tổng hợp bằng chứng xuyên nhiều phiên (MSR), theo dõi diễn biến trạng thái theo trình tự thời gian (TET) và từ chối trả lời khi bằng chứng không đủ (AR). Tổ hợp ngữ nghĩa × IE bị cố ý loại bỏ vì suy biến thành truy hồi văn bản thuần túy. 15 ô còn lại tạo thành không gian đánh giá hoàn chỉnh, bảo đảm năng lực ghi nhớ âm thanh được khảo sát một cách có hệ thống thay vì rời rạc.
Xây dựng dữ liệu qua ba giai đoạn: Quy trình tạo dữ liệu gồm “lập kế hoạch — viết hội thoại — tổng hợp giọng nói”: trước tiên tạo kế hoạch có cấu trúc cho từng câu hỏi, quy định câu hỏi, câu trả lời, phân bố bằng chứng và các ràng buộc hợp lệ; sau đó lần lượt tạo văn bản hội thoại phía người dùng và trợ lý. Cả hai bên đều không nhắc đến người nói, ngữ điệu hay âm thanh nền để ngăn đáp án bị tiết lộ qua văn bản; cuối cùng dùng TTS để tổng hợp giọng nói, cố định chất giọng cho mỗi người dùng, đưa tín hiệu ngữ điệu vào bằng điều khiển phong cách, trộn âm thanh môi trường với tỷ lệ tín hiệu trên nhiễu 10dB, đồng thời lưu phiên bản ghép cặp đã loại bỏ manh mối cho mỗi lượt có manh mối để kiểm tra chất lượng.
Phiên gây nhiễu và kiểm soát độ dài: Mỗi lịch sử gồm các phiên bằng chứng, phiên gây nhiễu và phiên đệm. Phiên gây nhiễu có chủ đề gần với chủ đề bằng chứng nhưng giá trị khác nhau; kết hợp với một bộ phân loại chỉ xem văn bản, đạt độ chính xác chỉ 51–56%, để xác minh rằng mô hình không thể tìm đáp án chỉ bằng cách khớp chủ đề bề mặt. Về kiểm soát độ dài, lịch sử ở bốn mức độ được lồng ghép nghiêm ngặt, chỉ dùng các phiên đệm không liên quan để kéo dài lịch sử, khiến câu hỏi, câu trả lời và bằng chứng hoàn toàn giống nhau ở cả bốn mức. Vì vậy, thay đổi về độ chính xác chỉ có thể quy cho lịch sử dài hơn, loại bỏ nhiễu do độ khó câu hỏi bị trộn lẫn.
04Cách sử dụng VoxMem
Sao chép kho lưu trữ: Kéo mã nguồn từ GitHub bằng lệnh git clone https://github.com/swagshaw/voxmem rồi chuyển vào thư mục dự án.
Cài đặt phần phụ thuộc: Chạy pip install -r requirements.txt; có thể cài thêm pip install "datasets" để tự động giải mã âm thanh thành mảng.
Cấu hình khóa API: Khi đánh giá mô hình API, cài SDK tương ứng và thiết lập khóa, chẳng hạn chạy pip install openai rồi export OPENAI_API_KEY=.
Chạy kiểm thử nhanh: Trước tiên dùng python run_voxmembench.py --config 8k_speaker_information --model abstain --allow-abstention --limit 25 --out predictions_smoke.jsonl để xác minh quy trình, sau đó dùng score_voxmembench.py --judge exact-match để chấm điểm, bảo đảm tầng từ chối đạt 1.0 ở câu hỏi cần từ chối và 0.0 ở câu hỏi có thể trả lời.
Đánh giá chính thức: Chọn cấu hình, chẳng hạn bộ đầy đủ 32k hoặc tập con 32k_speaker_information, cùng mô hình mục tiêu để chạy, ví dụ python run_voxmembench.py --config 32k --model openai:gpt-4o-audio-preview --allow-abstention --out predictions_32k.jsonl; mô hình cục bộ cần dùng --adapter để chỉ định hàm thích ứng tùy chỉnh và --model-dir để trỏ đến thư mục trọng số.
Chấm điểm bằng giám khảo LLM: Chạy python score_voxmembench.py --predictions predictions_32k.jsonl --judge openai:gpt-4o-mini --out metrics_32k.json. Giám khảo chỉ xem câu hỏi, đáp án chuẩn và câu trả lời để xác định tính tương đương của đáp án mở.
05Ưu thế cốt lõi của VoxMem
Hệ thống đầu tiên bao phủ toàn diện bộ nhớ bản địa âm thanh: Vượt qua giới hạn của các bộ tiêu chuẩn hiện có vốn chỉ kiểm tra nội dung từ vựng, lần đầu tiên đưa các thông tin âm học phi văn bản như ai nói, nói như thế nào và đã nghe thấy gì vào một khung đánh giá thống nhất.
Thiết kế phân loại hai chiều chặt chẽ: Dùng 15 ô hợp lệ từ 4 loại bằng chứng âm học × 4 thao tác bộ nhớ thay cho các câu hỏi rời rạc, giúp phân tách và khảo sát toàn diện, độc lập các năng lực ghi nhớ giọng nói.
Thiết lập đa phiên gần với thực tế: Mô phỏng nhiều phiên tương tác giọng nói người và máy diễn ra theo thời gian, thay vì một đoạn độc thoại dài, để kiểm tra khả năng ghi nhớ dài hạn của mô hình đối với người nói lặp lại và cập nhật trạng thái.
Tách hoàn toàn ảnh hưởng của độ dài: Cùng một câu hỏi có bằng chứng được lồng ghép nghiêm ngặt và không đổi ở bốn độ dài lịch sử từ 8K đến 64K, lần đầu tiên tách riêng ảnh hưởng của “lịch sử dài hơn” khỏi độ khó câu hỏi và loại bằng chứng một cách rõ ràng.
Xây dựng chống rò rỉ và kiểm tra chất lượng kép: Hai bên hội thoại đều không nhắc đến manh mối âm học, có phiên bản ghép cặp để đối chiếu và kiểm tra chất lượng hai cấp nhằm loại bỏ câu hỏi có thể trả lời chỉ bằng bản chép lời, bảo đảm câu hỏi thực sự cần “nghe” thay vì “đọc”.
Thiết kế gây nhiễu khó bị khai thác: Các phiên gây nhiễu có chủ đề gần nhưng giá trị khác nhau, kết hợp với bộ phân loại văn bản chỉ đạt độ chính xác 51–56%, ngăn chặn lối tắt tìm đáp án bằng cách khớp từ khóa.
06Địa chỉ dự án VoxMem
Trang web dự án: https://swagshaw.github.io/voxmem/
Kho GitHub: https://github.com/swagshaw/voxmem
Kho mô hình HuggingFace: https://huggingface.co/datasets/AudioMemory/voxmembench
Bài báo kỹ thuật arXiv: https://arxiv.org/pdf/2609.32607
07Các kịch bản ứng dụng của VoxMem
Lựa chọn năng lực ghi nhớ dài hạn cho trợ lý giọng nói/loa thông minh: Nhà cung cấp có thể dùng VoxMem để kiểm tra thống nhất liệu mô hình ứng viên có thể ghi nhớ xuyên phiên sở thích của người dùng, giọng nói của thành viên gia đình và những lời hứa trước đó hay không, tránh tình trạng “vừa nói tuần trước đã quên ngay” sau khi ra mắt.
Đánh giá tương tác giọng nói trên xe và thiết bị đeo: Âm thanh môi trường trong xe thường ồn, ngữ điệu người dùng thay đổi; các chiều âm thanh môi trường và tín hiệu cận ngôn ngữ của VoxMem có thể kiểm tra độ tin cậy của bộ nhớ mô hình trong điều kiện nhiễu thực tế.
Kiểm tra chất lượng hệ thống chăm sóc khách hàng và hội họp có nhiều người nói: Các kịch bản như trung tâm chăm sóc khách hàng và biên bản họp cần gắn đúng “câu nào do ai nói”. Lỗi gán người nói của VoxMem có thể được dùng trực tiếp để chẩn đoán vấn đề “nhớ nhầm người nói” của các hệ thống này.
Kiểm chứng bộ nhớ cảm xúc cho robot đồng hành/sản phẩm chăm sóc người cao tuổi: Những điều người cao tuổi nói trong tiếng thở dài tuần trước và sự mệt mỏi thể hiện qua giọng điệu chỉ có thể được truyền tải bằng tín hiệu cận ngôn ngữ. Chiều theo dõi theo thời gian của VoxMem có thể kiểm tra liệu sản phẩm có nhận biết được trạng thái thay đổi theo thời gian hay không.
© Tuyên bố miễn trừ trách nhiệm: tên miền và nội dung được liên kết có thể thay đổi theo thời gian. AIEZZ không kiểm soát các trang web của bên thứ ba. Hãy tự đánh giá nội dung bên ngoài và các rủi ro liên quan.
Đánh giá của người dùng0