
- Lượt truy cập hàng tháng
- 0
- Giá
- Chưa đặt
- Được liệt kê
- —
- Đã cập nhật
- 2026-10-09
01Naive-N0.5-Flash là gì
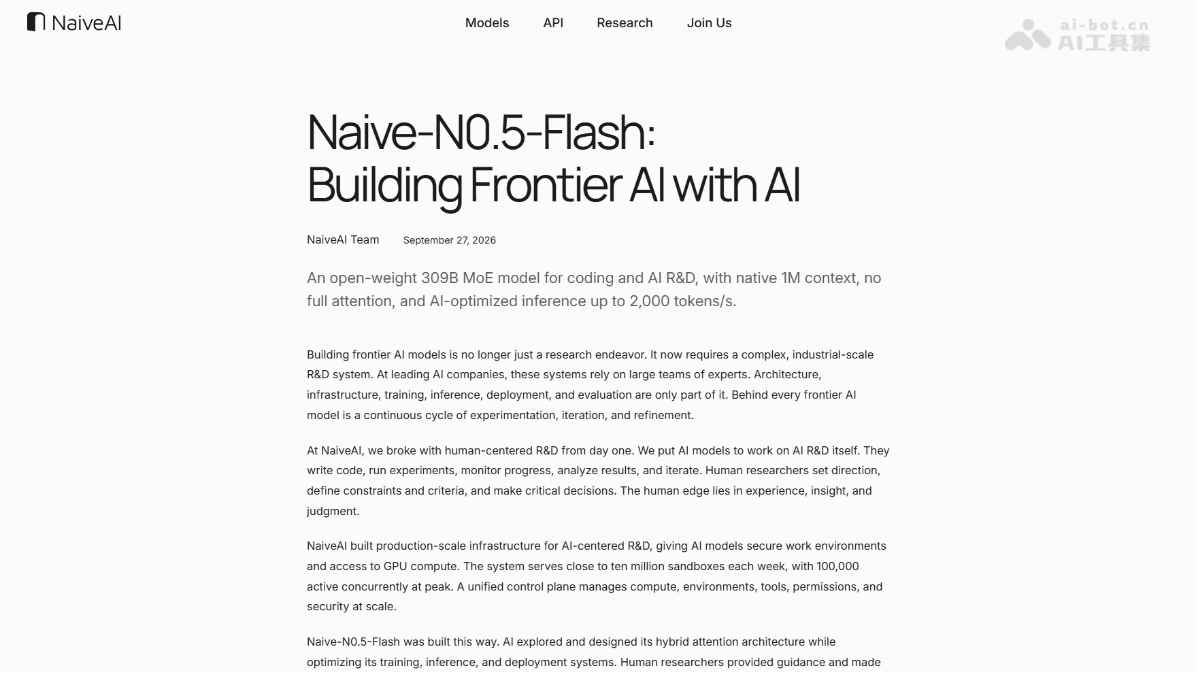
Naive-N0.5-Flash là mô hình ngôn ngữ lớn MoE đầu tiên do NaiveAI phát hành mã nguồn mở, hướng đến các kịch bản lập trình và nghiên cứu phát triển AI. Naive-N0.5-Flash được cải tiến dựa trên mô hình nền tảng MiMo-V2.5 của Xiaomi, sử dụng kiến trúc MoE 309B, áp dụng cơ chế chú ý thưa kết hợp SWA+DSA, hỗ trợ nguyên bản ngữ cảnh 1M mà không có lớp chú ý toàn cục. Mô hình được AI tham gia sâu vào quá trình nghiên cứu và phát triển, cùng hệ thống suy luận NaiveRT đạt đỉnh 2122 tokens/s khi giải mã một luồng.
02Các chức năng chính của Naive-N0.5-Flash
Lập trình với ngữ cảnh dài: hỗ trợ nguyên bản ngữ cảnh 1M token, có thể xử lý các kho mã nguồn cực lớn và những tác vụ kỹ thuật phần mềm dài hạn.
Hỗ trợ nghiên cứu và phát triển AI: có thể đọc bài báo, tái hiện phương pháp, chạy thí nghiệm, phân tích kết quả và trực tiếp tham gia toàn bộ quy trình nghiên cứu mô hình.
Tăng tốc suy luận: đi kèm hệ thống suy luận NaiveRT, đạt 50 tokens/s ở chế độ tiêu chuẩn và đỉnh 2,122 tokens/s khi giải mã một luồng ở chế độ tốc độ cao.
Nghiên cứu tự chủ: sau khi được cung cấp mục tiêu, ngân sách tính toán và giao thức đánh giá, có thể tự chủ thúc đẩy nghiên cứu từ đầu đến cuối.
03Nguyên lý kỹ thuật của Naive-N0.5-Flash
Theo dõi WeChat và trả lời “开源” để tham gia nhóm trao đổi dự án mã nguồn mở AI
Cơ chế chú ý thưa kết hợp SWA–DSA: mô hình dựa trên mô hình nền tảng MiMo-V2.5, thay thế các lớp chú ý toàn cục có chi phí lớn bằng cơ chế chú ý thưa của DeepSeek, xếp chồng xen kẽ với chú ý cửa sổ trượt theo tỷ lệ 5:1; toàn bộ mạng không có bất kỳ lớp chú ý toàn cục nào. SWA xử lý cửa sổ cục bộ 128 token, còn DSA sử dụng bộ lập chỉ mục nhẹ để chấm điểm toàn bộ lịch sử và chọn ra top-2048 token cho mạng chính tính toán.
Thiết kế bộ lập chỉ mục nhẹ: thay MLA nguyên bản của DSA bằng GQA, giảm số đầu truy vấn của bộ lập chỉ mục từ 64 xuống 16, giúp giảm 44% thời gian của đường dẫn lựa chọn chỉ mục, đồng thời duy trì hiệu năng không suy giảm trên các tác vụ Agent với ngữ cảnh 1M.
Quy trình huấn luyện ba giai đoạn: trước tiên đóng băng mạng chính trên 50B token, sử dụng hàm mất mát KL để căn chỉnh phân phối của bộ lập chỉ mục với phân phối chú ý toàn cục; sau đó chuyển sang chú ý thưa để tiếp tục tiền huấn luyện 3T token, thích ứng với cơ chế lựa chọn thông tin mới và tăng cường năng lực lập trình, nghiên cứu phát triển; cuối cùng tinh chỉnh có giám sát trên 200B token và giảm dần tốc độ học. Duy trì ngữ cảnh 1M trong toàn bộ quá trình, AI tự động hoàn thành phân tích truy hồi top-k và khắc phục độ ổn định số.
Song song hóa chuỗi kết hợp và tối ưu bộ nhớ GPU: trước sự khác biệt giữa SWA chỉ cần cửa sổ cục bộ còn DSA cần toàn bộ lịch sử, lần lượt áp dụng song song hóa chuỗi Halo; ở phía bộ nhớ GPU, tinh chỉnh cấp độ dỡ tải activation đến cấp toán tử, giữ lại rõ ràng chỉ mục top-k để tránh việc tính toán lại làm thay đổi lựa chọn, 512 GPU có thể huấn luyện 1T token trong khoảng 4 ngày.
Tối ưu suy luận NaiveRT: thông qua hợp nhất toán tử quy mô lớn, sử dụng PDL để thực thi chồng lấp các kernel ở luồng trên và luồng dưới, đồng thời đẩy hoàn toàn vòng lặp giải mã suy đoán lên GPU, giảm độ trễ giải mã mỗi vòng từ 12.3ms xuống 3.4ms; đồng thời hỗ trợ lấy mẫu xác định từng bit theo seed ngẫu nhiên, bảo đảm mẫu lấy trong quá trình huấn luyện RL nhất quán với logprob huấn luyện. Mọi tối ưu đều lấy đường dẫn mô hình thực tế đầu cuối làm tiêu chuẩn chấp nhận.
04Cách sử dụng Naive-N0.5-Flash
Xác nhận phần cứng: cần GPU NVIDIA hỗ trợ FP8, trọng số mô hình khoảng 315GB và cần dự phòng thêm bộ nhớ GPU.
Lấy trọng số: tải kho NaiveAI/Naive-N0.5-Flash-FP8 từ Hugging Face.
Cài đặt phụ thuộc: thực thi pip install "transformers[torch,kernels]>=5.17.0".
Tải mô hình: sử dụng AutoTokenizer và AutoModelForCausalLM với trust_remote_code=True, device_map="auto" để tải mô hình.
Tạo đầu vào: truyền các tin nhắn hội thoại qua apply_chat_template để tạo tensor đầu vào.
Tạo kết quả: gọi model.generate() để tạo phản hồi, sau đó dùng tokenizer.decode() để giải mã đầu ra.
Thiết lập tham số: trong các kịch bản thông thường, khuyến nghị temperature=1.0 và top_p=0.95.
Tái hiện suy luận hiệu năng cao: nếu cần tốc độ 2,122 tokens/s, có thể lấy mã nguồn mở NaiveRT, môi trường Docker Compose và các script benchmark đi kèm để tự triển khai.
05Ưu thế cốt lõi của Naive-N0.5-Flash
Ngữ cảnh cực dài: hỗ trợ nguyên bản ngữ cảnh 1M token và toàn bộ mạng không có lớp chú ý toàn cục, nên chi phí giải mã chuỗi dài thấp hơn nhiều so với kiến trúc thông thường.
Tốc độ suy luận hàng đầu: hệ thống NaiveRT đi kèm đạt đỉnh 2,122 tokens/s khi giải mã một luồng, độ trễ giải mã suy đoán giảm 72.4% so với SGLang.
Năng lực nghiên cứu và phát triển nổi bật: PaperBench 63.2, MLE-bench-30 73.7%, NanoGPT SpeedRun 73.8s, vượt qua các mô hình cùng cấp trong nhiều bài đánh giá nghiên cứu và phát triển AI.
Nghiên cứu và phát triển AI nguyên bản: mô hình có AI tham gia thiết kế kiến trúc và tối ưu hệ thống, hiện thực hóa mô hình “AI nghiên cứu và phát triển AI”, trong đó con người đặt mục tiêu còn AI thực hiện vòng lặp cải tiến.
Tiềm năng nghiên cứu tự chủ: sau khi được cung cấp mục tiêu và ngân sách, có thể tự chủ hoàn thành nghiên cứu từ đầu đến cuối; huấn luyện AutoWM, mô hình thế giới, trong 400 giờ và đứng đầu WorldArena.
06Địa chỉ dự án Naive-N0.5-Flash
Trang web dự án: https://naive.ai/en/research/
Kho GitHub: https://github.com/NaiveAI-Labs/Naive-N0.5-Flash
Kho mô hình HuggingFace: https://huggingface.co/NaiveAI/Naive-N0.5-Flash
07Các kịch bản ứng dụng của Naive-N0.5-Flash
Trợ lý nghiên cứu và phát triển AI: hỗ trợ nhà nghiên cứu đọc bài báo, tái hiện phương pháp, chạy thí nghiệm và phân tích kết quả, chẳng hạn các tác vụ nghiên cứu và phát triển như PaperBench, MLE-bench.
Kỹ thuật phần mềm dài hạn: nhờ ngữ cảnh 1M nguyên bản, xử lý các kho mã nguồn lớn, hoàn thành việc hiểu xuyên tệp, sửa lỗi và tạo mã ở cấp kho.
Tác vụ Agent với ngữ cảnh dài: duy trì đầy đủ lịch sử tác vụ trong các kịch bản tương tác dài như thao tác trên terminal và gọi công cụ qua nhiều lượt.
Hạ tầng huấn luyện RL: kết hợp tốc độ giải mã một luồng cao và cơ chế lấy mẫu xác định từng bit của NaiveRT để tăng tốc rollout học tăng cường dài hạn và giảm số mẫu bị tụt lại.
© Tuyên bố miễn trừ trách nhiệm: tên miền và nội dung được liên kết có thể thay đổi theo thời gian. AIEZZ không kiểm soát các trang web của bên thứ ba. Hãy tự đánh giá nội dung bên ngoài và các rủi ro liên quan.
Đánh giá của người dùng0