
- Lượt truy cập hàng tháng
- 0
- Giá
- Chưa đặt
- Được liệt kê
- —
- Đã cập nhật
- 2026-10-28
01Unlimited OCR 2 là gì
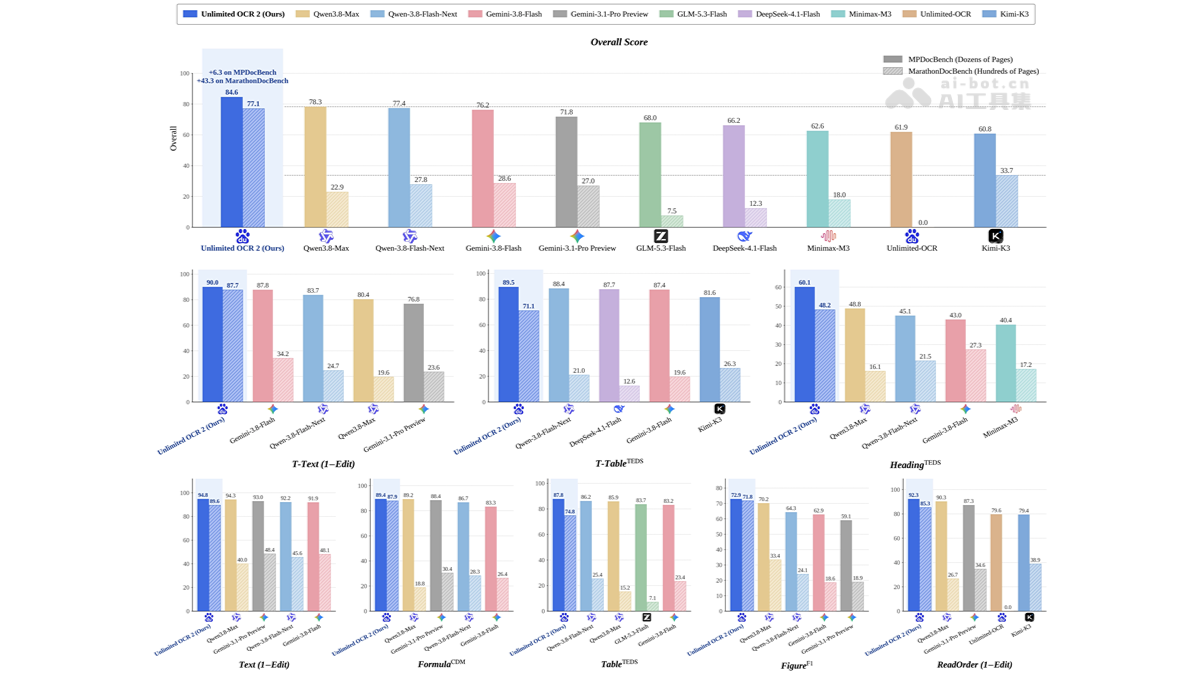
Unlimited OCR 2 là mô hình phân tích tài liệu đầu cuối do Baidu Wenxin mã nguồn mở, hỗ trợ phân tích tài liệu dài với số trang bất kỳ, có thể xử lý hàng nghìn trang sách trong một lần mà vẫn duy trì độ chính xác và hiệu suất. Unlimited OCR 2 sử dụng cơ chế chú ý cửa sổ trượt tham chiếu thưa và cơ chế giải mã vô hạn, giảm chi phí tính toán và bộ nhớ video khi xử lý tài liệu dài. Mô hình đạt SOTA trên các benchmark như MPDocBench và MarathonDocBench, thúc đẩy OCR bước vào kỷ nguyên 3.0.
02Các tính năng chính của Unlimited OCR 2
Phân tích số trang bất kỳ: Phá vỡ giới hạn số trang truyền thống, hỗ trợ xử lý tài liệu dài hàng nghìn trang trong một lần.
Hiểu tài liệu dài với độ chính xác cao: Duy trì độ chính xác phân tích và hiệu suất xử lý cao ngay cả khi độ dài tài liệu tăng đáng kể.
Liên kết thông tin giữa các trang: Có thể xem lại nội dung trước đó và đối chiếu nội dung giữa các trang, giảm đứt gãy ngữ cảnh do ghép nhiều trang.
Mã nguồn mở và sẵn sàng sử dụng: Mã nguồn và trọng số mô hình được mở, đồng thời đã được cung cấp trên Baidu Intelligent Cloud và nền tảng mở Baidu AI.
03Nguyên lý kỹ thuật của Unlimited OCR 2
Theo dõi WeChat và trả lời “开源” để tham gia nhóm trao đổi dự án AI mã nguồn mở
SR-SWA, chú ý cửa sổ trượt tham chiếu thưa: Lấy cảm hứng từ cách con người “tập trung vào trang hiện tại và xem lại nội dung trước đó khi cần” khi chép sách. Page Gate thu hẹp phạm vi tham chiếu hình ảnh của mỗi truy vấn từ toàn bộ tài liệu xuống các trang liên quan, đồng thời mô hình hóa quan hệ vị trí giữa các trang; các Visual Token Buckets có điểm số cao nhất được đưa vào để nắm bắt phụ thuộc hình ảnh ở khoảng cách xa, tránh việc Full Attention phải tính toán dư thừa số lượng lớn token trên toàn tài liệu.
Unlimited-Horizon Decoding, cơ chế giải mã vô hạn: Tối ưu quy trình giải mã để giải quyết các nút thắt về tính toán và bộ nhớ video khi phân tích tài liệu siêu dài, giúp mô hình không bị giới hạn cứng bởi độ dài ngữ cảnh khi xử lý nhiều trang hơn, hỗ trợ mục tiêu phân tích “số trang bất kỳ”.
Mô hình hóa tài liệu dài đầu cuối: Khác với OCR truyền thống, vốn nhận dạng từng trang rồi ghép lại, và cũng khác với R-SWA thế hệ trước chỉ mở rộng đến vài chục trang liên tiếp, Unlimited OCR 2 đưa việc lựa chọn giữa các trang, xem lại nội dung tham chiếu và hiểu trang hiện tại vào một khung đầu cuối thống nhất, nâng cao tính nhất quán và đầy đủ khi phân tích tài liệu dài.
Kiểm soát hiệu suất và chi phí: Tốc độ giải mã từng bước của SR-SWA cao hơn 7 lần so với Full Attention và 5.6 lần so với R-SWA thế hệ trước. Lợi ích cốt lõi đến từ việc dùng tham chiếu thưa thay cho chú ý toàn cục trên toàn bộ dữ liệu.
04Cách sử dụng Unlimited OCR 2
Chọn cách truy cập: Tải mã nguồn và trọng số từ GitHub hoặc Hugging Face để triển khai cục bộ.
Chuẩn bị tài liệu: Sắp xếp PDF/tài liệu quét/tài liệu dài, bảo đảm các trang đầy đủ, rõ ràng và đúng hướng.
Tải lên hoặc nạp tài liệu: Tải tài liệu trực tiếp qua cổng trực tuyến; khi triển khai cục bộ, cấu hình môi trường và nạp trọng số mô hình Unlimited OCR 2.
Thiết lập tác vụ: Chọn định dạng đầu ra, phạm vi phân tích, nhận dạng bảng/bố cục và các tùy chọn khác theo trang hoặc tham số API.
Chạy phân tích: Gửi tác vụ và chờ mô hình hoàn tất việc hiểu nội dung giữa các trang, trích xuất nội dung và tạo dữ liệu có cấu trúc.
Kiểm tra kết quả: Tập trung kiểm tra tiêu đề giữa các trang, bảng, công thức, số trang, trích dẫn và tính liên tục của đoạn văn.
Xuất và tích hợp: Xuất văn bản/Markdown/JSON hoặc kết nối API với quy trình xử lý hàng loạt và hệ thống nghiệp vụ.
05Ưu thế cốt lõi của Unlimited OCR 2
Phân tích số trang bất kỳ: Phá vỡ giới hạn số trang của OCR truyền thống, có thể xử lý tài liệu dài hàng nghìn trang.
Độ chính xác trên tài liệu dài ổn định hơn: Vẫn duy trì độ chính xác phân tích và hiệu suất cao khi số trang tăng đáng kể.
Hiểu nội dung giữa các trang mạnh hơn: Có thể xem lại nội dung trước đó và liên kết thông tin giữa các trang, giảm đứt gãy ngữ cảnh do ghép nội dung.
Hiệu suất tính toán cao hơn: SR-SWA dùng tham chiếu thưa thay cho chú ý toàn bộ, giảm đáng kể các phép tính dư thừa.
Chi phí bộ nhớ video thấp hơn: Kết hợp cơ chế giải mã vô hạn để giảm áp lực bộ nhớ video khi phân tích tài liệu siêu dài.
Hiệu năng benchmark dẫn đầu: Theo nội dung bài viết, mô hình đạt SOTA trên các benchmark tài liệu dài như MPDocBench và MarathonDocBench.
06Địa chỉ dự án Unlimited OCR 2
Kho GitHub: https://github.com/baidu/Unlimited-OCR
Kho mô hình HuggingFace: https://huggingface.co/spaces/baidu/Unlimited-OCR-2
07Các kịch bản ứng dụng của Unlimited OCR 2
Phân tích sách dài/tài liệu: Số hóa nhanh toàn bộ tiểu thuyết, giáo trình và sách cổ, đồng thời bảo toàn ngữ cảnh giữa các trang.
Phân tích báo cáo nghiên cứu và báo cáo tài chính: Đọc hàng trăm trang báo cáo nghiên cứu, báo cáo thường niên trong một lần, trích xuất quan điểm, chỉ số và rủi ro.
Rà soát pháp lý và tuân thủ: Xử lý tuyển tập quy định, hồ sơ hợp đồng và tài liệu vụ án, hỗ trợ liên kết các điều khoản giữa các trang.
Số hóa hồ sơ và chứng từ: Chuyển hàng loạt hồ sơ quét, bệnh án và tài liệu lịch sử thành văn bản có cấu trúc để lưu trữ.
Xây dựng RAG/cơ sở tri thức: Phân tích PDF siêu dài thành nội dung có thể tìm kiếm, phục vụ hỏi đáp, tìm kiếm và tác vụ của tác nhân thông minh.
© Tuyên bố miễn trừ trách nhiệm: tên miền và nội dung được liên kết có thể thay đổi theo thời gian. AIEZZ không kiểm soát các trang web của bên thứ ba. Hãy tự đánh giá nội dung bên ngoài và các rủi ro liên quan.
Đánh giá của người dùng0