
- Lượt truy cập hàng tháng
- 0
- Giá
- Chưa đặt
- Được liệt kê
- —
- Đã cập nhật
- 2026-11-06
01ERNIE 5.5 Flash Base là gì
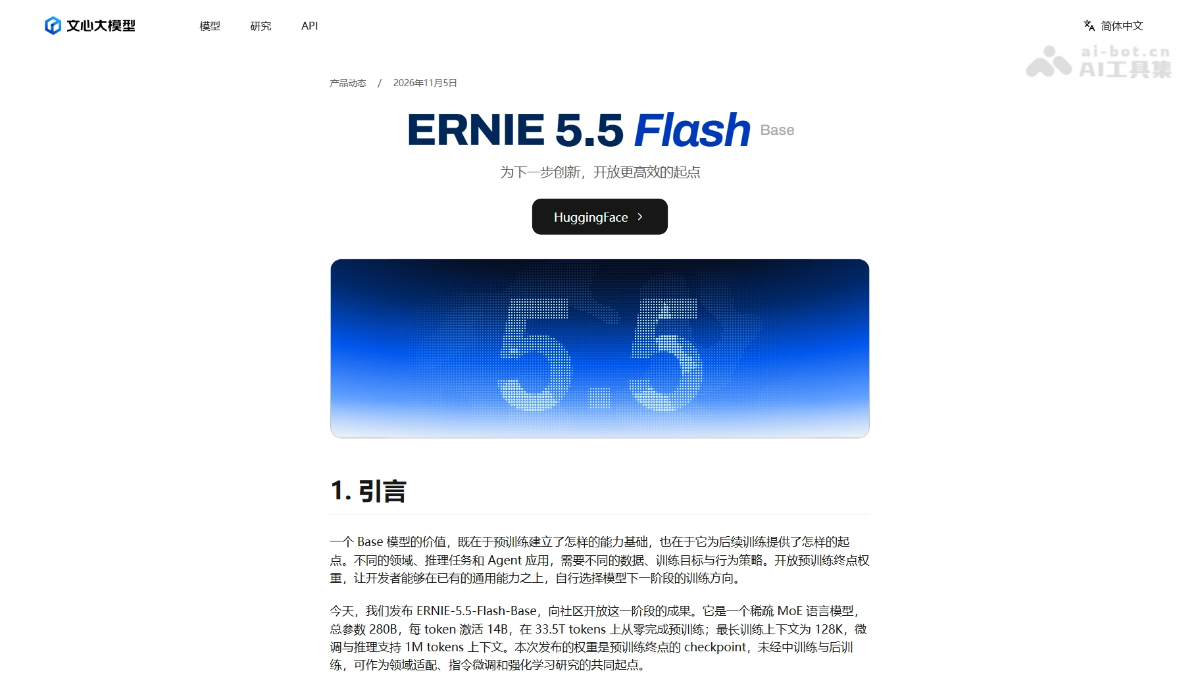
ERNIE 5.5 Flash Base là mô hình nền tảng mới nhất do Baidu mã nguồn mở, sử dụng kiến trúc MoE thưa với tổng cộng 280 tỷ tham số, kích hoạt 14 tỷ tham số mỗi token, được tiền huấn luyện trên 33,5 nghìn tỷ token và hỗ trợ ngữ cảnh 1 triệu token. ERNIE 5.5 Flash Base tập trung vào đổi mới hiệu suất: attention thưa giúp giảm chi phí xử lý văn bản dài, MoE đa bộ định tuyến tối ưu hóa việc định tuyến, còn ECHO tái sử dụng lớp cuối của mạng chính để dự đoán các token tiếp theo. Theo Baidu, mô hình đạt SOTA trong nhiều benchmark ở cùng quy mô và đã được phát hành trên HuggingFace.
02Các tính năng chính của ERNIE 5.5 Flash Base
Mô hình nền tảng văn bản hiệu năng cao: MoE thưa với tổng cộng 280 tỷ tham số, mỗi token chỉ kích hoạt 14 tỷ tham số, cung cấp năng lực xử lý văn bản tổng quát đạt SOTA ở cùng quy mô.
Ngữ cảnh siêu dài: ngữ cảnh tiền huấn luyện 128K, hỗ trợ tối đa 1 triệu token khi tinh chỉnh và suy luận.
Phủ rộng năng lực: đạt kết quả tốt nhất trong các mô hình cùng quy mô trên các benchmark về kiến thức, suy luận, toán học, lập trình, đa ngôn ngữ và ngữ cảnh dài.
Mã nguồn mở, có thể tùy chỉnh: trọng số FP8 và BF16 đã được phát hành trên HuggingFace, hỗ trợ nhà phát triển và doanh nghiệp tinh chỉnh để xây dựng mô hình chuyên biệt.
Hệ sinh thái suy luận hoàn chỉnh: Baidu cung cấp plugin vLLM chính thức, SGLang Cookbook và ví dụ tinh chỉnh Megatron-Bridge.
03Nguyên lý kỹ thuật của ERNIE 5.5 Flash Base
Theo dõi WeChat và trả lời “开源” để tham gia nhóm trao đổi dự án AI mã nguồn mở
Latent-Gated Sparse Attention: kết hợp attention nén mạnh (HCA) với attention tiềm ẩn đa đầu (MLA) thành kiến trúc phân công chuyên biệt. 37 lớp xử lý thông tin lịch sử trên chuỗi được nén 128 lần, chỉ 6 lớp phụ trách truy xuất chi tiết, qua đó giảm đáng kể chi phí KV Cache của ngữ cảnh dài; attention có cổng hạng thấp tái sử dụng low-rank query latent do chính lớp attention tạo ra để tính cổng đầu ra, giảm 75% số tham số của phép chiếu có cổng đồng thời cải thiện hiệu quả; attention đầu ảo (VHA) tăng cường khả năng biểu đạt khi huấn luyện và được hợp nhất vào toán tử attention khi suy luận, với chi phí bổ sung cực thấp.
Multi-Router Latent MoE: nhiều bộ định tuyến độc lập cùng tham gia lựa chọn chuyên gia, cải thiện tương quan giữa điểm định tuyến và hiệu dụng thực tế của chuyên gia, giảm ảnh hưởng của sai lệch từ một điểm số đơn lẻ đến việc chọn đường, đồng thời giữ nguyên số chuyên gia được kích hoạt, lượng tính toán của chuyên gia và lưu lượng giao tiếp.
Mục tiêu huấn luyện ECHO: không tăng thêm mô-đun MTP mà tái sử dụng lớp cuối của mạng chính để mô hình tự học cách dự đoán các token tiếp theo, chủ động lập kế hoạch hướng đi của chuỗi và nâng cao năng lực suy luận, lập trình; lớp được tái sử dụng có thể trực tiếp đóng vai trò mô hình bản nháp cho giải mã suy đoán. Chỉ với huấn luyện từng bước, mô hình đã thể hiện năng lực ngoại suy nhiều bước, với chất lượng bản nháp vượt xa mô-đun MTP phụ trợ.
Tối ưu hóa hệ thống huấn luyện: bộ tối ưu Muon phân tán hợp nhất việc giao tiếp liên máy giữa tham số Dense và MoE thành một lần giao tiếp tập hợp, kết hợp độ chính xác hỗn hợp FP8 để nâng cao hiệu quả huấn luyện quy mô lớn; toán tử attention FlashMask-4 do Baidu tự phát triển dựa trên CuTe-DSL, hỗ trợ kiến trúc SM90/SM100 và head dim tối đa 576, tương thích trực tiếp với phép tính đầu rộng của lớp HCA.
04Cách sử dụng ERNIE 5.5 Flash Base
Chuẩn bị môi trường phần cứng: mô hình có tổng cộng 280 tỷ tham số; ngay cả trọng số lượng tử hóa FP8 cũng chiếm khoảng 280GB. Cần chuẩn bị máy chủ GPU cao cấp nhiều card, chẳng hạn dòng H với kiến trúc SM90/SM100; một card đơn không thể đáp ứng.
Tải trọng số mô hình: kéo kho chính thức từ HuggingFace, chọn bản FP8 (baidu/ERNIE-5.5-Flash-Base) hoặc BF16 tùy nhu cầu, ví dụ lệnh huggingface-cli download baidu/ERNIE-5.5-Flash-Base --local-dir ./ernie-base.
Cài đặt framework suy luận: triển khai plugin vLLM chính thức của Baidu (baidu/vLLM-ERNIE) để tương thích với kiến trúc attention thưa, hoặc sử dụng SGLang Cookbook do Baidu cung cấp.
Khởi chạy dịch vụ suy luận: chạy vllm serve trỏ đến đường dẫn trọng số cục bộ, thiết lập --tensor-parallel-size theo số card và bật --enable-expert-parallel. Sau khi khởi động, dịch vụ sẽ cung cấp giao diện tương thích với OpenAI.
Gửi yêu cầu: gửi yêu cầu đến cổng cục bộ theo định dạng OpenAI API tiêu chuẩn; có thể cấu hình ngữ cảnh tối đa 1 triệu token, điều chỉnh --max-model-len theo VRAM.
Tinh chỉnh tùy chỉnh: dựa trên ví dụ Megatron-Bridge chính thức để tiếp tục tiền huấn luyện theo lĩnh vực hoặc thực hiện SFT.
05Ưu thế cốt lõi của ERNIE 5.5 Flash Base
Hiệu suất suy luận vượt trội: kiến trúc MoE thưa với tổng cộng 280 tỷ tham số chỉ kích hoạt 14 tỷ tham số mỗi token, tận dụng dung lượng mô hình cực lớn với chi phí tính toán rất thấp.
Khả năng xử lý ngữ cảnh siêu dài: ngữ cảnh tiền huấn luyện 128K, hỗ trợ tối đa 1 triệu token khi tinh chỉnh và suy luận, giúp giảm đáng kể tài nguyên cần thiết để xử lý văn bản dài.
Hiệu năng mạnh nhất trong cùng quy mô: theo đánh giá chính thức, mô hình đạt SOTA trong cùng quy mô trên 30 benchmark về kiến thức, suy luận, toán học, lập trình, đa ngôn ngữ và ngữ cảnh dài.
Đổi mới hiệu suất có hệ thống: attention thưa Latent-Gated, MoE đa bộ định tuyến và mục tiêu huấn luyện ECHO phối hợp tối ưu từ ba khâu attention, định tuyến và mục tiêu huấn luyện.
Nền tảng kỹ thuật hoàn thiện: bộ tối ưu Muon phân tán, độ chính xác hỗn hợp FP8 và toán tử FlashMask-4 tự phát triển bảo đảm hiệu quả huấn luyện và suy luận quy mô lớn.
06Địa chỉ dự án ERNIE 5.5 Flash Base
Trang web dự án: https://ernie.baidu.com/zh/release/ernie-5-5-flash-base/
Kho mô hình HuggingFace: https://huggingface.co/baidu/ERNIE-5.5-Flash-Base
07Các kịch bản ứng dụng của ERNIE 5.5 Flash Base
Xử lý chuyên sâu tài liệu dài: nhờ ngữ cảnh tối đa 1 triệu token, mô hình có thể xử lý toàn bộ hợp đồng pháp lý, báo cáo tài chính, tuyển tập bài nghiên cứu hoặc kho mã trong một lần, thực hiện tóm tắt toàn văn, hỏi đáp xuyên chương và trích xuất thông tin.
Hỗ trợ nghiên cứu và phát triển phần mềm: với năng lực lập trình nổi bật và ngữ cảnh siêu dài, mô hình có thể hiểu cấu trúc toàn bộ kho mã để sinh mã, đưa ra đề xuất tái cấu trúc và phân tích lỗi xuyên tệp.
Tùy chỉnh mô hình theo lĩnh vực: là mô hình nền tảng mã nguồn mở chưa qua hậu huấn luyện, mô hình có thể được doanh nghiệp tinh chỉnh trên dữ liệu ngành của mình để xây dựng các mô hình chuyên biệt cho pháp luật, tài chính, y tế và các lĩnh vực khác.
Xử lý nội dung đa ngôn ngữ: năng lực đa ngôn ngữ đạt SOTA ở cùng quy mô, phù hợp với dịch tài liệu đa ngôn ngữ, kiểm duyệt nội dung quốc tế hóa và hỏi đáp trên kho tri thức toàn cầu.
© Tuyên bố miễn trừ trách nhiệm: tên miền và nội dung được liên kết có thể thay đổi theo thời gian. AIEZZ không kiểm soát các trang web của bên thứ ba. Hãy tự đánh giá nội dung bên ngoài và các rủi ro liên quan.
Đánh giá của người dùng0