
- Lượt truy cập hàng tháng
- 0
- Giá
- Chưa đặt
- Được liệt kê
- —
- Đã cập nhật
- 2026-09-28
01Kev là gì
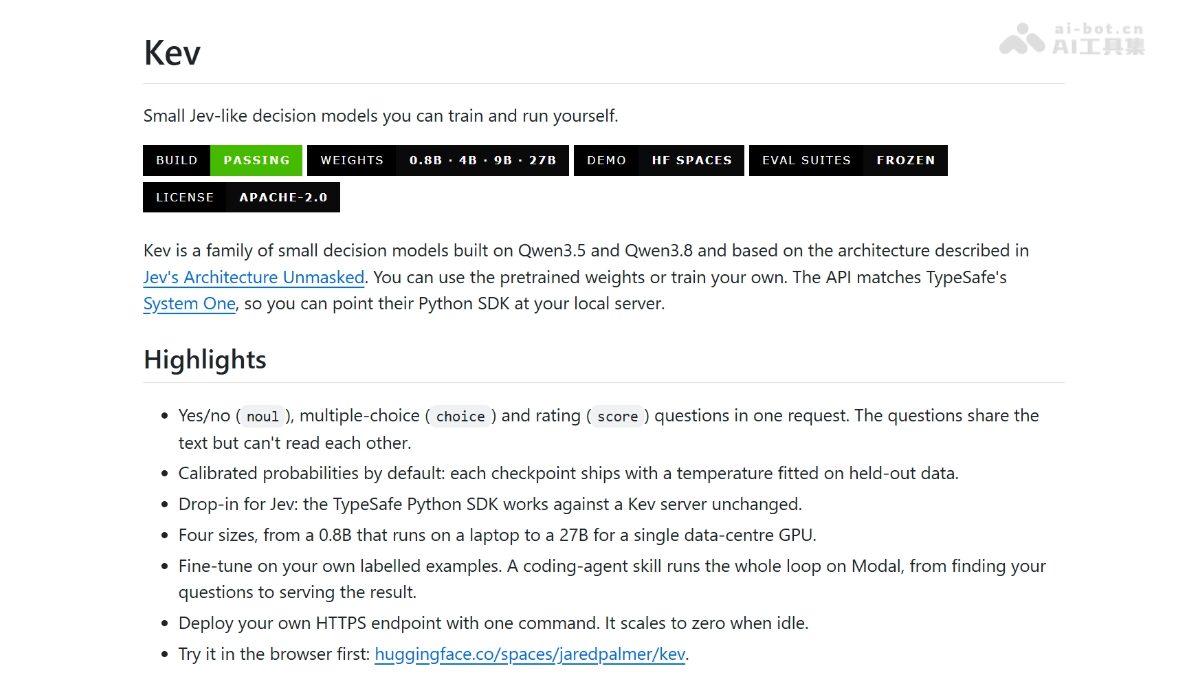
Kev là họ mô hình ra quyết định do Jared Palmer, Phó Chủ tịch Kỹ thuật của Cognition, phát hành mã nguồn mở. Kev dựa trên Qwen3.5/Qwen3.8, cung cấp nhiều kích thước mô hình từ 0.8B đến 27B. Kev không tạo văn bản mà nhận văn bản trạng thái cùng các câu hỏi có cấu trúc, sau một lượt suy luận trực tiếp xuất ra xác suất đã hiệu chuẩn. Kev hỗ trợ ba loại quyết định: có/không, định tuyến theo lựa chọn và chấm điểm theo cấp độ, đồng thời tương thích API với TypeSafe System One.
02Các tính năng chính của Kev
Ra quyết định có cấu trúc: nhập một đoạn văn bản trạng thái cùng một số câu hỏi có cấu trúc, một yêu cầu sẽ trực tiếp trả về xác suất đã hiệu chuẩn của từng lựa chọn và không bao giờ tạo văn bản giải thích.
Ba nguyên thủy quyết định: hỗ trợ noul, choice và score.
Cô lập câu hỏi hàng loạt: nhiều câu hỏi dùng chung một trạng thái đầu vào, được cô lập với nhau bằng mặt nạ chú ý. Một lượt suy luận đồng thời trả lời mọi câu hỏi mà không gây nhiễm chéo.
Triển khai cục bộ: cung cấp lệnh một dòng kev.serve để khởi chạy dịch vụ, mở endpoint POST /v1/systemone, tương thích với CUDA, ROCm và Apple Silicon (MLX).
Tinh chỉnh chi phí thấp: hỗ trợ tiếp tục huấn luyện trên checkpoint chính thức bằng dữ liệu gán nhãn riêng. Kỹ năng kev-finetune giúp coding agent tự động hoàn tất toàn bộ quy trình chuẩn bị dữ liệu, huấn luyện, đánh giá và triển khai.
Hệ thống đánh giá tích hợp: có sẵn tập đánh giá cố định, báo cáo độ chính xác, điểm Brier, sai số hiệu chuẩn và tỷ lệ quyết định có thể tự động hóa; CI cũng tự động kiểm tra các số liệu phát hành.
03Nguyên lý kỹ thuật của Kev
Theo dõi WeChat và trả lời “开源” để tham gia nhóm trao đổi dự án AI mã nguồn mở
Đầu chỉ mục biến sinh văn bản thành phân loại: Kev đóng băng trọng số nền Qwen, đồng thời gắn thêm một bộ điều hợp LoRA rank-16 và đầu chỉ mục. Trạng thái ẩn của mỗi lựa chọn được chấm điểm cùng trạng thái ẩn của câu hỏi, sau đó đưa qua softmax để thu được xác suất. Về bản chất, phương pháp này biến “câu hỏi viết” của mô hình lớn thành “câu hỏi trắc nghiệm”, bỏ qua quá trình sinh từng token.
Cơ chế chú ý nhân quả theo khối để cô lập câu hỏi: chuỗi đầu vào được tổ chức thành “trạng thái + nhiều khối câu hỏi”. Mặt nạ chú ý cho phép mỗi token chỉ đọc trạng thái và phần nội bộ của câu hỏi hiện tại. ID vị trí được đếm lại tại mỗi câu hỏi, nhờ đó một lượt suy luận có thể đồng thời trả lời nhiều câu hỏi không liên quan, dùng chung phép tính trạng thái mà không làm rò rỉ thông tin lẫn nhau. Với các mô hình kết hợp Gated DeltaNet như Qwen3.5/3.8, mỗi câu hỏi được đặt trên một hàng riêng và tái sử dụng bộ nhớ đệm KV của trạng thái, giúp việc cô lập nghiêm ngặt hơn.
Huấn luyện và hiệu chuẩn: dùng cross-entropy để huấn luyện adapter và đầu chỉ mục trên nhãn đúng, trong khi nền tảng được đóng băng hoàn toàn. Mỗi checkpoint sẽ khớp một tham số nhiệt độ trên dữ liệu giữ lại; khi suy luận, mô hình trực tiếp xuất ra xác suất sau hiệu chuẩn. Tham số nhiệt độ không thay đổi thứ hạng mà chỉ hiệu chuẩn giá trị độ tin cậy.
04Cách sử dụng Kev
Chuẩn bị môi trường: cài đặt Python 3.12/3.13 và uv, sau đó sao chép kho mã và chạy uv sync --extra serve để cài đặt các phần phụ thuộc.
Khởi chạy dịch vụ cục bộ: chạy KEV_DTYPE=bf16 uv run --extra serve python -m kev.serve --run jaredpalmer/kev-4b --port 8009 để khởi động mô hình; lần chạy đầu tiên sẽ tự động tải trọng số.
Gửi yêu cầu quyết định: gửi state dạng văn bản và questions tới POST /v1/systemone để nhận xác suất đã hiệu chuẩn của từng lựa chọn.
Gọi bằng Python SDK: dùng SDK chính thức của TypeSafe, trỏ base_url tới dịch vụ cục bộ; các ứng dụng Jev hiện có có thể chuyển đổi mà không cần sửa mã.
Dùng thử trên trình duyệt: truy cập Hugging Face Space hoặc chạy playground cục bộ để trải nghiệm mà không cần cài đặt.
Tinh chỉnh dữ liệu riêng: chuẩn bị dữ liệu gán nhãn ở định dạng JSONL, sau đó dùng uv run python -m kev.train --init_from jaredpalmer/kev-4b ... để tiếp tục huấn luyện dựa trên checkpoint chính thức.
Tinh chỉnh tự động bằng Agent: chạy npx skills add jaredpalmer/kev@kev-finetune rồi để coding agent hoàn tất toàn bộ quy trình tìm vấn đề, tạo dữ liệu, huấn luyện, đánh giá và triển khai mà không cần GPU cục bộ.
Triển khai trên đám mây: chạy pip install modal && modal deploy kev_serve.py để triển khai endpoint HTTPS chỉ bằng một lệnh; khi không sử dụng, dịch vụ tự động thu nhỏ về 0 và không tính phí.
Đánh giá và xác minh: dùng uv run python -m kev.benchmark --run <mô hình> --suite evals/v4/transfer-v4 để kiểm tra hiệu quả trên tập đánh giá cố định; đánh giá trước khi đưa vào vận hành.
05Ưu điểm cốt lõi của Kev
Chi phí cực thấp: một lượt suy luận trực tiếp xuất ra xác suất, loại bỏ việc sinh từng token. H100 chỉ mất 18ms để trả lời 6 câu hỏi và sau khi tự triển khai thì không phát sinh phí gọi API.
Huấn luyện rẻ và có thể tái lập: chi phí huấn luyện chuyển đổi ba phiên bản chính thức chỉ khoảng 95 USD, một lần tinh chỉnh cá nhân khoảng 1 USD, toàn bộ hóa đơn được công khai minh bạch.
Mã nguồn mở và có thể kiểm soát: trọng số, mã huấn luyện và tập đánh giá cố định đều được công khai theo giấy phép Apache-2.0, cho phép tự huấn luyện, kiểm toán và tránh khóa nhà cung cấp.
API cắm là chạy: hoàn toàn tương thích với TypeSafe System One; các ứng dụng Jev hiện có chỉ cần thay base_url là có thể chuyển đổi mà không cần sửa mã.
Giải quyết nhiều câu hỏi trong một lần: dùng chung trạng thái đầu vào và cô lập bằng chú ý nhân quả theo khối, một lượt suy luận có thể đồng thời trả lời số lượng câu hỏi bất kỳ mà không gây nhiễm chéo.
06Địa chỉ dự án Kev
Kho GitHub: https://github.com/jaredpalmer/kev
07Các kịch bản ứng dụng của Kev
Định tuyến phiếu hỗ trợ khách hàng: trong một lượt suy luận đồng thời xác định “chuyển đến bộ phận nào, có cần chuyển cho nhân viên hay không, mức độ tức giận của khách hàng”, tự động phân luồng theo ngưỡng xác suất và chuyển cho nhân viên khi độ tin cậy thấp.
Kiểm duyệt an toàn nội dung: song song thực hiện “noul có vi phạm hay không + choice loại vi phạm + score mức độ nghiêm trọng” trên văn bản UGC, tự động xử lý khi độ tin cậy cao.
Sàng lọc ban đầu trong tài chính/tín dụng: xác định loại khiếu nại, có cần can thiệp thủ công hay không và mức độ rủi ro. Phân phối xác suất hỗ trợ lưu vết tuân thủ và sắp xếp ưu tiên kiểm tra thủ công.
Phân loại sản phẩm/ý định thương mại điện tử: định tuyến truy vấn của người dùng tới các hệ thống hạ nguồn như tìm kiếm, đề xuất hoặc hậu mãi, xử lý vấn đề phân phối đa nhãn khi “một từ khóa thuộc nhiều danh mục”.
© Tuyên bố miễn trừ trách nhiệm: tên miền và nội dung được liên kết có thể thay đổi theo thời gian. AIEZZ không kiểm soát các trang web của bên thứ ba. Hãy tự đánh giá nội dung bên ngoài và các rủi ro liên quan.
Đánh giá của người dùng0