
- Lượt truy cập hàng tháng
- 0
- Giá
- Miễn phí và Trả phí
- Được liệt kê
- 2026-08-07
- Đã cập nhật
- 2026-08-07
01SALMONN-2 là gì
SALMONN-2 là mô hình ngôn ngữ lớn âm thanh đa dụng do Đại học Thanh Hoa, Phòng thí nghiệm Trí tuệ Nhân tạo Thượng Hải và Đại học Cambridge cùng phát hành mã nguồn mở. Mô hình được xây dựng trên bộ mã hóa âm thanh tự giám sát hợp nhất SPEAR của ByteDance và bộ thích ứng hợp nhất đặc trưng đa tầng, sử dụng Qwen3 làm nền tảng văn bản. Với khoảng 1.8 vạn giờ dữ liệu có giám sát, mô hình đạt kết quả tốt nhất trong nhóm các mô hình mã nguồn mở cùng quy mô trên ba chuẩn đánh giá tổng hợp MMAU-Pro, MMAR và MMSU, đồng thời lần đầu tiên triển khai có hệ thống trong ALLM đa dụng các năng lực nâng cao như phát hiện sự kiện âm thanh, phát hiện âm thanh giả mạo, đánh giá chất lượng giọng nói và nhận dạng giọng nói theo ngữ cảnh đa phương thức.
02Các chức năng chính của SALMONN-2
Hiểu âm thanh đa dụng: Hỗ trợ các tác vụ đa lĩnh vực như nhận dạng giọng nói, mô tả âm thanh, hiểu nhạc, nhận dạng cảm xúc và xác minh người nói.
Phát hiện sự kiện âm thanh (SED): Có thể xác định và xuất ra khoảng thời gian bắt đầu, kết thúc của các sự kiện âm thanh môi trường, chẳng hạn như tiếng chó sủa và tiếng bước chân.
Phát hiện giả mạo sâu trong âm thanh: Xác định giọng nói là thật hay giả, đồng thời khoanh vùng khoảng thời gian của các đoạn nghi bị tổng hợp hoặc chỉnh sửa.
Đánh giá chất lượng giọng nói (SQA): Nhận biết các đặc trưng âm học cấp thấp như nhiễu, méo tiếng và độ rõ, sau đó đưa ra điểm số cùng phần giải thích về chất lượng.
Nhận dạng giọng nói theo ngữ cảnh đa phương thức (MICL): Kết hợp từ viết và âm thanh phát âm tham chiếu để nâng cao độ chính xác khi nhận dạng từ hiếm và tên riêng ít gặp.
03Nguyên lý kỹ thuật của SALMONN-2
Theo dõi WeChat và trả lời “开源” để tham gia nhóm trao đổi dự án AI mã nguồn mở
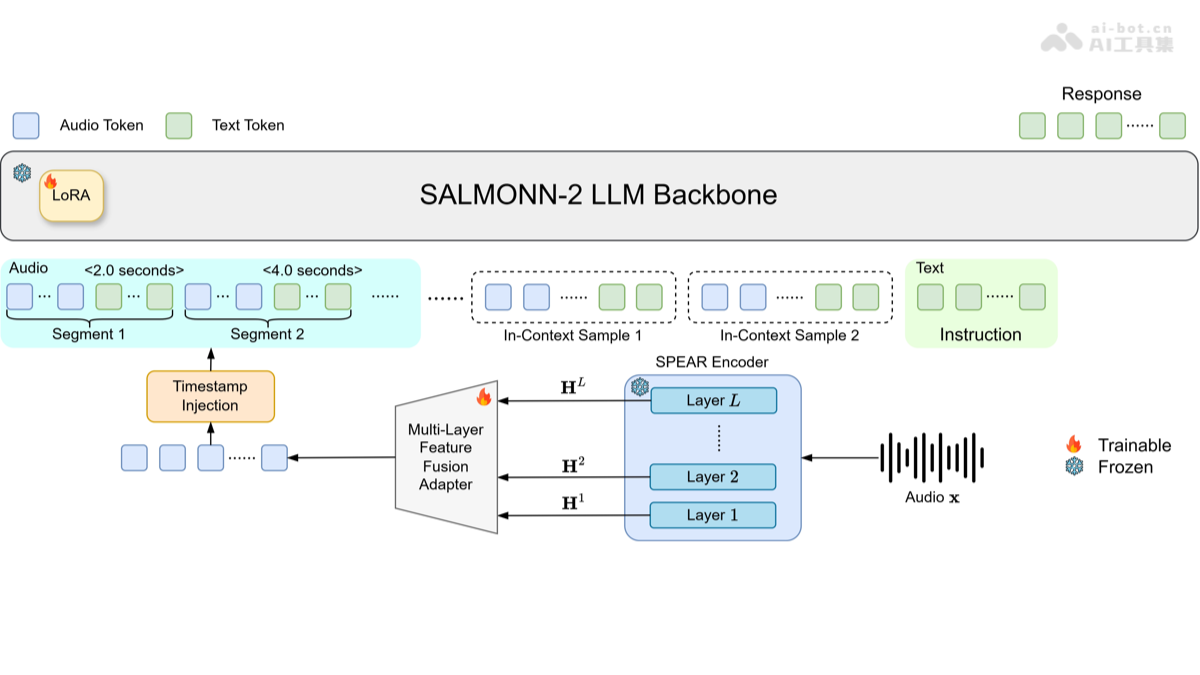
Bộ mã hóa âm thanh tự giám sát hợp nhất: SALMONN-2 sử dụng SPEAR làm frontend âm thanh duy nhất. Bộ mã hóa được huấn luyện bằng học tự giám sát trên lượng lớn dữ liệu âm thanh chưa gắn nhãn, có thể đồng thời nắm bắt thông tin ngữ nghĩa, phát âm, âm sắc, người nói và môi trường âm học, thay thế kiến trúc hai bộ mã hóa Whisper+BEATs truyền thống. Nhờ đó, kiến trúc được đơn giản hóa nhưng vẫn duy trì năng lực cân bằng hơn giữa các lĩnh vực.
Bộ thích ứng hợp nhất đặc trưng đa tầng (MLF): Các tầng của SPEAR chứa những cấp độ thông tin khác nhau: tầng nông lưu giữ chi tiết âm học và phát âm, tầng giữa chứa thông tin âm sắc và người nói, còn tầng sâu tích lũy các khái niệm ngữ nghĩa. Bộ thích ứng MLF trước tiên chuẩn hóa theo tầng và nối các trạng thái ẩn của từng tầng, sau đó thực hiện chiếu xuống có thể học và nén theo nhóm khung. Cuối cùng, các biểu diễn phân cấp đã hợp nhất được ánh xạ vào không gian embedding của mô hình ngôn ngữ, giúp mô hình linh hoạt khai thác các tín hiệu âm học ở những cấp độ khác nhau tùy theo yêu cầu của tác vụ.
Cơ chế chèn dấu thời gian: Mô hình chèn dấu thời gian trực tiếp vào chuỗi âm thanh dưới dạng văn bản ngôn ngữ tự nhiên, chẳng hạn <2.0 seconds>, rồi đưa xen kẽ cùng embedding âm thanh vào mô hình ngôn ngữ. Nhờ đó, mô hình có thể thực hiện nhiệm vụ định vị thời gian trong cùng một framework sinh nội dung mà không cần lớp embedding chuyên dụng cho dấu thời gian.
Huấn luyện học theo ngữ cảnh đa phương thức (MICL): Trong các tác vụ nhận dạng giọng nói theo ngữ cảnh, mô hình không chỉ tiếp nhận danh sách từ thiên lệch bằng văn bản mà còn đồng thời nhận âm thanh phát âm tham chiếu của các từ này làm ngữ cảnh đa phương thức. Khi huấn luyện, mô hình áp dụng chiến lược loại bỏ ngẫu nhiên từ gây nhiễu và từ mục tiêu để tránh thiên lệch quá mức, giúp mô hình học cách sử dụng hợp lý tín hiệu ngữ cảnh khi có bằng chứng âm học hỗ trợ.
04Cách sử dụng SALMONN-2
Truy cập và sao chép kho mã: Truy cập kho GitHub https://github.com/bytedance/SALMONN/tree/salmonn2, dùng git clone để tải mã nguồn về máy cục bộ.
Tạo môi trường chạy: Thực thi conda create -n salmonn2 python=3.10 để tạo và kích hoạt môi trường ảo, sau đó nâng cấp pip, setuptools và wheel.
Cài đặt thư viện và dự án: Tại thư mục gốc của kho mã, chạy pip install -r requirements.txt và pip install -e . --no-deps để hoàn tất cài đặt SALMONN-2 cùng các phụ thuộc thời gian chạy.
Tải trọng số tiền huấn luyện: Dùng HuggingFace CLI để tải checkpoint của mô hình: hf download marcoyang/SALMONN-2-8B --repo-type model --local-dir /path/to/salmonn-2-hf.
Nạp mô hình và suy luận: Dùng AutoProcessor và AutoModelForCausalLM để nạp trọng số cục bộ, truyền tệp âm thanh cùng văn bản chỉ dẫn, sau đó gọi model.generate() để nhận kết quả hiểu âm thanh.
05Ưu điểm cốt lõi của SALMONN-2
Hiệu quả dữ liệu: Chỉ sử dụng khoảng 1.8 vạn giờ dữ liệu có giám sát, thấp hơn nhiều so với mức hàng chục vạn đến hàng triệu giờ thường dùng ở các sản phẩm cạnh tranh cùng quy mô, qua đó giảm đáng kể chi phí gắn nhãn.
Frontend hợp nhất, hiệu năng cân bằng hơn: Bộ mã hóa tự giám sát SPEAR duy nhất thay thế kiến trúc hai bộ mã hóa, đạt hiệu năng cân bằng hơn giữa các tác vụ về giọng nói, âm thanh môi trường, âm nhạc và âm thanh cận ngôn ngữ.
Tận dụng đầy đủ thông tin phân cấp: Bộ thích ứng MLF hợp nhất đặc trưng từ tất cả các tầng của bộ mã hóa, tránh mất các chi tiết quan trọng về âm học và âm sắc do chỉ sử dụng tầng cuối.
Mở rộng năng lực phân tích âm thanh: Lần đầu tiên hỗ trợ có hệ thống trong ALLM đa dụng các tác vụ phân tích âm thanh trước đây thường bị bỏ qua như SED, phát hiện giả mạo và SQA.
Có khả năng mở rộng quy mô: Sau khi mở rộng nền tảng văn bản từ 8B lên 30B-A3B, điểm số trên cả ba chuẩn đánh giá tổng hợp đều tiếp tục tăng, xác nhận kiến trúc có tiềm năng scale-up tốt.
06Địa chỉ dự án SALMONN-2
Kho GitHub: https://github.com/bytedance/SALMONN/tree/salmonn2
Kho mô hình HuggingFace: https://huggingface.co/marcoyang/SALMONN-2-8B
Bài báo kỹ thuật trên arXiv: https://arxiv.org/pdf/2607.17079
07Các kịch bản ứng dụng của SALMONN-2
Trợ lý họp thông minh: Ghi âm và chuyển nội dung cuộc họp thành văn bản theo thời gian thực, kết hợp mẫu phát âm của người tham dự để nhận dạng chính xác tên người nước ngoài và thuật ngữ chuyên ngành.
Kiểm duyệt nội dung âm thanh: Tự động phát hiện các sự kiện âm thanh bất thường trong livestream hoặc podcast, đồng thời nhận dạng giọng nói giả mạo sâu để phòng chống lừa đảo.
Giám sát chất lượng giọng nói: Tự động chấm điểm chất lượng cuộc gọi chăm sóc khách hàng và nội dung phòng thu, đồng thời xác định các đoạn bị nhiễu hoặc méo tiếng.
Tìm kiếm kho lưu trữ đa phương tiện: Tạo mô tả sự kiện kèm dấu thời gian cho âm thanh lịch sử và chương trình phát thanh, hỗ trợ tìm kiếm chính xác theo nội dung.
Thiết bị hỗ trợ người khiếm thính: Hiển thị theo thời gian thực các sự kiện âm thanh môi trường, chẳng hạn như chuông cửa và chuông báo động, dưới dạng văn bản kèm dấu thời gian để thông báo cho người khiếm thính.
© Tuyên bố miễn trừ trách nhiệm: tên miền và nội dung được liên kết có thể thay đổi theo thời gian. AIEZZ không kiểm soát các trang web của bên thứ ba. Hãy tự đánh giá nội dung bên ngoài và các rủi ro liên quan.
Đánh giá của người dùng0