
- Lượt truy cập hàng tháng
- 0
- Giá
- Miễn phí và Trả phí
- Được liệt kê
- 2026-01-16
- Đã cập nhật
- 2026-08-25
01Định vị sản phẩm
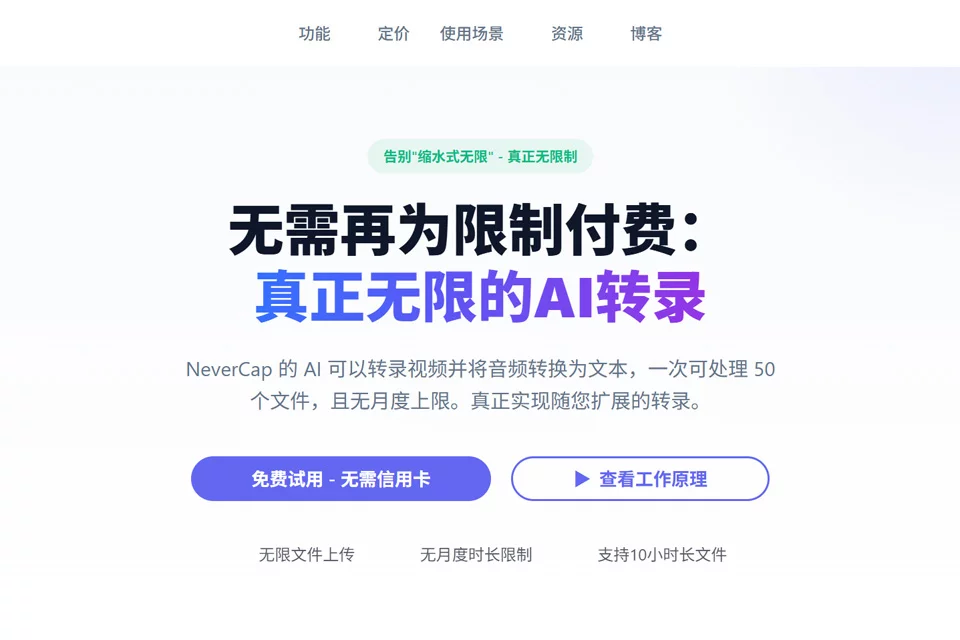
NeverCap phục vụ người dùng cần xử lý nội dung văn bản từ âm thanh và video, cung cấp quy trình hoàn chỉnh từ tải tệp lên, tự động chuyển thành văn bản đến dịch và xuất kết quả. Công cụ chuyển lời nói trong âm thanh hoặc video thành văn bản dễ đọc, dễ chỉnh sửa, đồng thời có thể tạo phụ đề hoặc phiên bản đa ngôn ngữ.
Công cụ phù hợp với người làm podcast, nhà sáng tạo video, nhà nghiên cứu, cũng như giảng viên và sinh viên cần整理 nội dung bài giảng, đặc biệt trong các quy trình phải xử lý nhiều tệp ghi âm hoặc video cùng lúc.
02Tính năng chính
NeverCap hỗ trợ tệp MP3, MP4, cho phép tải lên tối đa 50 tệp mỗi lần, với thời lượng tối đa 10 giờ và dung lượng tối đa 5GB cho mỗi tệp. Công cụ nhận diện hơn 100 ngôn ngữ và dịch nội dung đã chuyển thành văn bản sang 249 ngôn ngữ.
Trong quá trình chuyển văn bản, công cụ cung cấp tính năng nhận diện người nói, tự động thêm dấu câu và sắp xếp đoạn văn, thuận tiện cho việc xử lý nội dung phỏng vấn, thảo luận và hội thoại. Sau khi hoàn tất, có thể xuất kết quả dưới dạng PDF, Word hoặc SRT, lần lượt phục vụ việc đọc, chỉnh sửa và tạo phụ đề.
03Tình huống sử dụng
Các nhóm podcast có thể xử lý hàng loạt bản chép lời chương trình, trích xuất nội dung phỏng vấn hoặc tạo phần mô tả chương trình; nhà sáng tạo video có thể dùng kết quả chuyển văn bản để tạo phụ đề và sản xuất phiên bản bằng các ngôn ngữ khác.
Trong nghiên cứu học thuật, công cụ có thể dùng để整理 phỏng vấn, thảo luận nhóm tập trung và bản ghi thực địa; trong giáo dục, công cụ hỗ trợ整理 bản ghi bài giảng, ghi chép lớp học và tài liệu ôn tập. Với hội thoại nhiều người, nên sử dụng tính năng nhận diện người nói, nhưng vẫn cần kiểm tra độ chính xác của nhãn người nói.
04Lưu ý khi sử dụng
Trước khi tải lên, cần xác nhận định dạng, thời lượng và dung lượng tệp đáp ứng các giới hạn, đồng thời chọn định dạng xuất phù hợp với mục đích sử dụng. Kết quả chuyển văn bản tự động đối với tên riêng, phương ngữ, bản ghi có giọng địa phương rõ rệt, tiếng ồn nền hoặc nhiều người nói chồng lên nhau có thể cần được chỉnh sửa thủ công.
Đối với phỏng vấn nghiên cứu, tài liệu khóa học hoặc nội dung chưa công khai, nên tìm hiểu trước các quy định về xử lý tệp và sử dụng dữ liệu rồi mới quyết định tải lên. Không nên sử dụng trực tiếp các trích dẫn, phụ đề và văn bản công bố ra bên ngoài nếu chưa kiểm tra lại.
© Tuyên bố miễn trừ trách nhiệm: tên miền và nội dung được liên kết có thể thay đổi theo thời gian. AIEZZ không kiểm soát các trang web của bên thứ ba. Hãy tự đánh giá nội dung bên ngoài và các rủi ro liên quan.
Đánh giá của người dùng0