
Tất cả công cụ AI
Công cụ âm thanh AI
Bạn đang khám phá các sản phẩm AI thông minh nổi bật trong lĩnh vực công cụ âm thanh AI, được tối ưu và thiết kế phù hợp để cung cấp giải pháp xuất sắc cho ngành.
 R2T2Nhận diện giọng nói AIR2T2 là mô hình nhận dạng giọng nói phát trực tuyến thực sự với độ trễ thấp do NetEase Youdao phát hành mã nguồn mở, tên đầy đủ là Real Real-Time Transcription, được xây dựng trên Qwen3-ASR.00
 Spark-ASR-2.0Nhận diện giọng nói AISpark-ASR-2.0 là mô hình nhận dạng giọng nói thế hệ mới nhất của iFlytek, được phát triển dựa trên mô hình nền tảng giọng nói Spark-Audio thuộc hệ sinh thái Spark. Mô hình sử dụng kiến trúc phối hợp “phi tự hồi quy + tự hồi quy tăng cường bằng LLM”, hỗ trợ tiếng Trung và tiếng Anh kết hợp, phương ngữ, thuật ngữ chuyên ngành...00
 MusicBuddySáng tác nhạc AIMusicBuddy là nền tảng sáng tác âm nhạc bằng AI do Tencent Music phát triển, cung cấp dịch vụ toàn diện cho các nhạc sĩ. MusicBuddy giữ lại hình thức chỉnh sửa đa track truyền thống của DAW, đồng thời tích hợp bảng hội thoại AI ở bên trái, cho phép hoàn thành các điều chỉnh phối khí...00
 YuE2Sáng tác nhạc AIYuE2 là mô hình tạo nhạc mã nguồn mở do Đại học Khoa học và Công nghệ Hồng Kông cùng đội ngũ M-A-P phát triển. Mô hình có thể tạo bản nhạc ABC có thể chỉnh sửa (giai điệu + hợp âm) dựa trên lời bài hát và phong cách, sau đó kết xuất thành bài hát hoàn chỉnh 48kHz, giúp quá trình sáng tác minh bạch và có thể kiểm soát.00
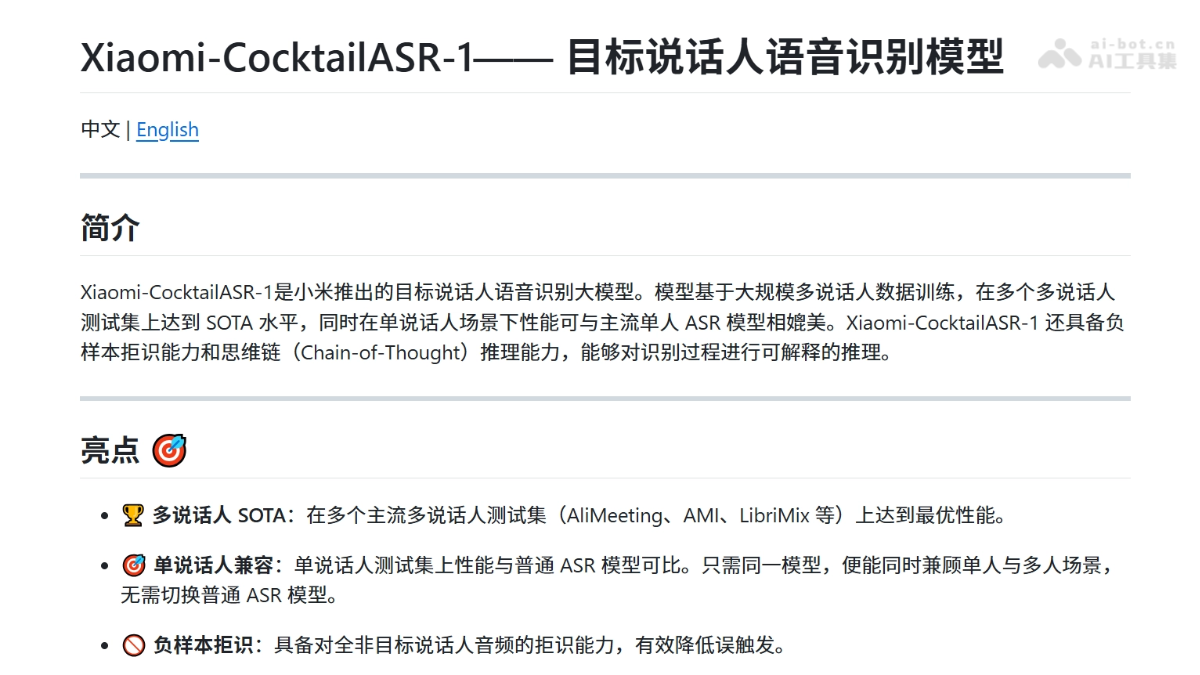 Xiaomi-CocktailASR-1Nhận diện giọng nói AIXiaomi-CocktailASR-1 là mô hình nhận dạng giọng nói người nói mục tiêu quy mô lớn do Xiaomi mã nguồn mở, dựa trên kiến trúc LLM đầu cuối, sử dụng giọng nói tham chiếu làm gợi ý dấu giọng. Không cần tách giọng nói, mô hình có thể phiên âm chính xác người nói mục tiêu từ âm thanh trộn của nhiều người...00
 MAI-Transcribe-2Nhận diện giọng nói AIMAI-Transcribe-2 là mô hình AI chuyển giọng nói thành văn bản mạnh mẽ nhất do Microsoft phát triển, dẫn đầu toàn diện về độ chính xác, tốc độ và chi phí. Mô hình hỗ trợ 60 ngôn ngữ, với tỷ lệ lỗi từ trung bình chỉ 5,2% trên bộ kiểm thử FLEURS.00
 Audo StudioCông cụ âm thanh AIAudo Studio là công cụ xử lý âm thanh AI trên trình duyệt, chủ yếu dùng để cải thiện tiếng ồn nền, tiếng vọng và tình trạng âm lượng không ổn định trong bản ghi. Người dùng không cần cài đặt phần mềm hay điều chỉnh các thông số phức tạp; chỉ cần tải tệp âm thanh lên để tự động khử tiếng ồn, loại bỏ tiếng vọng và cân bằng âm lượng, sau đó sử dụng kết quả cho podcast, video hoặc khóa học trực tuyến. Công cụ phù hợp với người sáng tạo podcast, blogger video, giảng viên khóa học trực tuyến và người dùng cá nhân thỉnh thoảng cần xử lý bản ghi cuộc họp hoặc ghi chú thoại. Sản phẩm cung cấp gói miễn phí và trả phí; hạn mức hoặc mức giá cụ thể cần được xác nhận trên trang chính thức. Do quy trình thiên về tự động hóa, phạm vi sử dụng có thể bị hạn chế trong những trường hợp cần kiểm soát chi tiết các thông số xử lý.048.2
 愛声音坊 AiSoundsCông cụ âm thanh AI愛声音坊 AiSounds là công cụ âm thanh trí tuệ nhân tạo dành cho nhà sáng tạo nội dung, phục vụ các nhu cầu như video ngắn, trò chơi, podcast, truyền thông cá nhân và đội ngũ nội dung. Người dùng có thể tải video lên để tạo nhạc nền phù hợp với hình ảnh, nhập mô tả bằng tiếng Trung để tạo hiệu ứng âm thanh và âm nhạc, hoặc chuyển văn bản thành lời thuyết minh, lời đọc và giọng nhân vật. Nền tảng cũng cung cấp xuất phụ đề, chỉnh sửa âm thanh trực tuyến và chuyển giao cho phần mềm dựng, giúp kết nối các tài nguyên âm thanh với quy trình hậu kỳ. Công cụ phù hợp với những người thường xuyên sản xuất video, khóa học, podcast và nội dung mạng xã hội, giúp giảm việc chuyển đổi giữa các công cụ tìm kiếm tài nguyên và xử lý âm thanh. Nội dung được tạo vẫn cần được kiểm tra và điều chỉnh thủ công dựa trên hình ảnh, văn bản và hiệu quả của sản phẩm hoàn chỉnh.098
 iFlytek ZhizuoCông cụ âm thanh AIiFlytek Zhizuo là nền tảng sáng tạo âm thanh và video AI do iFlytek phát triển, hướng đến nhà sáng tạo video ngắn, nhân viên truyền thông doanh nghiệp, nhà giáo dục và người làm truyền thông. Người dùng có thể nhập văn bản hoặc bản ghi âm, chọn hình tượng người dẫn ảo để tạo video thuyết minh, đồng thời sử dụng chuyển văn bản thành giọng nói, chuyển PPT thành video và các công cụ sáng tạo AIGC khác. Nền tảng hỗ trợ lồng tiếng tiếng Trung và tiếng Anh, đồng thời cung cấp các tùy chỉnh như tốc độ và ngữ điệu. Sản phẩm áp dụng mô hình kết hợp miễn phí và trả phí. Hiệu quả tạo nội dung vẫn phụ thuộc vào lựa chọn kịch bản, giọng nói và hình tượng; trước khi phát hành chính thức, cần kiểm tra cách phát âm, hình ảnh và độ chính xác của nội dung.038.6
 NoizCông cụ âm thanh AINoiz là công cụ âm thanh AI, chủ yếu dùng để nhân bản giọng nói, tạo giọng nói và lồng tiếng đa ngôn ngữ. Người dùng có thể tải lên một đoạn âm thanh mẫu để tạo mô hình giọng nói tương ứng, sau đó chuyển văn bản thành giọng nói. Công cụ cũng có thể dùng cho tổng hợp giọng hát, biểu đạt cảm xúc và đồng bộ khẩu hình video. Noiz phù hợp với nhà sáng tạo video, đội ngũ nội dung phát triển thị trường quốc tế, nhà sản xuất sách nói và nhà phát triển game độc lập để tạo lời thuyết minh, phiên bản đa ngôn ngữ, hội thoại nhân vật và các nội dung khác. Nền tảng cung cấp gói miễn phí và trả phí, phạm vi sử dụng cụ thể có thể khác nhau. Chất lượng đầu ra phụ thuộc vào chất lượng mẫu âm thanh, ngữ cảnh văn bản và cài đặt cảm xúc. Trước khi phát hành chính thức, vẫn cần kiểm tra thủ công giọng nói, bản dịch và mức độ khớp giữa âm thanh với hình ảnh.087.7
 DevoiceCông cụ âm thanh AIDevoice là công cụ AI xử lý âm thanh và video, cung cấp các tính năng chuyển âm thanh thành văn bản, khử nhiễu nền và tạo lời bài hát. Người dùng không cần đăng ký, có thể tải lên tệp MP3, WAV, M4A hoặc video để chuyển nội dung sang các định dạng TXT, DOCX, SRT; đồng thời xử lý tiếng ồn nền trong bản ghi hoặc tạo lời bài hát hip-hop dựa trên chủ đề và cảm xúc. Công cụ phù hợp với sinh viên cần sắp xếp bản ghi bài giảng, nhân viên văn phòng xử lý nội dung cuộc họp và phỏng vấn, cũng như nhà sáng tạo nội dung, streamer và nhạc sĩ. Công cụ hỗ trợ nhận diện nhiều ngôn ngữ và tự động xóa tệp sau khi xử lý; vì vậy không phù hợp với quy trình cần lưu trữ trực tuyến lâu dài hoặc lấy lại tệp gốc nhiều lần.017.4
 TTS - Chuyển văn bản thành giọng nóiCông cụ âm thanh AITTS - Chuyển văn bản thành giọng nói là một công cụ âm thanh AI trực tuyến, chủ yếu chuyển văn bản nhập vào thành tệp âm thanh có thể xuất. Công cụ sử dụng công nghệ tổng hợp giọng nói Microsoft Azure, hỗ trợ tiếng Phổ thông Trung Quốc, một số phương ngữ và nhiều ngoại ngữ, đồng thời cung cấp các cài đặt như giọng nhân vật, chế độ cảm xúc, khoảng dừng và cách đọc chữ đa âm. Người dùng có thể nhập hoặc sắp xếp văn bản trên trang web, sau đó điều chỉnh các thông số giọng nói theo nhu cầu để tạo âm thanh MP3 hoặc WAV. Công cụ phù hợp với các tình huống như thuyết minh phim ảnh, lồng tiếng video ngắn, học ngoại ngữ và đọc văn bản dài. Khi xử lý phương ngữ, danh từ riêng hoặc cách diễn đạt cảm xúc phức tạp, kết quả tạo ra vẫn cần được nghe thử và kiểm tra thủ công.087.3
 SpeechifyCông cụ âm thanh AISpeechify là công cụ đọc và năng suất lấy giọng nói làm trọng tâm, có thể chuyển đổi nội dung văn bản như PDF, tài liệu và trang web thành giọng nói, đồng thời hỗ trợ nhập liệu bằng giọng nói, hỏi đáp nội dung, tóm tắt và tạo podcast. Sản phẩm cung cấp phiên bản web, tiện ích mở rộng trình duyệt cùng các ứng dụng cho Windows, macOS, iOS và Android, giúp người dùng xử lý công việc đọc, viết và tiếp nhận thông tin bằng cách nghe và nói.017.9
 Âm TiễnCông cụ âm thanh AIÂm Tiễn là nền tảng sáng tạo âm thanh AI tất cả trong một do Ximalaya cung cấp, dành cho podcaster, nhà sản xuất sách nói và các nhà sáng tạo âm thanh khác. Nền tảng hỗ trợ nhiều nhu cầu như ghi âm, chỉnh sửa, chuyển bài viết thành giọng nói, sản xuất nội dung nói và hỗ trợ phát trực tiếp, đồng thời cung cấp các công cụ khử tiếng ồn, thêm nhạc nền và tạo phụ đề để hỗ trợ sản xuất nội dung âm thanh.018.2
 DupDubCông cụ âm thanh AIDupDub là công cụ âm thanh AI dành cho nhà sáng tạo nội dung, chủ yếu dùng để chuyển văn bản thành giọng nói, đồng thời hỗ trợ sao chép giọng nói, thuyết minh bằng nhân vật ảo, dịch video và chỉnh sửa phụ đề. Người dùng có thể nhập hoặc sắp xếp kịch bản trên nền tảng, chọn giọng nói và nhân vật, điều chỉnh tốc độ, cao độ, khoảng dừng và cảm xúc, sau đó xuất âm thanh hoặc tạo nội dung video liên quan. Công cụ phù hợp với nhà sáng tạo video, nhà sản xuất podcast và sách nói, chuyên viên tiếp thị, giảng viên giáo dục và đào tạo, cũng như các đội ngũ doanh nghiệp mở rộng hoạt động ra thị trường quốc tế. Nền tảng cung cấp khả năng lồng tiếng nhiều nhân vật, hỗ trợ đa ngôn ngữ và chỉnh sửa âm thanh, nhưng kết quả về cảm xúc giọng nói, nội dung dịch và khẩu hình nhân vật ảo vẫn cần được kiểm tra thủ công trước khi xuất bản.017.8
 Supertone PlayCông cụ âm thanh AISupertone Play là công cụ âm thanh AI dành cho sáng tạo giọng nói, cung cấp tính năng nhân bản giọng nói, chuyển văn bản thành giọng nói và thư viện giọng nhân vật, phù hợp với nhà sáng tạo nội dung, nhà sản xuất trò chơi và anime, nhân sự quảng cáo tiếp thị cũng như nhạc sĩ. Người dùng có thể ghi âm giọng nói cá nhân trong khoảng 10 giây để tạo mô hình giọng nói, sau đó nhập văn bản để chuyển thành giọng nói và điều chỉnh các tham số như cao độ, tốc độ nói và cảm xúc. Nền tảng hỗ trợ tiếng Anh, tiếng Hàn và tiếng Nhật, đồng thời có các gói miễn phí và trả phí. Trong thực tế, hiệu quả giọng nói sẽ chịu ảnh hưởng bởi chất lượng bản ghi, nội dung văn bản và cài đặt tham số; đầu ra đa ngôn ngữ cũng cần được nghe thử và kiểm tra từng mục.038.2
 Fish AudioCông cụ âm thanh AIFish Audio là công cụ âm thanh AI, chủ yếu dùng để chuyển văn bản thành giọng nói và sao chép giọng nói. Người dùng có thể tải lên một mẫu âm thanh ngắn để tạo mô hình giọng nói kỹ thuật số, sau đó chuyển văn bản thành giọng nói; nền tảng cũng cung cấp API tổng hợp giọng nói theo thời gian thực, thư viện giọng nói cộng đồng cùng các tùy chọn điều chỉnh cảm xúc, tốc độ nói, cao độ và âm lượng. Công cụ phù hợp với nhà sáng tạo nội dung để sản xuất lời thuyết minh, nội dung âm thanh và lồng tiếng video, đồng thời hỗ trợ doanh nghiệp, nhà phát triển và nhà giáo dục xây dựng ứng dụng giọng nói hoặc sản xuất âm thanh cho khóa học. Nền tảng cung cấp cả gói miễn phí và trả phí. Chất lượng đầu ra thực tế phụ thuộc vào độ rõ của mẫu âm thanh, cách diễn đạt văn bản và bối cảnh sử dụng; trước khi sử dụng giọng nói của người khác, cần xác nhận phạm vi cấp phép tương ứng.038.6
 Mubert AICông cụ âm thanh AIMubert AI là công cụ âm thanh bằng AI, chủ yếu dùng để tạo nhạc nền dựa trên lời nhắc văn bản, cảm xúc, phong cách, bối cảnh hoặc thời lượng. Nhà sáng tạo nội dung có thể sử dụng công cụ này cho video, podcast và các sản phẩm khác; nhà phát triển và thương hiệu có thể khám phá nhạc nền động thông qua API; còn nhạc sĩ có thể tải tài nguyên âm nhạc lên Mubert Studio. Nền tảng cũng cung cấp plugin cho các phần mềm như Adobe Premiere Pro và Adobe After Effects, phù hợp với một số quy trình sáng tạo. Khi sử dụng, cần điều chỉnh lời nhắc và thời lượng theo yêu cầu của dự án; phạm vi cấp phép cụ thể nên được xác nhận dựa trên gói đã chọn và bối cảnh phát hành.038.1
 Copilot LabsCông cụ âm thanh AICopilot Labs là nền tảng thử nghiệm AI của Microsoft. Dự án Audio Expression hướng đến các nhà sáng tạo và người dùng chuyên nghiệp cần sản xuất nội dung giọng nói, sử dụng các mô hình như MAI-Voice-1 để chuyển văn bản thành giọng người tự nhiên. Sau khi nhập văn bản, người dùng có thể chọn giữa các chế độ cảm xúc, kể chuyện và kịch bản, rồi tạo âm thanh với nhiều phong cách giọng nói khác nhau. Chế độ cảm xúc và kể chuyện cho phép AI trau chuốt, sắp xếp lại hoặc diễn đạt nội dung; chế độ kịch bản chú trọng đọc theo nguyên văn. Kết quả có thể tải xuống dưới dạng MP3; tài liệu hiện có cho thấy không cần đăng nhập để tải xuống. Cần lưu ý rằng các chế độ sáng tạo có thể thay đổi cách diễn đạt câu gốc, vì vậy nên kiểm tra nội dung và giọng điệu có đáp ứng yêu cầu của kịch bản trước khi phát hành chính thức.028.2
 ElevenLabsCông cụ âm thanh AIElevenLabs là công cụ âm thanh AI, chủ yếu dùng để chuyển văn bản thành giọng nói, đồng thời cung cấp các khả năng như nhân bản giọng nói, dịch lồng tiếng video hoặc âm thanh, thiết kế giọng nói và tác nhân giọng nói AI. Người dùng có thể nhập văn bản, tải lên mẫu âm thanh hoặc xử lý phương tiện có sẵn trên nền tảng, sau đó xuất nội dung giọng nói; ngoài ra, họ có thể tích hợp các khả năng giọng nói vào ứng dụng của mình thông qua API. Công cụ phù hợp với nhà sáng tạo video, nhà sản xuất podcast và sách nói, đội ngũ phát triển trò chơi và hoạt hình, nhân sự giáo dục và đào tạo, cũng như các nhà phát triển và doanh nghiệp cần chức năng tương tác bằng giọng nói. Nền tảng cung cấp cả gói miễn phí và trả phí. Khi sử dụng tính năng nhân bản giọng nói hoặc lồng tiếng, cần xác nhận trước phạm vi cấp phép đối với mẫu âm thanh, giọng nói của nhân vật và nội dung liên quan, đồng thời kiểm tra thủ công kết quả được tạo ra.048.2
 SongSens.aiCông cụ âm thanh AISongSens.ai là công cụ âm thanh AI được thiết kế xoay quanh việc học ngoại ngữ qua các bài hát, chủ yếu phục vụ người học ngoại ngữ, đồng thời phù hợp với nhà phê bình âm nhạc, nhà nghiên cứu văn hóa và người sáng tạo bản cover. Người dùng có thể bắt đầu từ bài hát hoặc lời bài hát để xem phân tích ngữ cảnh, giải nghĩa từng từ, hướng dẫn phát âm và bài kiểm tra ghi nhớ, đồng thời nghe và tìm hiểu lời bài hát qua trình phát. Công cụ sử dụng bài hát làm đầu vào ngôn ngữ, giúp người dùng tiếp cận từ vựng, cách diễn đạt và thông tin văn hóa trong ngữ cảnh cụ thể. Tài liệu hiện có đề cập khả năng kết nối với các trình phát như Apple Music, nhưng chưa nêu rõ phạm vi hỗ trợ đầy đủ, số lượng ngôn ngữ hay quy định tính phí cụ thể. Những ẩn dụ, phương ngữ và bối cảnh văn hóa trong lời bài hát vẫn có thể cần được người dùng đối chiếu với nguyên văn và các tài liệu khác.047.8
 音述AICông cụ âm thanh AI音述AI là nền tảng sáng tác và chia sẻ âm nhạc bằng AI dành cho người dùng tiếng Trung, hỗ trợ toàn bộ quy trình từ cảm hứng bằng văn bản, tạo lời bài hát đến xuất bản bài hát và đăng lên cộng đồng. Người dùng có thể mô tả bằng văn bản để thiết lập chủ đề và phong cách, sau đó chọn chất giọng và tạo một bài hát hoàn chỉnh gồm giai điệu, phối khí và giọng hát; khi cần tiếp tục sản xuất, có thể xuất các track Stem để phối trộn. Sản phẩm hướng đến người sáng tạo âm nhạc, người làm nhạc cho video ngắn và podcast, thương hiệu cùng những người yêu thích âm thanh, đồng thời phù hợp với cả những người không có nền tảng nhạc lý nhưng muốn thể hiện cảm xúc. Nền tảng cung cấp cả hình thức sử dụng miễn phí và trả phí. Cần lưu ý rằng hiệu lực thực tế của kết quả tạo, phạm vi cấp phép và việc lưu chứng cứ bản quyền vẫn phải tuân theo quy định của nền tảng và từng bối cảnh sử dụng cụ thể.068.4
 WhisperCông cụ âm thanh AIWhisper là hệ thống nhận dạng giọng nói tự động do OpenAI phát triển, tập trung vào chuyển âm thanh thành văn bản, dịch giọng nói và整理 nội dung. Người dùng có thể đưa tệp âm thanh vào hệ thống để nhận bản ghi văn bản tương ứng, đồng thời xem dấu thời gian theo từ hoặc câu; đối với một số giọng nói không phải tiếng Anh, hệ thống cũng có thể dịch trực tiếp sang văn bản tiếng Anh. Whisper được huấn luyện trên 680.000 giờ dữ liệu có giám sát, bao gồm nhiều ngôn ngữ và tác vụ. Mô hình cùng mã nguồn được công khai, phù hợp để nhà phát triển tích hợp, nhà nghiên cứu thử nghiệm, cũng như整理 nội dung phỏng vấn, podcast, cuộc họp, bài giảng và video. Kết quả nhận dạng vẫn nên được kiểm tra thủ công dựa trên chất lượng bản ghi, giọng địa phương và thuật ngữ chuyên ngành.028.4
 FineVoiceCông cụ âm thanh AIFineVoice là nền tảng sáng tạo âm thanh AI, tích hợp các tính năng chuyển văn bản thành giọng nói, nhân bản giọng nói, chuyển đổi giọng theo thời gian thực, chuyển giọng nói thành văn bản và tạo hiệu ứng âm thanh bằng AI. Người dùng có thể bắt đầu từ văn bản hoặc tài liệu âm thanh, chọn hoặc thiết kế giọng nói, điều chỉnh các thông số như tốc độ nói và cảm xúc, rồi sử dụng kết quả cho video, podcast, khóa học, trò chơi và nội dung tiếp thị. Theo thông tin của nền tảng, công cụ hỗ trợ nhiều ngôn ngữ và giọng đọc, đồng thời cung cấp các gói miễn phí và trả phí. Công cụ phù hợp với nhà sáng tạo cá nhân, đội ngũ giáo dục, nhà phát triển trò chơi và hoạt hình, cũng như doanh nghiệp cần lồng tiếng, phiên âm hoặc tài liệu hiệu ứng âm thanh. Kết quả thực tế có thể bị ảnh hưởng bởi cách diễn đạt văn bản, mức độ hỗ trợ ngôn ngữ và chất lượng âm thanh đầu vào; với tính năng nhân bản giọng nói, cần xác nhận quyền sử dụng liên quan trước khi thực hiện.098.4
 YinChongCông cụ âm thanh AIYinChong là công cụ âm thanh AI tiếng Trung dành cho người dùng trong nước, giúp giảm độ khó khi bắt đầu sản xuất âm nhạc và phối khí. Người dùng có thể sử dụng nhạc cụ ảo và hiệu ứng tích hợp trong phần mềm, nhập giai điệu để AI tạo phần đệm, đồng thời mở rộng khả năng sản xuất thông qua các plugin VST và VST3. Giao diện hoàn toàn bằng tiếng Trung phù hợp với người mới học nhạc, người yêu thích âm nhạc, giáo viên và học sinh, sinh viên, cũng như người dùng thu âm tại nhà, phục vụ luyện tập trên lớp, làm bài tập âm nhạc, thu âm hát lại hoặc sản xuất Demo đơn giản. Phần mềm vẫn cung cấp không gian mở rộng plugin cho người dùng nâng cao, nhưng phần đệm do AI tạo ra có thể vẫn cần chỉnh sửa thủ công, và hiệu quả thực tế phụ thuộc vào giai điệu đầu vào cũng như cách phối khí tiếp theo.067.7
 BeepThatOutCông cụ âm thanh AIBeepThatOut là công cụ âm thanh AI dành cho nhà sáng tạo nội dung, dùng để quét video và âm thanh nhằm tìm lời tục tĩu hoặc các từ ngữ khác cần che đi, sau đó thêm hiệu ứng tắt tiếng theo cài đặt của người dùng. Sau khi tải tệp lên, người dùng có thể định vị từ ngữ qua bản chép lời tương tác, chọn phạm vi cần che và hiệu ứng âm thanh, rồi xuất kết quả đã xử lý. Công cụ cũng hỗ trợ tạo phụ đề SRT và xuất tệp dự án cho Adobe Premiere Pro, Final Cut Pro và DaVinci Resolve. Công cụ phù hợp với nhà sáng tạo YouTube, người làm podcast, biên tập viên, đội ngũ tiếp thị và nhà giáo dục. Kết quả nhận diện tự động vẫn cần được kiểm tra thủ công, đặc biệt với tên riêng, ngữ cảnh và các cách diễn đạt mang tính ranh giới.038.1
 Sounder AICông cụ âm thanh AISounder AI là nền tảng phân tích thông minh dành cho nội dung âm thanh dài như podcast. Kết hợp học máy và xử lý ngôn ngữ tự nhiên, nền tảng chuyển đổi âm thanh thành văn bản có cấu trúc, đồng thời nhận diện các chủ đề và ngữ cảnh trong nội dung. Người dùng có thể nhập hoặc xử lý âm thanh trước, sau đó sử dụng tính năng phiên âm, phân tích nội dung, xác minh an toàn thương hiệu và dữ liệu khán giả để quản lý nội dung hoặc nhắm mục tiêu quảng cáo. Đối tượng sử dụng bao gồm nhà sáng tạo podcast, đại lý quảng cáo, nhà xuất bản âm thanh và thương hiệu, phục vụ việc sắp xếp nội dung chương trình, đánh giá môi trường quảng cáo và khám phá cơ hội kiếm tiền. Nền tảng cung cấp cả gói miễn phí và trả phí. Kết quả phiên âm và nhận diện nội dung nhạy cảm vẫn cần được kết hợp với kiểm tra thủ công, không thể thay thế quy trình kiểm duyệt nội dung đầy đủ.067.8
 Transync AICông cụ âm thanh AITransync AI là công cụ âm thanh AI dành cho các cuộc họp và giao tiếp trực tiếp, chủ yếu hiển thị nội dung hội thoại dưới dạng phụ đề song ngữ song song thông qua nhận dạng giọng nói và dịch theo thời gian thực. Khi sử dụng, sản phẩm có thể trực tiếp nghe nội dung phát biểu trong cuộc họp, nhận dạng các người nói và ngôn ngữ khác nhau, đồng thời xuất kết quả dịch; sản phẩm cũng có thể hỗ trợ giao tiếp bằng tính năng đọc bằng giọng nói. Sau cuộc họp, công cụ còn có thể tạo biên bản và bản tóm tắt. Sản phẩm phù hợp với nhân viên kinh doanh ngoại thương, các nhóm xuyên quốc gia, freelancer làm việc xuyên biên giới, cũng như người dùng có nhu cầu giao tiếp khi du học và đi công tác. Sản phẩm hỗ trợ 60 ngôn ngữ và có thể được sử dụng trong các bối cảnh họp trên Zoom, Microsoft Teams, Google Meet cùng nhiều nền tảng khác. Lưu ý rằng gói Premium cung cấp 10 giờ dịch song song theo thời gian thực mỗi tháng; cần xác nhận hạn mức sử dụng và điều kiện thanh toán cụ thể trước khi sử dụng.077.6
 PlaudCông cụ âm thanh AIPlaud là công cụ âm thanh kết hợp phần cứng ghi âm với khả năng xử lý bằng AI, chủ yếu dùng để sắp xếp nội dung cuộc họp, phỏng vấn, cuộc gọi và ghi chú bằng giọng nói. Người dùng có thể ghi âm bằng phần cứng dạng thẻ hoặc dạng kẹp, đồng thời bổ sung văn bản và hình ảnh trong ứng dụng; sau khi tải bản ghi lên, hệ thống có thể tạo bản chép lời, bản tóm tắt, các ý chính và sơ đồ tư duy, đồng thời hỗ trợ đặt câu hỏi về nội dung bản ghi. Sản phẩm phù hợp với nhân viên văn phòng, nhân viên kinh doanh, nhà giáo dục, nhà báo và người sáng tạo nội dung thường xuyên xử lý thông tin bằng giọng nói. Sản phẩm cung cấp các gói miễn phí và trả phí. Cần lưu ý rằng kết quả chép lời và tóm tắt vẫn có thể bị ảnh hưởng bởi chất lượng ghi âm, tiếng ồn môi trường và việc nhiều người nói cùng lúc; các nội dung quan trọng nên được đối chiếu với bản gốc trước khi sử dụng.038.1
 WellSaidCông cụ âm thanh AIWellSaid là công cụ âm thanh AI dành cho các nhóm doanh nghiệp, chủ yếu dùng để chuyển kịch bản văn bản thành giọng lồng tiếng. Sản phẩm cung cấp hơn 120 giọng AI, với các mô hình giọng được xây dựng từ bản ghi âm có sự cấp phép của diễn viên lồng tiếng chuyên nghiệp, phù hợp cho quy trình sản xuất nội dung đào tạo, tiếp thị, quảng cáo và phát triển sản phẩm. Người dùng có thể chọn giọng, điều chỉnh cách phát âm và sử dụng thư viện phát âm để xử lý tên thương hiệu, thuật ngữ và từ viết tắt; các nhóm cũng có thể quản lý dự án và tài nguyên giọng trong không gian dùng chung. WellSaid đồng thời cung cấp API và hỗ trợ sử dụng trong các phần mềm như Adobe Premiere Pro. Khi sử dụng thực tế, các thuật ngữ phức tạp, ngữ điệu và ngữ cảnh vẫn cần được nghe thử và kiểm tra thủ công.038.1
 SpotScribeCông cụ âm thanh AISpotScribe là công cụ chuyển âm thanh thành văn bản, tập trung vào việc chép lời podcast. Công cụ hỗ trợ liên kết từ Spotify, Apple Podcasts, YouTube và TikTok, đồng thời cho phép tải lên các tệp âm thanh, video trên thiết bị. Sau khi dán liên kết hoặc tải tài liệu lên, người dùng có thể nhận bản chép lời đầy đủ, bản tóm tắt AI và đặt câu hỏi về nội dung từng tập. Kết quả có thể được sao chép và xuất ra các định dạng PDF, DOCX, SRT và TXT, thuận tiện cho việc tiếp tục sử dụng trong ghi chú, phụ đề, biên tập, viết bài và lưu trữ tài liệu. Công cụ phù hợp với nhà sáng tạo nội dung, người vận hành podcast, nhà nghiên cứu và người học khi xử lý tư liệu phỏng vấn, khóa học, chương trình và video ngắn. Bản tóm tắt AI, phần hỏi đáp và kết quả chép lời vẫn nên được đối chiếu thủ công với âm thanh gốc trước khi dùng cho việc xuất bản chính thức hoặc trích dẫn nghiên cứu.077.8
 CleanvoiceCông cụ âm thanh AICleanvoice là công cụ làm sạch âm thanh bằng AI dành cho podcaster và nhà sáng tạo nội dung âm thanh, chủ yếu dùng để xử lý các từ đệm, tiếng ồn nền, khoảng ngắt quá dài, tạp âm miệng và tiếng thở trong bản ghi. Sau khi tải bản ghi lên, người dùng có thể thực hiện bước làm sạch ban đầu thông qua quy trình tự động và xử lý các rãnh âm thanh riêng của nhiều khách mời. Sản phẩm cũng hỗ trợ tạo bản tóm tắt podcast, ghi chú chương và nội dung quảng bá trên mạng xã hội. Công cụ phù hợp với podcast, sách nói, video, khóa học và bản ghi cuộc họp, đồng thời có thể được kỹ sư âm thanh sử dụng để hỗ trợ cắt thô. Việc tự động nhận diện và loại bỏ nội dung có thể làm thay đổi giọng điệu, nhịp ngắt hoặc cách diễn đạt, vì vậy vẫn cần kiểm tra thủ công trước khi phát hành chính thức.038.6
 Amadeus CodeCông cụ âm thanh AIAmadeus Code là công cụ sáng tác nhạc AI dành cho các nhà sáng tạo âm nhạc, chủ yếu được dùng để tạo cảm hứng giai điệu và bản nháp bài hát. Người dùng có thể lựa chọn theo phong cách, nhịp điệu, cảm xúc hoặc hợp âm để hệ thống tạo ra những giai điệu chính mới, sau đó liên tục sàng lọc giữa các phương án khác nhau. Nội dung được tạo có thể xuất dưới dạng tệp MIDI, thuận tiện cho việc tiếp tục phối khí và chỉnh sửa trong máy trạm âm thanh kỹ thuật số (DAW). Công cụ phù hợp với người viết nhạc, nghệ sĩ độc lập, nhà sáng tạo nội dung video và những người yêu âm nhạc muốn thử sáng tác bằng AI, nhằm vượt qua bế tắc sáng tạo, xây dựng khung bài hát hoặc ghi lại ý tưởng ban đầu. Cần lưu ý rằng công cụ thiên về hỗ trợ giai điệu và tạo bản nháp, không phải dịch vụ tự động hoàn thành toàn bộ bài hát chỉ bằng một thao tác; người dùng vẫn cần chỉnh sửa và sản xuất thủ công ở các bước tiếp theo.038.5
 Musicfy AICông cụ âm thanh AIMusicfy AI là công cụ âm thanh AI phục vụ sáng tác âm nhạc và sản xuất nội dung âm thanh. Người dùng có thể tải lên mẫu giọng nói để tạo mô hình giọng nói AI cá nhân, sau đó dùng cho chuyển đổi giọng nói và hát cover; đồng thời có thể tạo nhạc với giai điệu và phần đệm từ văn bản hoặc mô tả cảm xúc, cũng như chuyển tiếng ngân nga thành âm thanh nhạc cụ. Nền tảng còn cung cấp thư viện ca sĩ AI và thư viện tài nguyên, phù hợp với nhà sản xuất âm nhạc, nhà sáng tạo nội dung, người dùng mạng xã hội và những ai muốn thử sức với sáng tác âm nhạc. Công cụ giúp đơn giản hóa quy trình từ ý tưởng đến bản nháp âm thanh, nhưng người dùng vẫn cần tự xác nhận quyền sử dụng và quy định của nền tảng trước khi dùng giọng nói của người khác hoặc đăng tải nội dung được tạo ra.018.4
 JoyCastCông cụ âm thanh AIJoyCast là công cụ cải thiện âm thanh bằng AI dành cho MacBook, chủ yếu được dùng để nâng cao chất lượng thu giọng nói từ mic tích hợp. Khi sử dụng, công cụ hoạt động như một đầu vào âm thanh cấp hệ thống: trước tiên khử tiếng ồn từ mic, sau đó cung cấp âm thanh cho các phần mềm họp video, phát trực tiếp hoặc ghi âm. Tài liệu liệt kê các trường hợp sử dụng như Zoom, Google Meet, Slack và OBS, phù hợp với các nhà sáng lập thường xuyên làm việc từ xa, nhà sáng tạo nội dung và giảng viên trực tuyến. Mô tả sản phẩm cho biết quá trình xử lý âm thanh được thực hiện trên thiết bị và hỗ trợ chip Apple Silicon. Cần lưu ý rằng tài liệu hiện có chủ yếu tập trung vào mic tích hợp trên MacBook, chưa nêu rõ phạm vi tương thích với Windows, mic ngoài hoặc các thiết bị khác; hiệu quả khử tiếng ồn cụ thể cũng chịu ảnh hưởng bởi môi trường và điều kiện thu âm.017.3
 MurfCông cụ âm thanh AIMurf là nền tảng sáng tạo âm thanh AI, chủ yếu dùng để chuyển kịch bản văn bản thành giọng nói và lồng tiếng cho video, bản trình chiếu cùng các nội dung khác. Người dùng có thể chọn giọng, điều chỉnh tốc độ nói và khoảng dừng ngay trên nền tảng, sau đó kết hợp đồng bộ âm thanh và video với nhạc nền để hoàn thiện sản phẩm. Nền tảng cũng cung cấp khả năng nhân bản giọng nói, chuyển đổi giọng, lồng tiếng dịch thuật và API. Murf phù hợp với các nhóm marketing và đào tạo doanh nghiệp, nhà sáng tạo nội dung, chuyên gia giáo dục và nhà phát triển cần tích hợp tính năng tương tác bằng giọng nói. Murf cung cấp cả hình thức sử dụng miễn phí và trả phí, nhưng hạn mức, chất lượng giọng nói và quyền sử dụng tính năng cụ thể cần căn cứ theo gói hiện tại; nội dung được tạo vẫn nên được kiểm tra thủ công.038.5
 AI-songCông cụ âm thanh AIAI-song là công cụ âm thanh AI, chủ yếu dùng để chuyển mô tả ngắn, lời bài hát hoặc ý tưởng sáng tác nhạc cụ thành ca khúc. Sau khi nhập văn bản hoặc lời bài hát, người dùng có thể chọn các phong cách như pop, rock, cổ điển hoặc điện tử để tạo tệp âm thanh hoàn chỉnh dài tối đa khoảng ba phút và xuất ở định dạng MP3. Công cụ phù hợp với nhà sáng tạo video ngắn, nhà phát triển game độc lập, nhà sản xuất podcast và người yêu nhạc không có kinh nghiệm về lý thuyết âm nhạc hay phối khí, phục vụ việc tạo nhạc nền, nhạc mở đầu, nhạc kết thúc hoặc tác phẩm cá nhân. Tốc độ tạo và chất lượng thành phẩm sẽ phụ thuộc vào nội dung nhập vào và thiết lập phong cách. Trước khi sử dụng cho dự án chính thức, bạn vẫn nên nghe thử, điều chỉnh và xác nhận các điều khoản cấp phép hiện hành.047.4
 MusicLMCông cụ âm thanh AIMusicLM là mô hình trí tuệ nhân tạo dành cho việc tạo nhạc, chủ yếu tạo ra âm nhạc phù hợp với bối cảnh, cảm xúc và phong cách dựa trên mô tả văn bản. Mô hình cũng hỗ trợ phối lại theo phong cách dựa trên giai điệu được ngân nga, huýt sáo hoặc chơi bằng nhạc cụ. Người dùng có thể nhập chủ đề âm nhạc, cách phối khí hoặc yêu cầu về biến đổi theo thời gian để nhận bản nháp âm thanh tương ứng, phục vụ việc hình thành ý tưởng, thử nghiệm nhạc nền và nghiên cứu. Các tài liệu công khai cũng giới thiệu chế độ câu chuyện, khả năng tạo nhạc dài và bộ dữ liệu MusicCaps. Khi sử dụng thực tế, kết quả tạo ra vẫn cần được con người chọn lọc về chi tiết, cấu trúc và khả năng sử dụng; phạm vi cấp phép và sử dụng thương mại cũng cần được xác nhận riêng.028
 SpotiguessCông cụ âm thanh AISpotiguess là nền tảng đố vui đoán bài hát cá nhân hóa dựa trên Spotify, dành cho những người muốn kiểm tra trí nhớ âm nhạc, tổ chức hoạt động tương tác về âm nhạc hoặc thử thách xoay quanh một nghệ sĩ cụ thể. Người chơi có thể chọn nghệ sĩ, playlist hoặc các bài hát đã lưu làm nguồn câu hỏi, hoặc sử dụng chế độ AI để tạo nội dung theo chủ đề, sau đó chọn cách trả lời tự động hoặc thủ công. Nền tảng cũng cung cấp chế độ đối đầu nhiều người chơi. Spotiguess phù hợp để người dùng Spotify chơi cá nhân, đồng thời có thể dùng trong các buổi gặp mặt bạn bè và hoạt động ôn tập khi học âm nhạc. Trải nghiệm thực tế phụ thuộc vào dữ liệu Spotify và lịch sử nghe cá nhân; mức độ phù hợp của câu hỏi với sở thích sẽ khác nhau tùy nội dung trong từng tài khoản.087.6
 Exemplary AICông cụ âm thanh AIExemplary AI là công cụ âm thanh AI dành cho nhà sáng tạo nội dung, đồng thời hỗ trợ xử lý nội dung video. Sau khi tải lên tệp âm thanh hoặc video, người dùng có thể tạo bản chép lời và phụ đề, rồi dựa trên văn bản để tạo bản tóm tắt, bài viết blog, nội dung theo chương và bài đăng mạng xã hội, cũng như trích xuất các đoạn video ngắn từ video dài. Công cụ còn hỗ trợ dịch phụ đề sang hơn 120 ngôn ngữ, chỉnh sửa video bằng văn bản và trò chuyện AI về nội dung bản chép lời. Công cụ phù hợp với nhà sáng tạo podcast và video, nhà báo, nhân viên tiếp thị và các tổ chức giáo dục, đào tạo, giúp giảm công việc biên tập lặp lại từ bản ghi âm, ghi hình đến tài liệu xuất bản. Kết quả chép lời, dịch thuật và tự động tạo vẫn cần được kiểm tra thủ công; thuật ngữ chuyên ngành, tên riêng và cách diễn đạt theo ngữ cảnh đặc biệt cần được rà soát.038.9
 Xingzhe AICông cụ âm thanh AIXingzhe AI là công cụ âm thanh AI dành cho ngành game và giải trí, đồng thời cung cấp các năng lực tổng hợp liên quan đến sản xuất nội dung. Người dùng có thể sáng tác lời, sáng tác nhạc, tổng hợp giọng hát và sản xuất nhạc nền, kết hợp với các khả năng vẽ tranh, tác nhân thông minh và bảo mật nội dung của nền tảng để hoàn thiện một số quy trình sản xuất nội dung game và giải trí. Sản phẩm phù hợp với đội ngũ phát triển game, giảng viên âm nhạc, nhà sáng tạo độc lập và nhân sự vận hành nội dung giải trí, bao phủ các tình huống như sản xuất âm nhạc, hỗ trợ giảng dạy và chuẩn bị nội dung quảng bá. Nền tảng đồng thời cung cấp chế độ miễn phí và trả phí; các tính năng khả dụng cụ thể có thể thay đổi tùy phiên bản hoặc phạm vi dịch vụ. Nội dung do AI tạo vẫn cần được kiểm tra thủ công, đồng thời phải hoàn tất việc xác minh tuân thủ và bản quyền theo yêu cầu phát hành thực tế.087.8
 boomyCông cụ âm thanh AIboomy là công cụ tạo nhạc AI cung cấp cả gói miễn phí và trả phí, hướng đến người dùng phổ thông không có nền tảng nhạc lý, nhà sáng tạo nội dung, nghệ sĩ độc lập và nhà phát triển trò chơi. Người dùng có thể chọn phong cách âm nhạc trước để hệ thống tạo bài hát, sau đó điều chỉnh trống, bass, giai điệu, nhịp điệu và cấu trúc, đồng thời thêm giọng hát đã thu hoặc tải lên. Sau khi hoàn tất, tác phẩm có thể được phân phối qua nền tảng đến các dịch vụ phát trực tuyến như Spotify và Apple Music. Công cụ phù hợp để nhanh chóng tạo nhạc nền, bản nháp ý tưởng hoặc bài hát cá nhân, nhưng kết quả tạo ra vẫn cần được nghe thử và chỉnh sửa thủ công. Điều kiện phân phối, phạm vi cấp phép và quy định doanh thu cụ thể cần được căn cứ vào điều khoản của nền tảng và dịch vụ liên quan.027.4
 VideoSDKCông cụ âm thanh AIVideoSDK là hạ tầng giao tiếp video, âm thanh thời gian thực và giọng nói AI dành cho nhà phát triển. Nền tảng cung cấp SDK đa nền tảng và REST API, giúp các đội ngũ tích hợp cuộc gọi video, cuộc gọi âm thanh, phát trực tiếp tương tác, chuyển lời nói thành văn bản theo thời gian thực, ghi hình và tác nhân giọng nói AI vào website, ứng dụng di động hoặc các sản phẩm phần mềm khác. VideoSDK hỗ trợ các môi trường phát triển như JavaScript, React, React Native, Android, iOS, Flutter, Unity và Python, đồng thời có thể kết nối với hệ thống điện thoại SIP. Sản phẩm phù hợp với các lĩnh vực như giáo dục trực tuyến, y tế từ xa, xác minh danh tính qua video, thương mại điện tử phát trực tiếp, sự kiện ảo và chăm sóc khách hàng bằng giọng nói. Người sử dụng cần có năng lực phát triển phần mềm; việc triển khai tính năng vẫn cần tự xử lý quy trình nghiệp vụ, quyền hạn và trải nghiệm trên thiết bị đầu cuối.047.9
 Mix AudioCông cụ âm thanh AIMix Audio là công cụ âm thanh AI dành cho nhà sáng tạo âm nhạc, người làm podcast, người mới bắt đầu với âm thanh và nhà giáo dục, kết hợp khả năng hòa âm tự động, chỉnh sửa âm thanh và tạo nhạc. Người dùng có thể nhập hoặc cung cấp văn bản, hình ảnh, âm thanh và các tài liệu khác, sử dụng AI để điều chỉnh âm lượng, bộ cân bằng, nén động và hiệu ứng, hoặc tạo nhạc nền hay bản phối lại, sau đó xử lý thêm bằng các cài đặt sẵn. Công cụ cũng hỗ trợ cộng tác trực tuyến nhiều người, phù hợp cho sáng tác cá nhân, sản xuất nội dung và giảng dạy âm thanh. Có cả hình thức miễn phí và trả phí, nhưng kết quả xử lý tự động vẫn cần được nghe thử và điều chỉnh dựa trên từng tài liệu cụ thể.038.5
 DeepBeatCông cụ âm thanh AIDeepBeat là công cụ âm thanh AI dành cho sáng tác rap, bắt nguồn từ một dự án học thuật của các nhà nghiên cứu Phần Lan. Công cụ chủ yếu sử dụng học máy để tạo lời bài hát và đưa ra gợi ý về vần. Người dùng có thể nhập từ khóa để tạo một đoạn hoàn chỉnh chỉ bằng một cú nhấp, hoặc chọn nhận gợi ý câu tiếp theo hay câu có vần theo từng dòng. Khi khả dụng, người dùng cũng có thể bật chế độ học sâu để thử cải thiện tính logic và cốt truyện của lời bài hát. Công cụ phù hợp với người yêu rap, nhà sáng tác, nhà sản xuất âm nhạc và những người viết cần cảm hứng về vần điệu. Hiện công cụ được cung cấp miễn phí, nhưng nội dung tạo ra vẫn cần được chỉnh sửa thủ công dựa trên chủ đề, nhịp điệu và cách thể hiện cá nhân, không nên xem ngay là lời bài hát hoàn chỉnh.028.5
 ecrett musicCông cụ âm thanh AIecrett music là công cụ âm thanh AI dành cho nhà sáng tạo nội dung, chủ yếu dùng để tạo nhạc nền cho video, trò chơi, podcast, quảng cáo và các dự án phim độc lập. Người dùng chọn bối cảnh, cảm xúc và thể loại âm nhạc, sau đó hệ thống sẽ tạo giai điệu. Tiếp theo, người dùng có thể điều chỉnh nhạc cụ và cấu trúc âm nhạc, tải video lên để xem trước độ phù hợp giữa âm thanh và hình ảnh, rồi tải xuống tệp âm thanh WAV. Công cụ phù hợp với nhà sáng tạo cá nhân và nhóm nhỏ không có kỹ năng sáng tác nhưng cần nhanh chóng hoàn thiện bản nhạc nền ban đầu. Công cụ cũng cung cấp mục yêu thích và lịch sử sáng tác để hỗ trợ sắp xếp tư liệu. Sản phẩm có mô hình miễn phí và trả phí. Thông tin trên trang mô tả nhạc được tạo là miễn phí bản quyền, nhưng phạm vi sử dụng thương mại, điều khoản cấp phép và giới hạn tải xuống thực tế vẫn cần được xác nhận theo quy định dịch vụ hiện hành.018.2
 Cartesia AICông cụ âm thanh AICartesia AI là công cụ âm thanh AI dành cho tương tác bằng giọng nói theo thời gian thực, với khả năng cốt lõi là chuyển văn bản thành giọng nói có biểu cảm như thay đổi cảm xúc, hơi thở và tiếng cười tự nhiên. Người dùng có thể thử nghiệm kết quả tạo giọng trong Playground, hoặc tích hợp khả năng giọng nói vào tác nhân, dịch vụ khách hàng, trò chơi và các ứng dụng khác thông qua API hoặc SDK. Nền tảng hỗ trợ hơn 42 ngôn ngữ và cung cấp các tùy chọn nhân bản giọng nói từ nhân bản tức thì đến tinh chỉnh cấp chuyên nghiệp. Công cụ phù hợp với nhà phát triển, doanh nghiệp và đội ngũ sản xuất nội dung cần phản hồi bằng giọng nói với độ trễ thấp. Hiệu quả thực tế vẫn chịu ảnh hưởng của văn bản, ngôn ngữ, thiết lập cảm xúc và chất lượng mẫu âm thanh, vì vậy cần thử nghiệm trong bối cảnh mục tiêu trước khi tích hợp.088
 CurseCutCông cụ âm thanh AICurseCut là công cụ AI dành cho kiểm duyệt nội dung video và âm thanh, có thể tự động nhận diện lời nói không phù hợp trong tệp phương tiện, sau đó tắt tiếng, chèn tiếng bíp hoặc thay thế bằng hiệu ứng âm thanh tùy chỉnh theo thiết lập của người dùng. Người dùng có thể tạo thư viện từ khóa lọc, chọn phương thức xử lý rồi nhập một hoặc nhiều tệp để xử lý, sau đó kiểm tra kết quả qua bản ghi văn bản có dấu thời gian. Công cụ hỗ trợ hơn 30 ngôn ngữ, phù hợp với nhà sáng tạo nội dung, phụ huynh và nhà giáo dục, doanh nghiệp cũng như các nhóm truyền thông trong việc chỉnh sửa video, podcast, bản ghi phát trực tiếp và tài liệu đào tạo. Quy trình xử lý diễn ra trên thiết bị cục bộ, tệp không được tải lên đám mây; tuy nhiên, người dùng cần tự thiết lập tiêu chuẩn lọc và vẫn nên kiểm tra kết quả tự động trước khi đăng hoặc sử dụng.038.5
 Azure AI SpeechCông cụ âm thanh AIAzure AI Speech là dịch vụ giọng nói AI trên đám mây do Microsoft Azure cung cấp, dành cho các đội ngũ phát triển và doanh nghiệp cần tích hợp khả năng xử lý giọng nói vào ứng dụng hoặc quy trình kinh doanh. Người dùng có thể xử lý âm thanh thông qua API hoặc SDK, chuyển giọng nói thành văn bản, dịch nội dung hoặc tổng hợp văn bản thành giọng nói, đồng thời kết hợp nhận dạng người nói, đánh giá phát âm và mô hình tùy chỉnh để thực hiện các tác vụ chuyên biệt hơn. Dịch vụ hỗ trợ phiên âm theo thời gian thực và theo lô, phù hợp với các lĩnh vực như trung tâm cuộc gọi, xử lý nội dung truyền thông, học ngôn ngữ, tài chính và y tế. Phạm vi tính năng khá rộng, nhưng việc tích hợp thực tế vẫn cần phát triển giao diện, cấu hình mô hình và kiểm thử hiệu quả; hạn mức sử dụng và chi phí cần được tham chiếu theo quy định dịch vụ hiện hành của Azure.018.5
 MelodyStudioCông cụ âm thanh AIMelodyStudio là công cụ âm thanh AI tập trung vào sáng tác giai điệu, chủ yếu hỗ trợ người dùng khám phá những giai điệu có thể hát từ lời bài hát. Sau khi người dùng nhập hoặc dán lời bài hát, công cụ sẽ phân tích số lượng âm tiết trong từng dòng và tạo nhiều câu giai điệu theo từng dòng. Người dùng có thể kết hợp với các đề xuất hợp âm để nghe thử, lựa chọn, sau đó điều chỉnh nốt nhạc và tiết tấu trong giao diện chỉnh sửa trực quan, rồi xuất giai điệu và hợp âm dưới dạng tệp MIDI. Công cụ phù hợp với nhà sáng tác nhạc, nhà sản xuất, ca sĩ và người mới học nhạc để tìm hướng phát triển giai điệu hoặc sắp xếp tư liệu sáng tác. Kết quả tạo ra vẫn cần được đánh giá và chỉnh sửa thủ công; quá trình phối khí tiếp theo thường cần thực hiện bằng phần mềm sản xuất âm nhạc.038.5
 ResembleCông cụ âm thanh AIResemble là công cụ âm thanh AI dành cho doanh nghiệp và đội ngũ phát triển, hỗ trợ tạo giọng nói, nhân bản giọng nói, chuyển đổi giọng nói và phát hiện deepfake. Người dùng có thể cung cấp mẫu âm thanh để tạo mô hình giọng nói, sau đó tạo nội dung bằng chuyển văn bản thành giọng nói hoặc chuyển giọng nói thành giọng nói; đồng thời sử dụng tính năng chuyển đổi giọng nói theo thời gian thực và chỉnh sửa âm thanh bằng AI để xử lý bản ghi. Nền tảng còn cung cấp khả năng bản địa hóa đa ngôn ngữ và watermark AI, phù hợp với các lĩnh vực như game, giải trí, chăm sóc khách hàng thông minh, phát triển ứng dụng, quảng cáo và tiếp thị. Hiệu quả thực tế phụ thuộc vào chất lượng mẫu âm thanh, ngôn ngữ mục tiêu và cách sử dụng cụ thể. Khi sử dụng giọng nói của người khác, cần xác nhận quyền cho phép và các yêu cầu tuân thủ liên quan.037.3
 SoundfulCông cụ âm thanh AISoundful là công cụ âm thanh ứng dụng trí tuệ nhân tạo, kết hợp tính năng tạo nhạc và thư viện nhạc để cung cấp cho người dùng các tài nguyên nhạc nền. Người dùng có thể chọn thể loại, nhịp điệu, cảm xúc hoặc chủ đề, sau đó tạo bản nhạc và tải xuống hoặc tiếp tục chỉnh sửa khi cần; nền tảng cũng có nhạc do các nhà sáng tạo chia sẻ. Nội dung bao gồm các phong cách như EDM, Deep House và Hip Hop, phù hợp với nhà sáng tạo nội dung, nhà sản xuất âm nhạc, thương hiệu, doanh nghiệp và người yêu thích cá nhân, dùng cho video, podcast, livestream, quảng cáo, trò chơi hoặc sáng tác cá nhân. Một số gói hỗ trợ tải xuống âm thanh MP3, WAV và các khả năng sản xuất nâng cao như tách STEM và tệp MIDI. Nền tảng cung cấp các tùy chọn miễn phí và trả phí; quyền tải xuống và tính năng khả dụng có thể khác nhau tùy gói. Trước khi sử dụng cho mục đích thương mại chính thức, nên kiểm tra các điều khoản cấp phép tương ứng.058
 DubbingX智声云配Công cụ âm thanh AIDubbingX智声云配 là công cụ âm thanh AI, chủ yếu dùng cho lồng tiếng văn bản, nhân bản giọng nói và chuyển đổi giọng nói hoặc giọng hát. Người dùng có thể nhập văn bản, chọn giọng và cảm xúc trên nền tảng web, ứng dụng máy tính, phiên bản Mac hoặc mini program WeChat, đồng thời điều chỉnh thêm các thông số như tốc độ nói, ngữ điệu, cách đọc chữ đa âm và khoảng ngắt; doanh nghiệp cũng có thể tích hợp các tính năng liên quan qua API. Sản phẩm hướng đến các trường hợp sử dụng như sản xuất nội dung game, anime, điện ảnh và truyền hình, phim ngắn, sách nói, podcast, người ảo, phần cứng thông minh và quảng cáo. Nền tảng cung cấp cả mô hình miễn phí và trả phí; theo giới thiệu, các giọng đọc chính thức đã có giấy phép sử dụng thương mại. Khi nhân bản bằng âm thanh do người dùng tự tải lên, người dùng vẫn cần xác nhận nguồn mẫu và các quyền cấp phép liên quan.048.5
 MuseNetCông cụ âm thanh AIMuseNet là mô hình tạo nhạc bằng AI do OpenAI phát triển. Dựa trên kiến trúc Transformer, mô hình học từ một lượng lớn tệp nhạc MIDI để tạo ra các bản nhạc có sự biến đổi về hòa âm, nhịp điệu và phong cách. Người dùng có thể nghe các bản phối được tạo sẵn ở chế độ đơn giản hoặc bắt đầu từ một nốt nhạc ở chế độ nâng cao để từng bước hướng dẫn mô hình hoàn thiện đoạn nhạc. Công cụ hỗ trợ mô phỏng và kết hợp nhiều phong cách cổ điển, nhạc pop và các thể loại phổ biến, đồng thời cho phép chỉ định tối đa 10 nhạc cụ để hòa tấu. MuseNet phù hợp với nhà sáng tác nhạc, chuyên gia viết nhạc phim, nhà giáo dục, nhà nghiên cứu và người yêu nhạc, phục vụ việc khám phá ý tưởng, hỗ trợ phối khí, minh họa giảng dạy và phác thảo nhạc nền. Nội dung được tạo vẫn cần được con người chọn lọc và điều chỉnh, không thể thay thế toàn bộ quy trình sáng tác, phối khí và sản xuất âm nhạc.048.1
 NeverCapCông cụ âm thanh AINeverCap là một công cụ âm thanh AI, chủ yếu dùng để chuyển âm thanh hoặc video thành văn bản và dịch nội dung bản chép lời sang nhiều ngôn ngữ. Người dùng có thể tải lên các tệp như MP3, MP4, xử lý tối đa 50 tệp mỗi lần, mỗi tệp dài tối đa 10 giờ hoặc không quá 5GB, sau đó xuất kết quả dưới dạng PDF, Word hoặc SRT. Công cụ hỗ trợ nhận diện hơn 100 ngôn ngữ và dịch nội dung sang 249 ngôn ngữ, đồng thời cung cấp tính năng nhận diện người nói, sắp xếp dấu câu và đoạn văn. Công cụ phù hợp để sản xuất podcast, tạo phụ đề video,整理 nội dung phỏng vấn, nghiên cứu học thuật và ghi chép bài giảng. Hiệu quả thực tế vẫn có thể bị ảnh hưởng bởi giọng địa phương, tiếng ồn, nhiều người nói cùng lúc và thuật ngữ chuyên ngành; nên kiểm tra lại các nội dung quan trọng trước khi xuất.087.5
 DiffRhythmCông cụ âm thanh AIDiffRhythm là mô hình tạo bài hát bằng AI do Phòng thí nghiệm ASLP thuộc Đại học Bách khoa Tây Bắc phát triển, sử dụng mô hình khuếch tán tiềm ẩn, hướng đến các nhà sáng tạo và nhà phát triển cần nhanh chóng tạo bản nháp âm nhạc, nhạc nền hoặc tiến hành nghiên cứu mô hình. Sau khi người dùng nhập lời bài hát và gợi ý phong cách, công cụ có thể tạo bài hát hoàn chỉnh gồm giọng hát và phần nhạc đệm, với thời lượng tối đa mỗi lần tạo khoảng 4 phút 45 giây, hỗ trợ bài hát tiếng Trung và tiếng Anh. Dự án cung cấp mô hình mã nguồn mở và mã suy luận, phù hợp để trải nghiệm, nghiên cứu và phát triển thêm. Kết quả tạo ra vẫn có thể cần được chọn lọc, chỉnh sửa hoặc hậu kỳ thủ công; hiệu quả thực tế cũng chịu ảnh hưởng bởi lời bài hát và gợi ý phong cách.018.5
 SAM AudioCông cụ âm thanh AISAM Audio là công cụ tách âm thanh bằng AI do Meta phát triển, dùng để trích xuất nguồn âm thanh cụ thể từ bản ghi âm hoặc âm thanh video bị trộn. Người dùng có thể nhập mô tả bằng ngôn ngữ tự nhiên về âm thanh mục tiêu, nhấp vào vật thể liên quan trong khung hình video hoặc đánh dấu khoảng thời gian cần xử lý để nhận kết quả tách tương ứng. Công cụ phù hợp với nhà sáng tạo video, nhà sản xuất âm nhạc, người làm podcast và nội dung có lời, cũng như những người nghiên cứu lĩnh vực hiểu âm thanh, nhằm trích xuất giọng nói, nhạc cụ, âm thanh môi trường và các âm thanh cụ thể khác. Sản phẩm hiện được đánh dấu là miễn phí và đang hoạt động. Hiệu quả thực tế phụ thuộc vào môi trường ghi âm, mức độ chồng lấn giữa các nguồn âm thanh và độ chính xác của mô tả gợi ý;素材 phức tạp vẫn cần được kiểm tra thủ công và chỉnh sửa hậu kỳ.038.4
 Vạn Tượng Hữu ThanhCông cụ âm thanh AIVạn Tượng Hữu Thanh là công cụ âm thanh trí tuệ nhân tạo dành cho nhà sáng tạo nội dung âm thanh, hỗ trợ các khâu biên tập kịch bản, ghi âm lồng tiếng, chỉnh sửa âm thanh, đối khớp lời thoại và thẩm định thành phẩm. Người dùng có thể sắp xếp văn bản dài thành từng chương, trích xuất nhân vật và tạo tiểu sử nhân vật, sau đó hoàn tất quá trình sản xuất âm thanh bằng hệ thống ghi âm và chỉnh sửa. Cuối cùng, chức năng thẩm định giúp kiểm tra tính nhất quán giữa âm thanh và bản thảo. Nền tảng phù hợp với studio sản xuất âm thanh, nhà sáng tạo podcast và nội dung cá nhân, các đơn vị MCN cũng như người yêu thích kịch phát thanh. Nền tảng hỗ trợ cả sản xuất bằng máy móc lẫn phương thức có sự tham gia của con người. Một số nội dung vẫn cần được kiểm tra thủ công, đặc biệt là cách thể hiện nhân vật, xử lý cảm xúc, cách đọc chữ hiếm gặp và chất lượng thành phẩm cuối cùng.058.1
 TopMediaiCông cụ âm thanh AITopMediai là công cụ âm thanh AI, chủ yếu dùng để chuyển văn bản thành giọng nói, tạo nhạc, nhân bản giọng nói và hát lại bài hát bằng AI, đồng thời cung cấp các khả năng liên quan đến tạo video. Người dùng có thể bắt đầu từ văn bản, lời bài hát hoặc mô tả ý tưởng sáng tạo, lựa chọn hiệu ứng giọng nói hoặc âm nhạc để tạo lồng tiếng, bài hát và các tài sản đa phương tiện khác. Nền tảng hướng đến nhà sáng tạo video, nhà phát triển trò chơi, nhân viên marketing, nhà sản xuất podcast và giáo viên. Theo thông tin hiện có, nền tảng hỗ trợ cả hình thức sử dụng miễn phí và trả phí, đồng thời đang hoạt động. Thành phẩm vẫn cần được kiểm tra thủ công về phát âm, cảm xúc và mức độ phù hợp của nội dung; khi nhân bản giọng nói, hát lại bài hát hoặc công bố sản phẩm, cũng cần xác nhận các quyền sử dụng liên quan.028
 Online AudioCông cụ âm thanh AIOnline Audio là công cụ chuyển đổi âm thanh trực tuyến hoạt động trên trình duyệt, dành cho người dùng cá nhân, nhà sáng tạo nội dung và nhân viên văn phòng cần xử lý tệp âm thanh, video. Sau khi tải tệp lên, người dùng chọn định dạng đầu ra, có thể điều chỉnh các thông số như bitrate, tốc độ lấy mẫu và kênh âm thanh, rồi tải kết quả chuyển đổi xuống; nhiều tệp có thể được xử lý cùng lúc và đóng gói thành ZIP. Công cụ hỗ trợ hơn 300 định dạng tệp, có thể trích xuất track âm thanh từ video, đồng thời cung cấp tính năng chỉnh sửa thẻ và một số hiệu ứng âm thanh. Công cụ phù hợp với các tác vụ như xử lý tệp không tương thích định dạng, sắp xếp tư liệu và chỉnh sửa âm thanh cơ bản. Vì tệp cần được tải lên trang web để xử lý, người dùng nên cân nhắc tình trạng mạng và kích thước tệp khi sắp xếp quy trình.027.3
 Lyria2Công cụ âm thanh AILyria2 là mô hình tạo nhạc bằng AI do Google DeepMind phát triển, phục vụ nhà sản xuất âm nhạc, nhạc sĩ, nhà phát triển, nhà sáng tạo nội dung và người yêu nhạc. Người dùng có thể nhập lời bài hát hoặc câu lệnh văn bản, thiết lập tốc độ, giọng, nhạc cụ, cảm xúc cùng các tham số cấu trúc như Intro và Outro để tạo bài hát gồm phần nhạc cụ và giọng hát; nhà phát triển cũng có thể dùng Lyria RealTime API để tạo luồng nhạc liên tục. Âm thanh được tạo có chất lượng stereo 48kHz và tích hợp watermark SynthID. Công cụ phù hợp để khám phá ý tưởng, tạo bản demo, làm nhạc cho video và xây dựng nguyên mẫu ứng dụng, nhưng kết quả vẫn cần được kiểm tra thủ công và chỉnh sửa hậu kỳ, đặc biệt về cách thể hiện lời bài hát, chi tiết phối khí và hiệu ứng giọng hát.047.7
 NarakeetCông cụ âm thanh AINarakeet là công cụ âm thanh AI trực tuyến có thể chuyển văn bản, tài liệu hoặc nội dung slide thành video và âm thanh có lời thuyết minh. Người dùng có thể nhập trực tiếp nội dung hoặc tải lên các tệp như PowerPoint, Google Slides để hệ thống trích xuất nội dung và tạo video thuyết minh, giảm công việc ghi âm và đồng bộ thủ công. Sản phẩm hỗ trợ 100 ngôn ngữ và hơn 900 giọng nói AI, phục vụ nhà giáo dục, chuyên viên đào tạo, nhân viên marketing, nhà sáng tạo nội dung và đội ngũ phát triển; đồng thời có thể tích hợp vào quy trình tự động hóa thông qua API. Theo thông tin hiện có, sản phẩm cung cấp các gói miễn phí và trả phí; khi sử dụng thực tế, vẫn cần kiểm tra cách phát âm, ngữ điệu, dòng thời gian và chất lượng video hoàn chỉnh.057.8
 Đậu Ca Lồng TiếngCông cụ âm thanh AIĐậu Ca Lồng Tiếng là công cụ âm thanh AI dành cho nhà sáng tạo video ngắn, chủ yếu dùng để chuyển nội dung văn bản thành lời lồng tiếng, đồng thời hỗ trợ các công đoạn như tạo hội thoại đa nhân vật, tách giọng người và trích xuất nội dung. Người dùng có thể nhập hoặc trích xuất lời thoại, chọn giọng đọc, điều chỉnh tốc độ, ngữ điệu và cảm xúc, sau đó nghe thử trực tuyến và chỉnh sửa tệp âm thanh đã tạo. Công cụ phù hợp với các tình huống như thuyết minh nội dung, câu nói truyền cảm hứng, quảng cáo đọc lời, giáo dục trực tuyến và nội dung âm thanh; đồng thời thích hợp cho nhà sáng tạo cá nhân và nhóm nhỏ cần giọng địa phương, giọng trẻ em hoặc giọng của nhiều nhân vật. Nền tảng cung cấp cả gói miễn phí và trả phí. Khi sử dụng thực tế, với ngữ cảnh phức tạp, từ đa âm và cách thể hiện cảm xúc, người dùng vẫn nên nghe thử và kiểm tra thủ công.067.6PersonaTalkCông cụ âm thanh AIPersonaTalk là một khung lồng tiếng trực quan bằng AI dành cho việc đồng bộ khẩu hình video. Người dùng cung cấp một video có nhân vật và âm thanh mục tiêu, hệ thống sẽ tạo video trong đó khẩu hình khớp với âm thanh mới, đồng thời cố gắng giữ lại phong cách khuôn mặt và đặc điểm nói chuyện của nhân vật gốc. Cơ chế kết xuất khuôn mặt với hai lớp chú ý xử lý riêng vùng môi và các vùng khuôn mặt khác, giúp giữ lại các chi tiết hình ảnh như kết cấu da, lớp trang điểm và giảm hiện tượng răng nhấp nháy. Công cụ này phù hợp với biên dịch phim ảnh, bản địa hóa quảng cáo, giáo dục trực tuyến và các nhà phát triển nhân vật kỹ thuật số. Tài liệu chưa nêu rõ phương thức triển khai, yêu cầu phần cứng hay giới hạn đầu ra cụ thể, vì vậy cần đánh giá thêm tư liệu và điều kiện vận hành dựa trên tài liệu dự án trước khi sử dụng chính thức.038.2
 ListenHubCông cụ âm thanh AIListenHub là công cụ âm thanh AI có thể chuyển đổi nội dung dạng văn bản như liên kết trang web, PDF, Word, TXT hoặc ý tưởng do người dùng nhập thành kịch bản podcast có cấu trúc, sau đó tạo nội dung âm thanh dưới dạng đọc đơn hoặc đối thoại hai người. Nền tảng cũng cung cấp tính năng tạo truyện tranh video, phù hợp với nhà sáng tạo tri thức, người làm nội dung độc lập, nhân viên văn phòng, sinh viên, người học bằng thính giác, cũng như các nhóm đào tạo và tiếp thị doanh nghiệp. Người dùng thường bắt đầu bằng việc nhập tài liệu, sau đó trải qua các bước phân tích nội dung, tạo kịch bản và thể hiện bằng giọng nói để tạo ra nội dung có thể nghe hoặc chia sẻ. Nền tảng hỗ trợ cả gói miễn phí và trả phí, nhưng kết quả tạo ra vẫn cần được kiểm tra và điều chỉnh thủ công dựa trên độ chính xác của nguyên văn, cách diễn đạt và bối cảnh sử dụng.038.6
 MusicFXCông cụ âm thanh AIMusicFX là công cụ âm thanh AI thử nghiệm do Google AI Labs phát triển, dựa trên MusicLM, có khả năng chuyển đổi mô tả bằng văn bản của người dùng về phong cách, cảm xúc hoặc bối cảnh thành các đoạn nhạc. Người dùng nhập lời nhắc để tạo kết quả, đồng thời có thể sử dụng chế độ DJ để thêm nhiều lời nhắc và điều chỉnh theo thời gian thực trọng số pha trộn của từng mô tả. Công cụ hỗ trợ thiết lập thời lượng tối đa 70 giây và phát lặp, phù hợp cho nhà sáng tạo nội dung, người yêu nhạc, DJ và nhà phát triển trong việc khám phá ý tưởng, tạo bản nháp nhạc nền và kiểm chứng khái niệm. Cần lưu ý rằng công cụ chủ yếu hướng đến việc tạo các đoạn nhạc; thời lượng đầu ra ngắn và định vị thử nghiệm khiến nó không thể thay thế trực tiếp quy trình phối khí, sản xuất và hậu kỳ hoàn chỉnh. Việc sử dụng thực tế nội dung được tạo vẫn cần được xem xét theo từng bối cảnh cụ thể.038.5
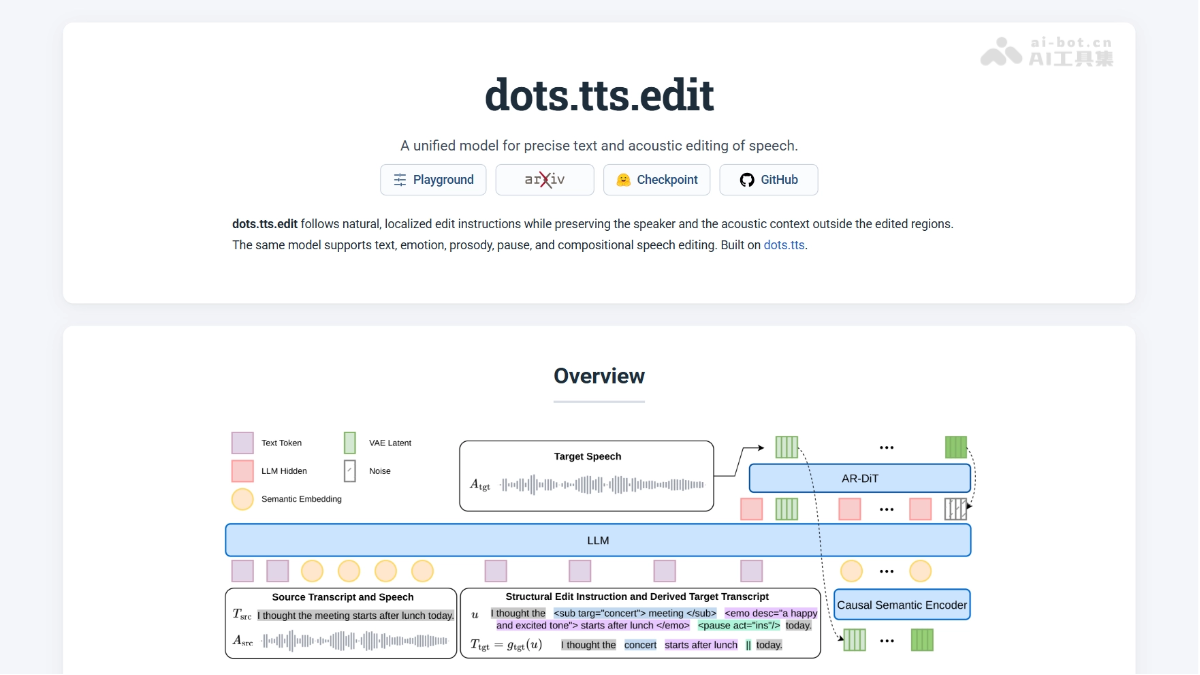 dots.ttsTổng hợp giọng nói AIdots.tts là mô hình nền tảng tổng hợp giọng nói tự hồi quy hoàn toàn liên tục với 2 tỷ tham số, do nhóm dots của Xiaohongshu và phòng thí nghiệm X-LANCE thuộc Đại học Giao thông Thượng Hải cùng mã nguồn mở. Mô hình trực tiếp tạo từng khối âm thanh 48kHz trong không gian ẩn liên tục, đạt...00
 IndexTTS-2.5Tổng hợp giọng nói AIIndexTTS-2.5 là mô hình nhân bản giọng nói zero-shot cấp công nghiệp do Bilibili mã nguồn mở, chỉ có 0.8B tham số, hỗ trợ chuyển đổi liên ngôn ngữ giữa tiếng Trung, tiếng Anh, tiếng Nhật, tiếng Tây Ban Nha và tiếng Ả Rập.00
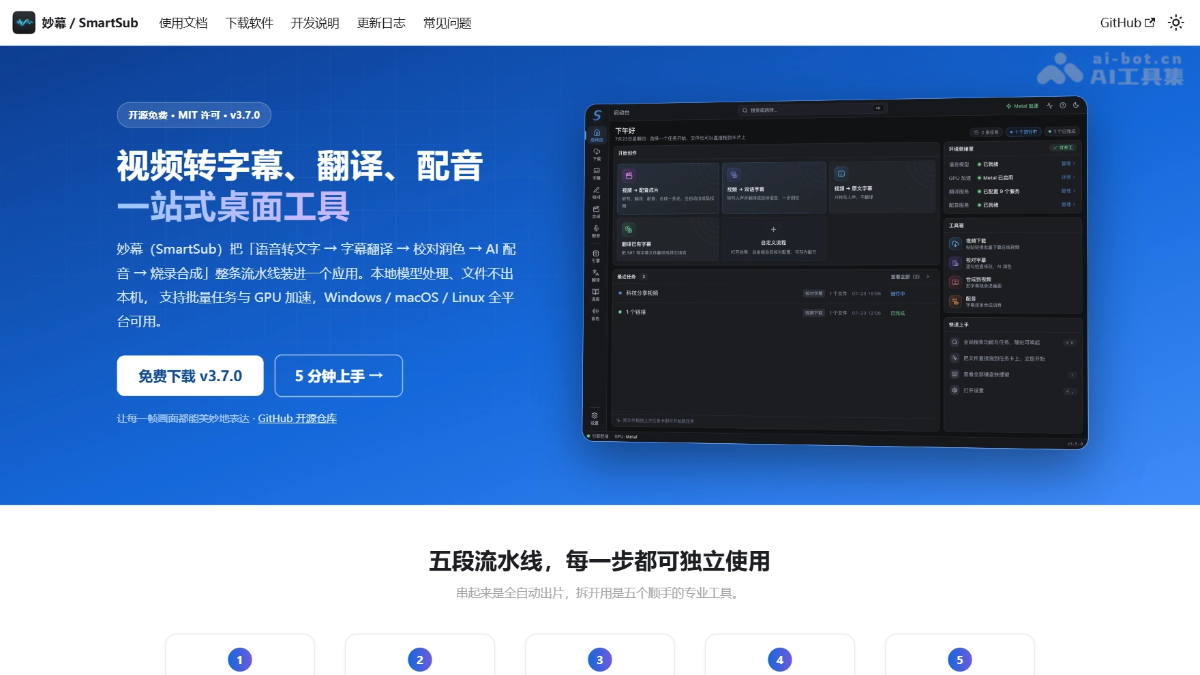 SmartSub – Công cụ desktop mã nguồn mở xử lý phụ đề âm thanh và video tất cả trong mộtNhận diện giọng nói AISmartSub (妙幕) là công cụ desktop mã nguồn mở xử lý phụ đề âm thanh và video tất cả trong một. Công cụ tích hợp toàn bộ quy trình trong một ứng dụng duy nhất, sử dụng các mô hình cục bộ như Whisper, FunASR và Qwen3-ASR để chuyển giọng nói thành văn bản ngoại tuyến, hỗ trợ hơn 20 dịch vụ dịch thuật và lồng tiếng AI đa vai. Tích hợp trình tải video trực tuyến, tương thích với các nền tảng như Bilibili và YouTube, hỗ trợ tăng tốc phần cứng NVIDIA CUDA, Apple Core ML cùng nhiều nền tảng khác, chạy cục bộ trên Windows, macOS và Linux.00
 Hy ASR 3.0 preview – Mô hình nhận dạng giọng nói thế hệ mới do Tencent Hunyuan ra mắtNhận diện giọng nói AIHy ASR 3.0 preview – Mô hình nhận dạng giọng nói thế hệ mới do Tencent Hunyuan ra mắt là hệ thống nhận dạng giọng nói thế hệ mới dựa trên mô hình ngôn ngữ lớn Hy3, kết hợp khả năng nhận dạng giọng nói độ chính xác cao với khả năng hiểu ngữ nghĩa sâu. Mô hình hỗ trợ tiếng Trung, tiếng Anh, tiếng Quảng Đông và 10 khu vực phương ngữ lớn, đồng thời có khả năng tự sửa lỗi thông minh theo ngữ cảnh, chèn từ khóa và hoạt động ổn định trong các bối cảnh phức tạp như môi trường nhiều tạp âm hoặc lời thì thầm. WER trên bộ đánh giá mã nguồn mở được kiểm soát ở mức khoảng 3%, còn trên bộ đánh giá tự xây dựng, mô hình vượt trội đối thủ trên mọi phương diện. Mô hình phù hợp với các tình huống như chăm sóc khách hàng thông minh, sáng tạo nội dung, tìm kiếm bằng giọng nói, cộng tác văn phòng và thiết bị đầu cuối thông minh. Người dùng có thể tích hợp qua API Tencent Cloud hoặc trải nghiệm miễn phí trong Tencent Yuanbao.00
Tất cả công cụ trong danh mục này được hiển thị.