

MACaQ iphrojekthi ye-calibrated quantization engancikile kuhlobo lwemodeli, eyenzelwe ukunciphisa izidingo zememori namandla okubala zamamodeli esimanje e-AI. Isekela izinqubo zombhalo, izithombe, amavidiyo nomsindo nge-llama.cpp, vLLM, Diffusers, kanye ne-PyTorch.
Le phrojekthi igxile kuma-weight nama-activation anokunemba okuphansi, alinganisiwe, kuyilapho igcina ukuhambisana okusebenzayo kwe-inference. Ngokwe-README, i-MACaQ ingalinganisa imodeli enamapharamitha ayizigidi eziyizinkulungwane ezingu-122 ngemizuzu engu-64 isebenzisa imemori yedivayisi engu-32.5 GB. Iphinde ibike i-perplexity ephansi kune-MR-GPTQ ne-DuQuant++ kwezinye iziqhathaniso, noma i-perplexity efanayo ne-Llama-3-8B ngesikhathi esincane kakhulu se-quantization.
Khetha i-backend efanele ye-MACaQ
Qala ngokukhetha i-backend ehambisana nemodeli yakho nalapho uzoyisebenzisa khona. Sebenzisa indawo ehlukile ye-backend ngayinye kanye ne-Python 3.12.
- Diffusers: linganisa amamodeli okukhiqiza izithombe, amavidiyo nomsindo abe ama-checkpoint e-W4A4 safetensors.
- llama.cpp: linganisa amamodeli ombhalo abe amafayela e-GGUF angu-2-, 3-, noma 4-bit futhi uwasebenzise endaweni, kuhlanganise naku-CPU.
- vLLM: linganisa amamodeli ombhalo ukuze akhiqize noma anikeze isevisi ye-HTTP ngamafomethi e-W4A4 noma ama-weight-only.
- PyTorch: linganisa amamodeli okukhiqiza inkulumo abe ama-checkpoint e-W4A4 futhi ukhiqize umsindo we-WAV.
Indawo yokugcina iqukethe imiyalelo ethile ye-backend yokufaka, ukwenza i-calibration, i-quantization, nokukhiqiza. Vula umhlahlandlela we-backend oyikhethile ngaphambi kokuqala:
- Ukufakwa kwe-Diffusers nezinqubo zokusebenza
- Ukufakwa kwe-llama.cpp nezinqubo zokusebenza
- Ukufakwa nokunikezwa kwesevisi nge-vLLM
- Izinqubo zokusebenza kwenkulumo nge-PyTorch
Lungisa indawo yakho yokusebenza
Sebenzisa i-Python 3.12 futhi udale indawo ehlukanisiwe ye-backend ohlela ukuyisebenzisa. Ukugcina izindawo zihlukene kusiza ukugwema ukungqubuzana kokuncika phakathi kwe-llama.cpp, vLLM, Diffusers, ne-PyTorch.
Clone-a indawo yokugcina ye-MACaQ bese ungena kumkhombandlela wayo.
Dala indawo ebonakalayo ye-Python 3.12 ye-backend ekhethiwe.
Landela i-README yaleyo backend ukuze ufake ukuncika kwayo nanoma iyiphi i-runtime edingekayo.
Lungisa imodeli yoqobo, idatha ye-calibration, kanye nomkhombandlela wokuphumayo ochazwe umhlahlandlela we-backend.
Imiyalelo eqondile yokufaka incike ku-backend nasemndenini wemodeli, ngakho sebenzisa i-README exhunywe esikhundleni sokusebenzisa umyalo owodwa ojwayelekile wokufaka kuzo zonke izinqubo.
Linganisa amamodeli akhiqizayo nge-Diffusers
I-backend ye-Diffusers iphatha ama-diffusion transformer futhi igcine ama-checkpoint e-safetensors alinganisiwe. Isekela ukukhiqizwa kwezithombe, amavidiyo, izithombe eziya kumavidiyo, nomsindo.
Indawo yokugcina inikeza izinqubo zamamodeli afaka i-black-forest-labs/FLUX.2-klein-4B, Wan-AI/Wan2.2-TI2V-5B-Diffusers, kanye ne-ylacombe/stable-audio-1.0. Kumamodeli ezithombe eziya kumavidiyo, i-calibration ingasebenzisa izithombe eziqondisayo ukuze inqubo ye-quantization ibonise iphethini yokufaka ehlosiwe.
Vula umhlahlandlela we-Diffusers bese ukhetha inqubo yezithombe, amavidiyo, noma umsindo.
Faka izidingo ze-backend endaweni ezinikele ye-Python 3.12.
Landa noma thola imodeli yomthombo bese ulungisa okokufaka kwe-calibration okudingwa iresiphi ekhethiwe.
Qalisa umyalo we-quantization obhaliwe ukuze ugcine i-checkpoint ye-W4A4 safetensors.
Sebenzisa umyalo wokukhiqiza ohambisanayo ukuze ukhiqize umphumela wesithombe, ividiyo, noma umsindo.
Linganisa amamodeli ombhalo nge-llama.cpp
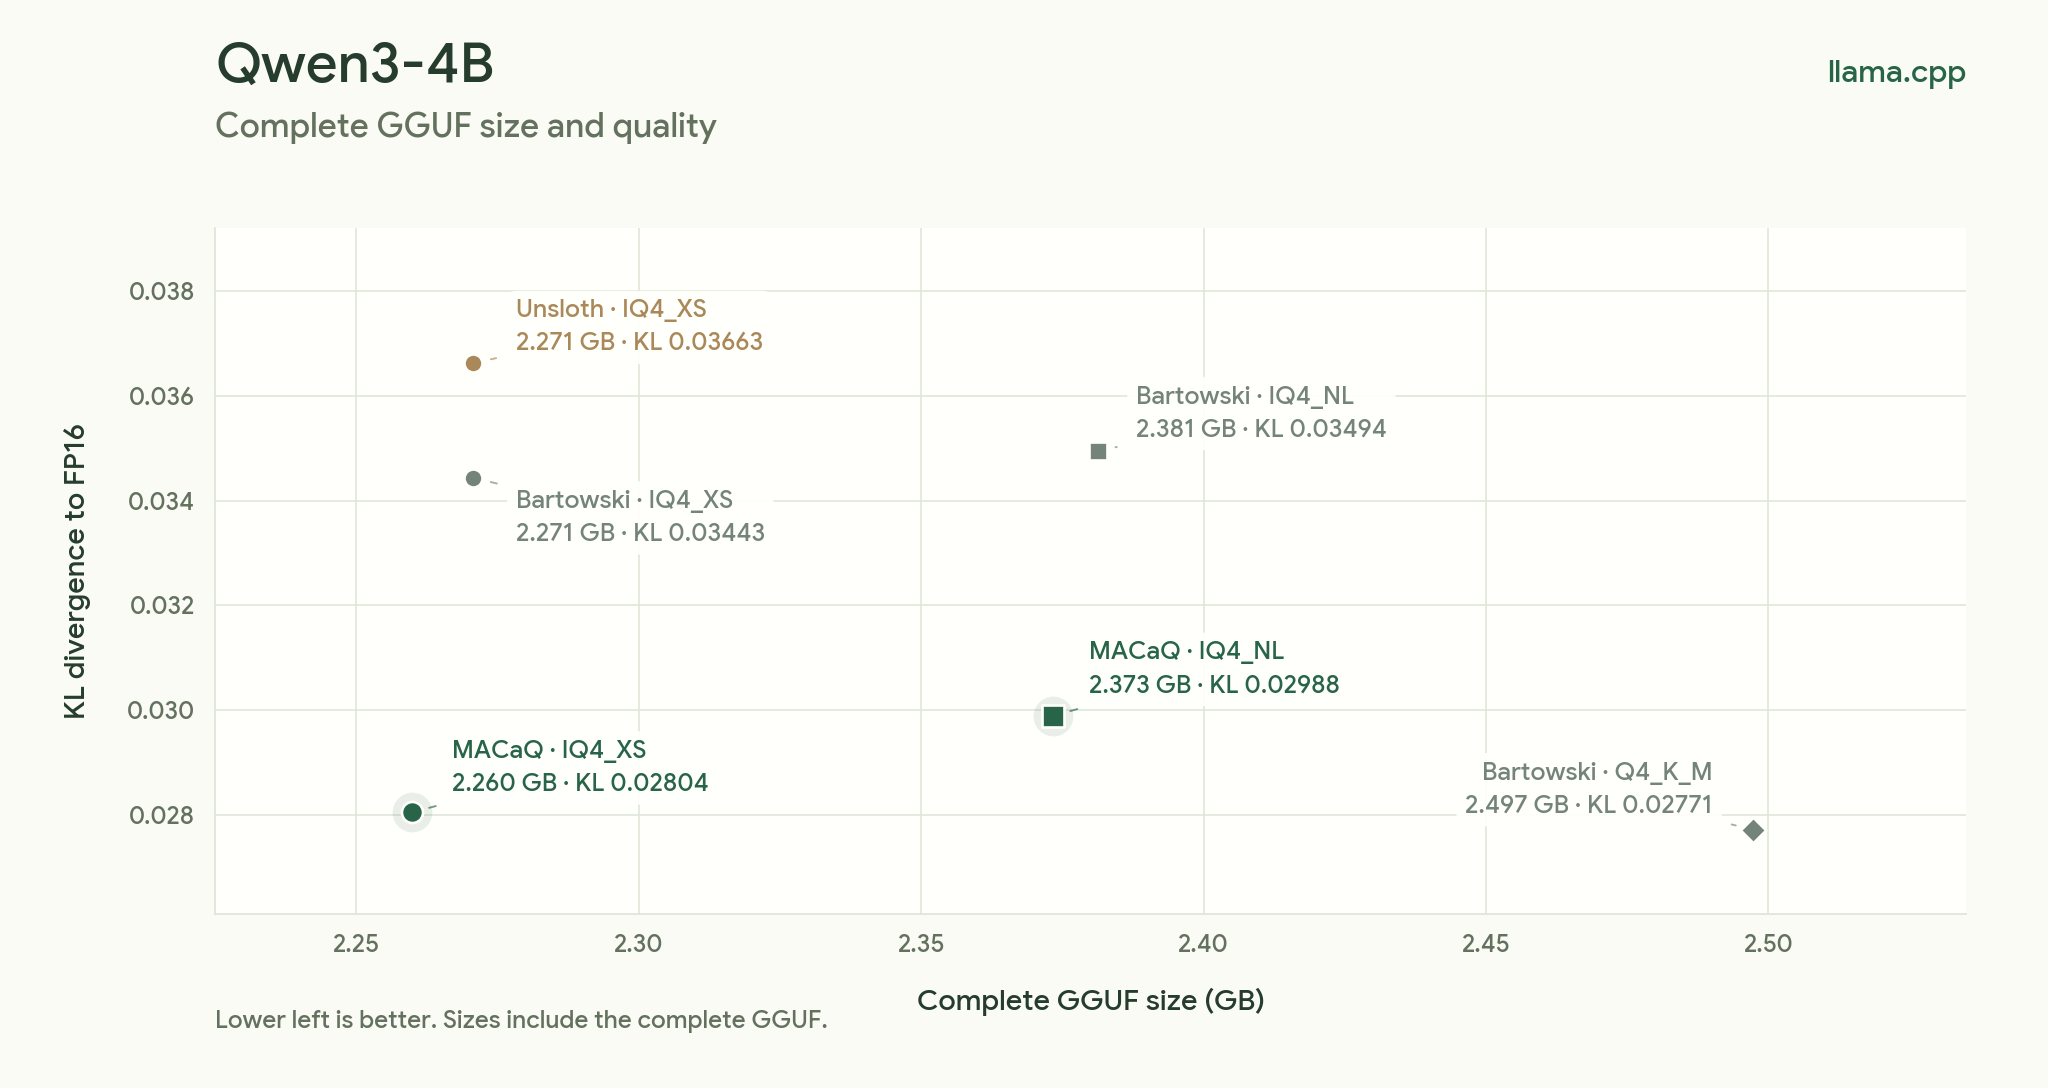
I-backend ye-llama.cpp ikhiqiza amafayela e-GGUF amancane okukhiqiza umbhalo. Isekela amafomethi e-GGUF angu-2-bit, 3-bit, no-4-bit futhi ihlanganisa i-runtime yokukhiqiza umbhalo ngemodeli ewumphumela.
Indawo yokugcina ichaza amamodeli aminyene afana ne-Qwen/Qwen3-4B, amamodeli axubile afana ne-Qwen/Qwen3.8-27B, namamodeli e-mixture-of-experts afana ne-Qwen/Qwen3-30B-A3B kanye ne-Qwen/Qwen3-Coder-30B-A3B-Instruct. Iphinde ifake amaresiphi e-Qwen3.6-35B-A3B ne-Qwen3.8-Flash-Next.
Inqubo ejwayelekile ye-quantization
Vula umhlahlandlela we-llama.cpp bese ukhetha iresiphi ehambisana nesakhiwo semodeli yakho.
Faka i-backend ye-llama.cpp nokuncika kwayo endaweni ezinikele ye-Python 3.12.
Lungisa imodeli yoqobo ye-Hugging Face nombhalo we-calibration ochazwe iresiphi ekhethiwe.
Qalisa inqubo ye-MACaQ ye-quantization ebhaliwe bese ugcina okukhiphayo kwe-GGUF.
Sebenzisa i-runtime efakiwe noma ukufakwa okuhambisanayo kwe-llama.cpp ukuze ukhiqize umbhalo.
Ngemininingwane eqondene nemodeli, landela isigaba se-dense, hybrid, mixture-of-experts, noma i-Flash-Next ku-README ye-backend. Lezi zindlela zicabangela umehluko phakathi kwezakhiwo zamamodeli.
Sebenzisa imodeli ye-GGUF
Uma ifayela le-GGUF selidaliwe, lisebenzise ngeklayenti lomugqa womyalo le-llama.cpp:
llama cli -m models/model-macaq-r.ggufUngaphinde usebenzise imodeli nge-llama.cpp:
llama serve -m models/model-macaq-r.ggufThuthukisa amafayela e-GGUF akhona nge-MACaQ-R
I-MACaQ-R ithuthukisa amakhodi ezisindo kufayela le-GGUF elikhona elenziwe i-quantization, igcine amafomethi alo omdabu nezikali zamabhulokhi. Ifayela eliwumphumela lihlala lihambisana nokufakwa okujwayelekile kwe-llama.cpp.
Lokhu kuyasiza uma usuvele unemodeli eyenziwe i-quantization futhi ufuna ukuthuthukisa ikhwalithi yayo noma uyilungisele umsebenzi othile ngaphandle kokushintsha ifomethi ye-GGUF. I-README inikeza imodeli ye-Qwen3.6-35B-A3B MACaQ-R ku-Hugging Face, futhi ibika i-KL divergence ephansi kunefayela le-Unsloth UD-Q4_K_XL eliqhathanisiwe elinosayizi ofanayo obaliwe.
Ukuze uthuthukise i-MoE GGUF eyenziwe i-quantization, nikeza imodeli eyenziwe i-quantization, imodeli yayo yoqobo ehambisanayo ye-Hugging Face, ifayela likathisha le-FP16, umbhalo wokulinganisa, indlela yokukhipha, kanye nendawo yokusebenza:
.venv-llamacpp/bin/python llamacpp/macaq.py refine \
  --model models/model-q4.gguf --hf models/original \
  --teacher models/original-f16.gguf --calibration data/calibration.txt \
  --output models/model-macaq-r.gguf --work-dir work/refinement
Ngemva kokuqedwa kokuthuthukisa, layisha okukhiphayo nge-llama.cpp ejwayelekile:
llama cli -m models/model-macaq-r.ggufUkuze uthole ukuhamba komsebenzi okuphelele kwe-MACaQ, okuhlanganisa izinguquko zokwenza kusebenze, sebenzisa umhlahlandlela we-bundled-runtime.
Yenza i-quantization futhi usebenzise amamodeli nge-vLLM
I-backend ye-vLLM idala ama-checkpoint amancane amamodeli ombhalo ukuze kusetshenziswe ukukhiqiza noma isevisi ye-HTTP. I-W4A4 iyimodi ezenzakalelayo ye-inference, futhi i-backend iphinde isekele i-quantization yezisindo kuphela.
Vula umhlahlandlela we-vLLM bese ukhetha ukuhamba komsebenzi kwemodeli yombhalo eyi-hybrid noma imodeli yombhalo eyi-mixture-of-experts.
Faka i-backend ye-vLLM endaweni yayo ye-Python 3.12.
Lungisa imodeli yomthombo nedatha yokulinganisa edingwa yindlela ekhethiwe.
Qalisa umyalo obhaliwe we-quantization ukuze udale i-checkpoint encane.
Layisha i-checkpoint ukuze ukhiqize endaweni noma uqale iseva ye-HTTP ebhaliwe.
I-README ibika ukuqhathaniswa kwe-Qwen3.8-27B lapho i-MACaQ W4A4 ifinyelela ku-perplexity engu-2.8994 uma kuqhathaniswa no-2.8463 we-BF16, kuyilapho ibika izilinganiso zokugcwalisa kokuqala nokukhipha ezishesha kakhulu ekusethweni kokuhlola okubaluliwe.
Yenza i-quantization yabakhiqizi benkulumo nge-PyTorch
I-backend ye-PyTorch iqondiswe ekukhiqizeni inkulumo futhi igcina ama-checkpoint e-W4A4. Uma i-checkpoint isigciniwe, ingalayishwa ngaphandle kokuphinda kwenziwe ukulinganisa.
Ukuhamba komsebenzi okubhaliwe kuhlanganisa i-Qwen3-TTS ne-Chatterbox Turbo.
Vula umhlahlandlela we-PyTorch bese ukhetha imodeli yenkulumo.
Faka okuncikile kwe-PyTorch okudingekayo endaweni ehlukile ye-Python 3.12.
Qalisa ukulinganisa ne-quantization usebenzisa imiyalelo eqondene nemodeli.
Gcina i-checkpoint ye-W4A4.
Layisha i-checkpoint egciniwe bese ukhiqiza umsindo we-WAV ngaphandle kokuphinda wenze ukulinganisa.
Sebenzisa i-MACaQ ngehadiwe ye-Ascend
Ama-kernel e-MACaQ W4A4 wokuphindaphinda omatikulethe abaminyene nabahlanganisiwe ayatholakala ngama-pull request ahlobene ne-CANN. I-README ikhomba kuma-kernel e-PTO-ISA ku-ops-nn pull request 12568 nakuma-kernel e-TileLang ane-backend ye-CCE ku-ops-tilelang pull request 44.
Landela imiyalelo yokwakha kulawo maphrojekthi ukuze uthole izinguqulo ezihambisanayo ze-CANN, PyTorch, ne-torch_npu. Ukusebenzisa imodeli ephelele kudinga ukuhlanganiswa ne-runtime ye-Ascend inference.
Amathiphu awusizo okuhamba komsebenzi okungcono
- Qondanisa i-backend nendawo okuqondiswe kuyo ukuthunyelwa. Khetha i-GGUF ne-llama.cpp ukuze uthole i-text inference yasendaweni ephathekayo, i-vLLM ukuze unikeze umbhalo, i-Diffusers ukuze ukhiqize okuqukethwe kwemidiya eminingi, ne-PyTorch kumamodeli enkulumo.
- Sebenzisa izindlela eziqondene nemodeli. Amamodeli e-dense, hybrid, ne-mixture-of-experts angadinga izinyathelo ezihlukene zokulungiselela ne-quantization.
- Gcina idatha yokulinganisa ihambisana nokusetshenziswa. Isibonelo, ukuhamba komsebenzi kwe-Diffusers kokuguqula isithombe sibe yividiyo kusebenzisa izithombe zokubeka umbandela ngesikhathi sokulinganisa.
- Hlukanisa izindawo. I-README incoma ngokusobala indawo ehlukile ye-backend ngayinye ne-Python 3.12.
- Qhathanisa ikhwalithi, hhayi usayizi wefayela kuphela. Iphrojekthi isebenzisa ukuqhathanisa kwe-perplexity ne-KL divergence ukuhlola amamodeli enziwe i-quantization ngokuqhathanisa ne-FP16 noma ezinye izindlela ze-quantization.
- Sebenzisa i-MACaQ-R uma usuvele une-GGUF. Ingathuthukisa ifayela elikhona elenziwe i-quantization kuyilapho igcina ukuhambisana okujwayelekile ne-llama.cpp.
Isiphetho
I-MACaQ inikeza indlela eyodwa ye-quantization emisebenzini eminingi ye-AI, kusukela kumamodeli ombhalo e-GGUF kuya kumamodeli ezithombe, amavidiyo, nomsindo e-Diffusers, kuma-checkpoint asetshenziswa yi-vLLM, nakumagenerator enkulumo e-PyTorch. Qala nge-README eqondene ne-backend, sebenzisa i-Python 3.12 endaweni ehlukanisiwe, landela iresiphi yemodeli ukuze wenze i-calibration, bese uqinisekisa i-checkpoint evelayo nge-runtime ohlose ukuyisebenzisa.
Ngocwaningo noma ngemibhalo yezobuchwepheshe, bheka iphepha le-MACaQ. Iphrojekthi ikhishwa ngaphansi kwe-Apache License 2.0.