
- الزيارات الشهرية
- 0
- الأسعار
- ما تحددش
- مدرج
- —
- تحدّث
- 2026-09-24
01شنو هو Qwen-Audio-3.1؟
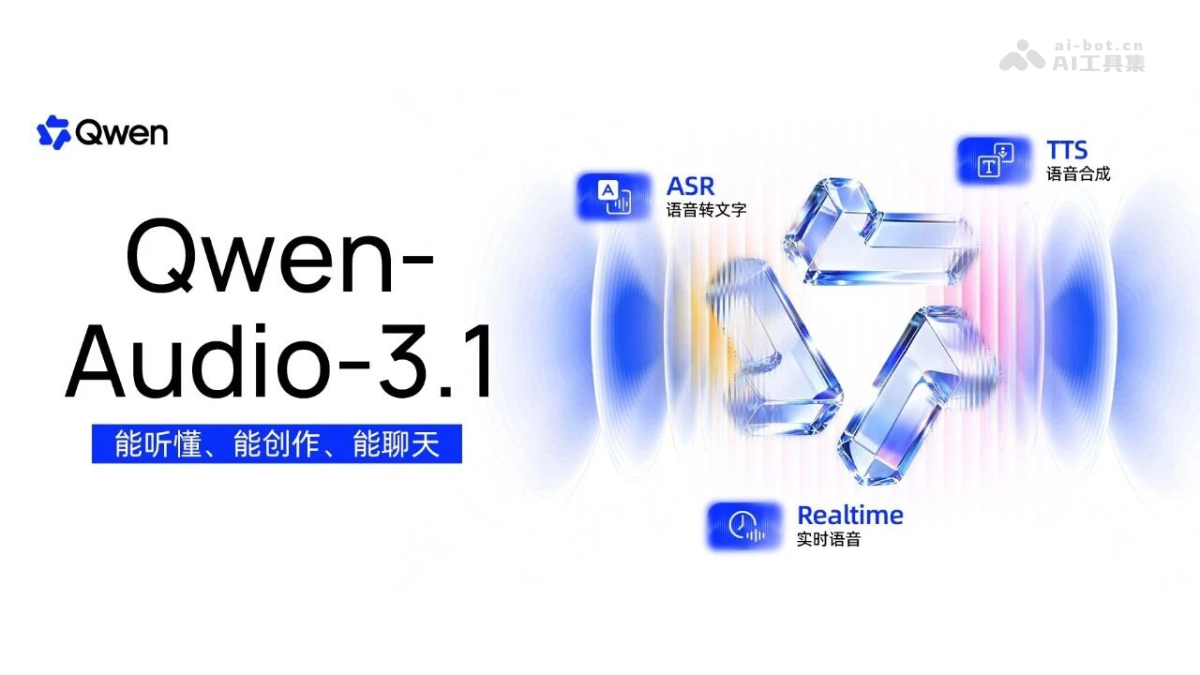
Qwen-Audio-3.1 هي سلسلة ديال النماذج الصوتية الكبيرة من Tongyi Qianwen، وكتضم خمسة نماذج: ASR للتعرّف على الكلام، ASR-Next لفهم الصوت، TTS لتركيب الكلام، TTS-Next للإبداع الصوتي، وRealtime للتفاعل الفوري، وكتغطي السلسلة كاملة من الفهم والتوليد والتفاعل والإبداع. كيدعم Qwen-Audio-3.1 30 لغة و16 لهجة صينية، والتفريغ حسب المتكلمين، وفهم المشاعر، والحوار الفوري ثنائي الاتجاه، وقدر يستعمل الأدوات باش يكمل المهام.
02الوظائف الرئيسية ديال Qwen-Audio-3.1
ASR للتعرّف على الكلام: كيدعم التفريغ حسب المتكلمين فـ30 لغة و16 لهجة صينية، مع علامات المتكلمين والطوابع الزمنية، وقدر ينقّح النص بشكل أصلي.
ASR-Next لفهم الصوت: كيتجاوز النص المفرّغ باش يفهم مشاعر الأشخاص، والأصوات المحيطة والميكانيكية، وكيدعم وصف الأصوات، وتحديد الأحداث، والأسئلة والأجوبة حول الصوت.
TTS لتركيب الكلام: كيدعم التركيب بعدة لغات ولهجات، مع نقل طبيعي لنفس الصوت بين اللغات، والتحكم فالمشاعر وسرعة الكلام باستعمال التعليمات.
TTS-Next للإبداع الصوتي: كيولّد فمرة وحدة صوتاً بشرياً ومؤثرات صوتية وأصواتاً محيطة باش يكوّن صوتاً كاملاً، مناسب للبودكاست والكتب الصوتية والأفلام والألعاب والإعلانات.
Realtime للتفاعل الفوري: كيسمع وكيهضر فـنفس الوقت وباتجاهين، كيفهم المشاعر والنية، وكيبدّل بين اللغات، وقدر يستعمل الأدوات وسط الحوار باش يكمل المهام.
03المبادئ التقنية ديال Qwen-Audio-3.1
النمذجة المشتركة من البداية للنهاية (ASR): كيعتمد Qwen-Audio-3.1-ASR على طريقة من البداية للنهاية، وكيخرج علامات المتكلمين والطوابع الزمنية والنص المفرّغ بشكل موحّد، عوض المعالجة على مراحل ديال الأنظمة التقليدية المتسلسلة، وهاد الشي كيخليه يحافظ على المداخلات القصيرة والكلام المتداخل؛ النموذج فيه حتى قدرات مدمجة لحذف كلمات التردد، وإزالة التكرار، والتصحيح الذاتي، وإعادة بناء المعنى، باش تكون نتائج التفريغ منظمة وقابلة للاستعمال مباشرة فمحاضر الاجتماعات وتحليل الحوارات.
الجيل الجديد ديال بنية فهم الصوت (ASR-Next): كيعتمد ASR-Next على بنية من الجيل الجديد، وكيوسّع موضوع المعالجة من «الكلام اللي فالصوت» للإشارة الصوتية كاملة. ومن خلال فهم المشاعر على المستوى الصوتي، والأصوات المحيطة والميكانيكية، كيحدّد أحداث الصوت وكيصفها وكيستنتجها، وهاد الشي كيمثل انتقال ASR من أداة للتفريغ لنموذج عام لفهم الصوت.
نقل نبرة الصوت والتحكم فالتعبير (TTS): كيتجاوز نموذج TTS طريقة التركيب التقليدية اللي كتركز غير على صحة نطق الكلمات، وكيحقق نقلاً طبيعياً لنفس نبرة الصوت بين اللغات واللهجات، وكيستعمل التعليمات لنمذجة المشاعر وسرعة الكلام وطريقة التعبير، باش ينسجم الصوت المركّب مع المحتوى والسياق.
التوليد الصوتي الموحّد (TTS-Next): كيعتمد TTS-Next على ثلاثة أنواع ديال المدخلات: النص والطوابع الزمنية والصوت المرجعي، وكيولّد بشكل موحّد الصوت البشري والمؤثرات الصوتية والأصوات المحيطة؛ ووسط الحوارات المتعددة المراحل كيحافظ على انسجام نبرات أصوات الشخصيات ومشاعرها، وكيتيح التحكم فعملية التوليد باللغة الطبيعية، مع دعم التحكم الدقيق فالأزمنة، واستنساخ الصوت، وإخراج عالي الدقة بـ48kHz.
بنية ثنائية الاتجاه بالتقطير من عدة معلّمين (Realtime): كيعتمد Realtime على بنية التقطير من عدة معلّمين، وكيحسّن الفهم والاستدلال والتعبير والسلامة مع الحفاظ على زمن استجابة منخفض. وكيحقق تفاعلاً ثنائي الاتجاه، بحيث الكلام والاستماع كيوقعو فـنفس الوقت، مع دعم المقاطعة فـأي لحظة؛ كما كيدمج القدرة على استدعاء الأدوات، وكيقدر يفهم الطلبات المتغيرة وسط الحوار المستمر، ويربط واجهات API الخارجية وقواعد المعرفة والأنظمة المهنية باش يكمل المهام.
04كيفاش تستعمل Qwen-Audio-3.1
حلّ منصة Qianwen AI: دخل لـ https://www.qianwenai.com/ وسجّل الدخول للحساب، ومن بعد مشي لساحة النماذج.
اختار النموذج اللي محتاج: على حساب الحاجة ديالك اختار النموذج المناسب: ASR (التفريغ)، TTS (التركيب)، TTS-Next (الإبداع)، أو Realtime (التفاعل الفوري)، ومن بعد دخل لصفحة التفاصيل.
خذ API Key: فعّل خدمة النموذج من لوحة التحكم وأنشئ API Key باش تستعملو فالمصادقة على الواجهة.
استعمل الواجهة: رجع لوثائق API فصفحة تفاصيل كل نموذج، وصيفط معطيات الصوت أو النص عبر طلبات HTTP (واجهة ASR-Next مازال ما تطلقاتش، وخص انتظار فتحها).
دمجو فالتطبيق: ربط الواجهة بالتطبيق ديالك أو بالـAgent أو بالأجهزة الذكية، وغادي تقدر تنجز المهام الصوتية أونلاين.
05المزايا الأساسية ديال Qwen-Audio-3.1
قدرة قوية على اللغات واللهجات: نموذج واحد كيدعم 30 لغة و16 لهجة صينية، والتحسن باين خصوصاً فالتعرّف على اللهجات الصعيبة بحال لهجة ونتشو.
تنقيح ذكي للتفريغ: كيقوم ASR أصلياً بحذف كلمات التردد والتكرار وإعادة بناء المعنى، وكيخرج نصاً منظماً وسلساً وأكثر منطقية.
تفريغ دقيق حسب المتكلمين: كيخرج علامات المتكلمين والطوابع الزمنية والنص من البداية للنهاية، وكيقدم أداءً أفضل بشكل شامل من النظام المتسلسل Fun-ASR.
تطوير فهم الصوت: كيقدر ASR-Next يفهم المشاعر والأصوات المحيطة والميكانيكية، وكيحوّل «النص المفرّغ» لفهم «الصوت الكامل».
قدرات إبداعية موحّدة: كيولّد TTS-Next الصوت البشري والمؤثرات الصوتية والأصوات المحيطة فمرة وحدة، مع الحفاظ على انسجام نبرات ومشاعر الشخصيات المتعددة، وكيعوّض سيرورة الإنتاج اللاحق اللي كتحتاج توزيع العمل بين عدة أشخاص.
تفاعل فوري قريب من الإنسان: استماع وكلام متوازيان فـاتجاهين، مع دعم المقاطعة، وفهم المشاعر واستعمال الأدوات لإكمال المهام.
زمن استجابة منخفض وأداء قوي: كتكون استجابة أول كلمة فالتعرّف المتدفق تقريباً فـ160 ميلي ثانية، وكيجمع Realtime بين زمن الاستجابة المنخفض وقدرة الاستدلال بفضل التقطير من عدة معلّمين.
06رابط مشروع Qwen-Audio-3.1
تجربة مباشرة: Qwen-Audio-3.1-ASR: https://www.qianwenai.com/models/qwen-audio-3.1-asr-flash
Qwen-Audio-3.1-TTS: https://www.qianwenai.com/models/qwen-audio-3.1-tts-flash
Qwen-Audio-3.1-TTS-Next: https://www.qianwenai.com/models/qwen-audio-3.1-tts-next
Qwen-Audio-3.1-Realtime: https://www.qianwenai.com/models/qwen-audio-3.1-realtime-plus
07مجالات استعمال Qwen-Audio-3.1
محاضر الاجتماعات وتسجيلات المقابلات: باستعمال التفريغ حسب المتكلمين والطوابع الزمنية ديال ASR، كيخرج أوتوماتيكياً تسجيلاً منظماً كيبين «شكون قال شنو وفاش»، وكيحيد شوائب الكلام بشكل أصلي، وكيحسن مردودية الاجتماعات بزاف.
إنشاء البودكاست والكتب الصوتية: باستعمال TTS-Next كتقدر تولّد فمرة وحدة صوتاً كاملاً فيه حوارات متعددة الأشخاص ومؤثرات صوتية وأصوات محيطة، مع الحفاظ على انسجام نبرات ومشاعر الشخصيات، وكتستغنى على توزيع الخدمة بين المقدم ومهندس المؤثرات ومهندس المزج الصوتي.
خدمة الزبناء الصوتية الفورية والمساعد الذكي: بالاعتماد على التفاعل ثنائي الاتجاه وفهم المشاعر فـRealtime، تقدر تبني خدمة زبناء صوتية كتقبل المقاطعة وكتتفاعل بتعاطف، وقدر حتى تستعمل الأنظمة المهنية وسط الحوار باش تنجز مهام بحال البحث والطلب.
السفر الدولي والتواصل بعدة لغات: بفضل التبديل الفوري بين 30 لغة والقدرة على تركيب نفس نبرة الصوت بلغات مختلفة، كتقدم تجربة طبيعية وسلسة للترجمة والتواصل فالتخطيط للسفر والتجارة الإلكترونية الدولية والاجتماعات الدولية.
الأجهزة الذكية المدعومة بالذكاء الاصطناعي: من خلال الدمج مع أجهزة بحال QwenNote ونظارات Qianwen AI، يقدر المستخدم يبدأ المهام بالصوت مباشرة، ويزيد الشروط ويتابع التنفيذ بلا ما يفتح الحاسوب أو الهاتف، وكيولي الصوت مدخلاً طبيعياً لأجهزة الذكاء الاصطناعي.
© إخلاء المسؤولية: النطاقات والمحتوى المرتبط يقدرو يتبدلو مع الوقت. AIEZZ ما كيتحكمش فالمواقع التابعة لجهات أخرى. راجع المحتوى الخارجي والمخاطر بشكل مستقل.
تقييمات المستخدمين0