
- الزيارات الشهرية
- 0
- الأسعار
- ما تحددش
- مدرج
- —
- تحدّث
- 2026-09-14
01شنو هو Xiaomi-CocktailASR-1؟
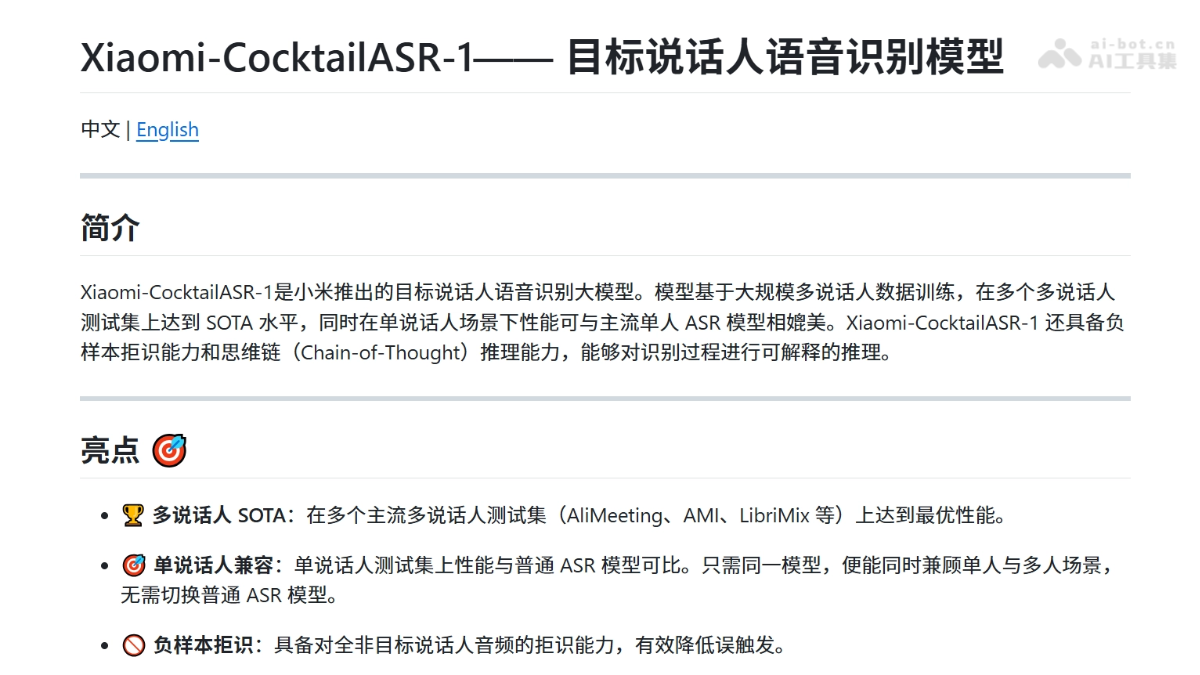
Xiaomi-CocktailASR-1 هو نموذج كبير مفتوح المصدر من Xiaomi للتعرّف على كلام المتحدث المستهدف، مبني على بنية LLM من البداية للنهاية، وكيستعمل صوت مرجعي كإشارة للبصمة الصوتية، وكيقدر يفرّغ بدقة كلام المتحدث المستهدف من صوت مختلط ديال عدة متحدثين بلا ما يحتاج لفصل الصوت. النموذج وصل لمستوى SOTA فمعايير المتحدثين المتعددين، وكيدعم حتى سيناريوهات المتحدث الواحد، وكيتميّز برفض العينات السلبية وبالاستدلال القابل للتفسير باستعمال سلسلة التفكير، وهو مفتوح المصدر برخصة Apache 2.0.
02الوظائف الرئيسية ديال Xiaomi-CocktailASR-1
التعرّف على كلام المتحدث المستهدف: من بعد ما كتعطيه صوت مرجعي وتسجيل مختلط ديال عدة متحدثين، كيفرّغ مباشرة كلام المتحدث المستهدف بلا ما يحتاج لفصل الصوت.
دعم المتحدث الواحد: نفس النموذج كيقدر يعالج سيناريوهات المتحدث الواحد، بأداء قريب من أنظمة ASR الرائجة للمتحدث الواحد، بلا تبديل النموذج.
رفض العينات السلبية: إلا ما كانش المتحدث المستهدف فالتسجيل، كيخرج نص خاوي، وهادشي كيقلل التفعيلات الخاطئة بشكل فعّال.
الاستدلال بسلسلة التفكير: وضع CoT كيخرج مراحل الاستدلال، بحال عدد المتحدثين والجنس ودرجة تشابه البصمة الصوتية، وكيجمع بين قابلية التفسير ودقة التعرّف.
03المبدأ التقني ديال Xiaomi-CocktailASR-1
البنية الموحدة من البداية للنهاية: النموذج مكوّن من ثلاثة أجزاء: مشفّر صوتي بحجم 0.6B محسّن مبني على Data2Vec2، وAdapter خطي خفيف، وعمود فقري لنموذج اللغة الكبير Qwen3-8B. كيتجمع الإدخال بالترتيب «الصوت المرجعي + ثانية وحدة ديال الصمت + الصوت المختلط»، ومن بعد ما كيخرج المشفّر خصائص على مستوى الإطارات، كيحاذيها Adapter مع الفضاء الخفي ديال LLM، وكتدخل مع Prompt نصي إلى LLM باش يولّد تفريغ كلام المتحدث المستهدف.
الصوت المرجعي كإشارة شرطية: المشفّر كيستعمل آلية التنبؤ الذاتي بالقناع ديال Data2Vec2، وكيجمع المعلومات الدلالية ومعلومات المتحدث داخل شبكة وحدة، بلا حاجة لمشفّر مستقل للبصمة الصوتية؛ وكيتم التعامل مع الصوت المرجعي باعتباره Prompt شرطي، وهادشي كيخلي المشفّر يركّز تلقائياً على المتحدث المستهدف ويكبح الأصوات المتداخلة من مرحلة استخراج الخصائص، وكيمنع من الأصل تراكم الأخطاء اللي كيميز أنظمة «الفصل + التعرّف» التقليدية.
تدريب متعدد المراحل لتحقيق التوازن بين القدرات: باستعمال توزيع مناسب لحوالي مليون ساعة من البيانات، كيتدرّب النموذج على أربع قدرات موحّدة: حوالي 400 ألف ساعة من بيانات المتحدثين المتعددين لتدريب استخراج الهدف، وحوالي 600 ألف ساعة من أزواج المرجع والهدف لنفس المتحدث لتفادي الكبح الزائد فسيناريو المتحدث الواحد، وحوالي 10 آلاف ساعة من عينات مرجعية غير متطابقة لترسيخ قدرة رفض العينات السلبية بلا حاجة لعتبة أثناء الاستدلال، إضافة إلى بيانات CoT باش يتعلم النموذج يخرج سلسلة التفكير أولاً ومن بعد الجواب.
Prompt بوضعين وآلية الرفض: الوضع العادي كيستعمل Prompt موحّد كيغطي فآن واحد ثلاث مهام: التعرّف على متحدث واحد، والتعرّف على الهدف وسط عدة متحدثين، ورفض العينات السلبية؛ وإلا كان الهدف غايب، كيخرج النموذج نصاً خاويًا بشكل طبيعي. أما وضع CoT كيستعمل Prompt مستقل لتفعيل وسم الاستدلال، وكيخرج الخطوات الوسيطة بحال عدد المتحدثين والجنس ودرجة تشابه البصمة الصوتية، ومن بعد كيقدم التفريغ النهائي، وهادشي كيحسن قابلية التفسير وكيخفض WER بشكل بسيط.
04كيفاش تستعمل Xiaomi-CocktailASR-1
تثبيت الاعتماديات: نفّذ pip install torch torchaudio transformers soundfile باش تثبّت البيئة المطلوبة.
تحميل النموذج: حمّل ملفات أوزان النموذج من HuggingFace (Ease3/Xiaomi-CocktailASR-1).
تحميل النموذج: استعمل AutoModel.from_pretrained("Ease3/Xiaomi-CocktailASR-1", trust_remote_code=True, torch_dtype="bfloat16").cuda().eval() لتحميل النموذج.
تحضير الصوت: وجد صوتاً مرجعياً أحادي القناة بتردد 16k (البصمة الصوتية ديال المتحدث المستهدف) وتسجيلًا آخر لمتحدث واحد أو عدة متحدثين للتعرّف عليه (التسجيلات اللي ماشي 16k كيعاد أخذ عيناتها أوتوماتيكياً).
الاستدلال على تسجيل واحد: عيّط لـ model("target.wav", "ref_speaker.wav") وغادي يرجّع نص كلام المتحدث المستهدف (فالعينات السلبية كيخرج النص الخاوي أوتوماتيكياً بلا معاملات إضافية).
الاستدلال بسلسلة التفكير: زِد المعامل cot=True، وغادي يخرج النموذج مراحل الاستدلال فـ والنتيجة النهائية فـ .
الاستدلال على دفعة: رتّب البيانات فملف TSV فيه 5 أعمدة (utt_id, wav, text, ref_wav, ref_id)، وشغّل tools/test_batch_scp.py مع تحديد مسار النموذج وملف TSV ديال الإدخال وملف الإخراج باش تفرّغ التسجيلات دفعة وحدة.
05المزايا الأساسية ديال Xiaomi-CocktailASR-1
أداء SOTA مع عدة متحدثين: وصل لأفضل مستوى تعرّف فعدة معايير معروفة ديال المتحدثين المتعددين، بحال AliMeeting وAMI وLibriMix (مثلاً، AliMeeting Far WER بنسبة 20.63%، بينما كان SOTA السابق 27.5%).
توحيد سيناريوهات المتحدث الواحد والمتعدد: نفس النموذج كيقدم أداء قريب من أنظمة ASR الرائجة فسيناريو المتحدث الواحد، بلا تبديل النموذج حسب عدد المتحدثين.
القدرة على رفض العينات السلبية: إلا كان المتحدث المستهدف غايب كيخرج نصاً خاويًا، وبنسبة رفض كتتراوح بين 68%-80%، بينما نماذج Qwen3-ASR وStepAudio وغيرها عندها نسبة رفض 0.
استدلال قابل للتفسير بسلسلة التفكير: وضع CoT كيخرج مراحل الاستدلال، بحال عدد المتحدثين والجنس ودرجة تشابه البصمة الصوتية، وكيحسن قابلية التفسير وكيخفض WER بشكل بسيط.
بنية بسيطة من البداية للنهاية: الصوت المرجعي كيستعمل مباشرة كـ Prompt للبصمة الصوتية، وكيحيد الحاجة لوحدة فصل الصوت التقليدية وكيمنع تراكم الأخطاء فالنظام المتسلسل.
سهل الاستعمال: استدعاء بسطر كود واحد، ودعم إعادة أخذ العينات أوتوماتيكياً والاستدلال على دفعات، مع توفير أمثلة للعينات الإيجابية والسلبية، وجاهز للاستعمال مباشرة.
06رابط مشروع Xiaomi-CocktailASR-1
مستودع GitHub: https://github.com/xiaomi-research/xiaomi-cocktailasr-1
مستودع النموذج على HuggingFace: https://huggingface.co/Ease3/Xiaomi-CocktailASR-1
الورقة التقنية على arXiv: https://arxiv.org/pdf/2609.11274
07مجالات استعمال Xiaomi-CocktailASR-1
التفريغ الموجّه للاجتماعات الذكية: فاجتماعات فيها عدة متحدثين، كيسجل غير كلام المتحدث المحدد وكيصفي تلقائياً المداخلات والنقاشات ديال المشاركين الآخرين.
التعرّف على أوامر مالك الهاتف فالمساعدات الصوتية: فالهواتف ومكبرات الصوت والسيارات، كيرد غير على صوت المالك، وما كتفعّلش الأصوات اللي فالخلفية الأوامر بالخطأ.
تحليل تسجيلات خدمة الزبناء ومراقبة الجودة: كيستخرج بدقة الكلام الكامل ديال طرف محدد من تسجيلات مكالمات متعددة الأطراف، للاستعمال فمراقبة الامتثال وتقييم الخدمة.
التحكم الصوتي فالدار الذكية: فبيئة منزلية فيها ضجيج التلفاز ومحادثات متعددة، كيتعرّف بدقة على أوامر الشخص اللي شاد جهاز التحكم وكيمنع العمليات الخاطئة.
أجهزة المساعدة على السمع والتسجيل لذوي الإعاقة: كتستخرج بشكل موجّه كلام شخص محدد وكتحوّلو لنص فالحين، وكتعاون الأشخاص اللي عندهم ضعف فالسمع أو اللي كيسجلو، خصوصاً فالمناسبات الاجتماعية المزعجة، باش يركّزو على الشخص اللي باغين يسمعو.
© إخلاء المسؤولية: النطاقات والمحتوى المرتبط يقدرو يتبدلو مع الوقت. AIEZZ ما كيتحكمش فالمواقع التابعة لجهات أخرى. راجع المحتوى الخارجي والمخاطر بشكل مستقل.
تقييمات المستخدمين0