
- 月間訪問数
- 0
- 料金
- 未設定
- 掲載日
- —
- 更新済み
- 2026-11-06
01Ling-3.2-flashとは
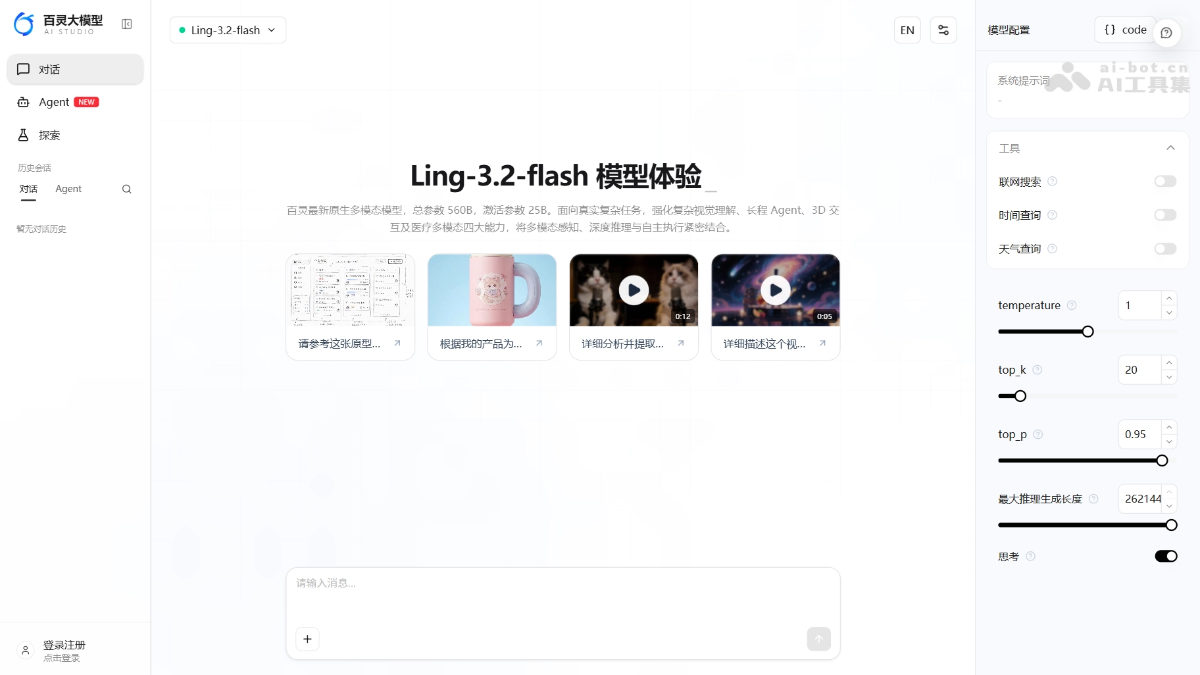
Ling-3.2-flashは蚂蚁百灵が提供する最新のネイティブマルチモーダル大規模モデルです。MoEアーキテクチャを採用し、総パラメータ数は560B、各ステップでアクティブになるのは約25Bのみです。コンテキストウィンドウは1Mに達し、画像、テキスト、動画入力をネイティブでサポートします。複雑な視覚理解、マルチモーダル長期Agent、3D理解とインタラクション、医療マルチモーダルという4つの能力を重点的に強化しており、公式の自己評価では3つのベンチマークでClaude Opus 5を上回っています。
02Ling-3.2-flashの主な機能
複雑な視覚理解:画像や動画の内容を深く理解し、視覚的な推論や分析タスクを支援します。
マルチモーダル長期Agent:複数ステップのタスクで目標の一貫性を維持し、視覚情報とテキスト情報に基づいて意思決定と実行を行います。
3D理解とインタラクション:3次元空間や空間関係を解析し、3D関連のインタラクションタスクを支援します。
医療マルチモーダル:医用画像の理解やレポートの解読に対応し、専門的な医療分析を支援します。
1Mコンテキスト処理:長文書や長時間動画の分析に対応し、長いコンテキストを必要とするシナリオに応えます。
03Ling-3.2-flashの技術原理
MoE混合エキスパートアーキテクチャ:Ling-3.2-flashは混合エキスパートアーキテクチャを採用し、総パラメータ数は560B、各ステップでアクティブになるのは約25Bのみです。各トークンは最も関連性の高いエキスパートサブネットワークにのみルーティングされます。大容量の知識ストレージを維持しながら、1ステップあたりの計算コストを極めて小さな割合に抑えることで、モデルの能力と推論コストのバランスを実現する中核的な仕組みです。
ネイティブマルチモーダル融合:外付けの視覚モジュールを使用する方式とは異なり、このモデルはアーキテクチャレベルで視覚と言語の能力をネイティブに融合しています。画像、テキスト、動画を推論の基礎入力として扱い、より深いクロスモーダル理解を実現します。これは、「画像を見て説明する」だけの浅いマルチモーダルとは異なる重要な特徴です。
長いコンテキストのモデリング:モデルのコンテキストウィンドウは1Mに達し、Ling 3.0シリーズで導入されたKDAを引き継ぎ、長い系列における記憶の更新と情報保持を強化しています。これにより、対象情報がコンテキストの先頭、中間、末尾のいずれにあっても安定して想起でき、長距離情報の明らかな減衰を抑えます。
知覚・推論・実行の閉ループ:マルチモーダルな知覚、深い推論、自律的な実行を緊密に結び付け、Ling-3.0-flash-VLの「観察→行動→検証→修正」という視覚フィードバック閉ループの考え方を受け継いでいます。複数ステップのタスクを実行する際は、中間結果に基づいて経路を継続的に修正できます。
04Ling-3.2-flashの使い方
プラットフォームにアクセス:蚂蚁百灵の公式サイトにアクセスし、Ling-3.2-flashのチャットページに移動すると、オンラインで直接体験できます。
キーを取得:プラットフォームのコンソールでAPIキーを作成し、呼び出し用の認証情報として使用します。
呼び出しを開始:APIから最初のリクエストを送信します。モデルはOpenAIおよびAnthropicのプロトコルに対応しているため、使い慣れた方法で既存のコードに接続できます。
無料枠を活用:リリース前の2週間は期間限定で無料です。無料期間中に十分にテストしてから、有料利用を検討できます。
高度な機能を試す:1Mの長大コンテキスト、画像・動画入力、マルチモーダルAgentタスクなどの高度な機能も試せます。
05Ling-3.2-flashの主な強み
ネイティブマルチモーダル理解:アーキテクチャレベルで視覚と言語の能力をネイティブに融合し、外付けの視覚モジュールに依存しません。
4つの中核能力:複雑な視覚理解、マルチモーダル長期Agent、3D理解とインタラクション、医療マルチモーダルを重点的に強化し、知覚・推論・実行を緊密に結び付けます。
容量とコストのバランス:560Bのモデル容量を維持しながら、各ステップのアクティブパラメータ数を約25Bに抑え、能力と推論効率を両立します。
1Mコンテキストウィンドウ:長文書や長時間動画の分析に対応し、長いコンテキストを必要とするシナリオに応えます。
06Ling-3.2-flashのプロジェクトURL
プロジェクト公式サイト:https://developer.ant-ling.com/zh-CN/docs/models/ling/#ling-32-flash
07Ling-3.2-flashの活用シーン
複雑な視覚理解:Ling-3.2-flashは画像や動画の内容を深く理解し、視覚的な推論や分析タスクを支援します。
マルチモーダル長期Agent:モデルは複数ステップのタスクで目標の一貫性を維持し、視覚情報とテキスト情報に基づいて意思決定と実行を行えます。
3D理解とインタラクション:モデルは3次元空間や空間関係を理解し、各種3D関連のインタラクションタスクを支援できます。
医療マルチモーダル:モデルは医用画像を理解し、レポートを解読して、医師による専門的な医療分析を支援できます。
長文書・長時間動画の分析:1Mのコンテキストウィンドウにより、モデルは超長文書や長時間動画の内容を処理し、長いコンテキストを必要とするシナリオに対応できます。
© 免責事項:ドメインやリンク先のコンテンツは時間の経過とともに変更される場合があります。AIEZZは第三者のウェブサイトを管理していません。外部コンテンツとリスクはご自身で確認してください。
ユーザーレビュー0