
- 月間訪問数
- 0
- 料金
- 未設定
- 掲載日
- —
- 更新済み
- 2026-10-30
01Nemotron 3.5 Transcribeとは
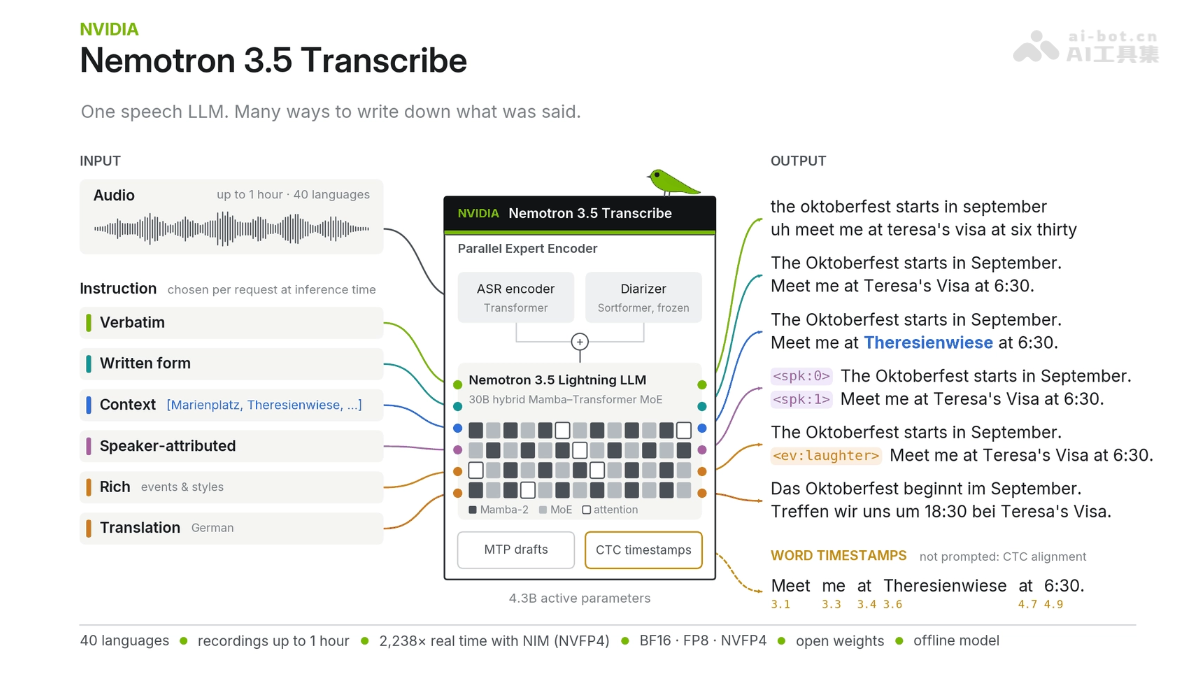
Nemotron 3.5 Transcribeは、NVIDIAが開発したオープンソースの音声大規模モデルです。音声エンコーダーとMoEアーキテクチャを採用し、約43億のアクティブパラメータを持ち、40言語に対応しています。最長1時間、最大8人の話者による録音を処理でき、逐語転写、話者識別、翻訳などの機能を備えています。Nemotron 3.5 Transcribeは、自然言語の指示による出力形式のカスタマイズや、ファインチューニングによる専門分野への適応に対応しており、商用利用も無料です。
02Nemotron 3.5 Transcribeの主な機能
多言語転写:40言語に対応し、録音をテキストに変換できます。会話で使われている言語の種類も識別できます。
話者識別:最大8人の話者を区別し、各発言に話者情報を付与できます。会議や複数人のインタビューに適しています。
長時間音声処理:1回の処理で最長約1時間の録音に対応します。
指示ベースの転写:自然言語で出力形式を指定できます。逐語録、文章としての整理、フィラーの除去、用語の表記などを再学習なしで設定できます。
音声翻訳:31言語と英語の間で相互翻訳できます。
単語レベルのタイムスタンプ:各単語に対応する音声上の時間位置を返し、聞き直しや検索に役立ちます。
分野別ファインチューニング:NeMo Speechツールキットを使い、単一GPU上で少量のデータから専門的な用途へ迅速に適応できます。
03Nemotron 3.5 Transcribeの技術原理
WeChatでフォローして「開源」と返信すると、AIオープンソースプロジェクト交流グループに参加できます。
音声強化言語モデル(SALM):モデルは3つの部分で構成されます。Transformer音声エンコーダーが音声特徴を抽出し、凍結されたNemotron 3話者分離モデルが話者活動情報を提供します。両者は共同で、Nemotron 3.5 Lightning 30B-A3B混合Mamba-Transformer MoE大規模言語モデルに接続されます。総パラメータ数は約340億ですが、推論ごとにアクティブになるのは約43億パラメータ בלבדで、性能と効率を両立しています。
並列エンコーダー:frozen分離モデルが出力する話者活動信号をASRエンコーダーの表現に注入することで、単一のLLMアーキテクチャのまま、話者ラベル付きの転写を実行できます。また、シリアライズされた出力方式で学習されます。
教師あり学習の均衡化:学習データはサンプル数ではなく回答token数に基づいてサンプリングされます。各ASRサンプルに複数のタスク指示を組み合わせられるため、新しい能力を1%未満のサンプリング率で追加できます。学習全体は教師ありファインチューニングと短時間の強化学習の2段階に分かれ、後者では転写精度を直接最適化します。
MTP投機的デコード:学習時にマルチtoken予測(MTP)目標を共同最適化するため、モデル自身のMTP層をvLLMの投機的デコード用ドラフトモデルとして直接利用できます。同時に、別のDFlash2ドラフトモデルも代替として提供されます。両者を組み合わせることで、単一のRTX PRO 6000 Blackwell GPU上で毎秒2238秒分の音声を転写できます。
CTCタイムスタンプアダプター:デコード後、軽量なCTCアダプターで生成テキストと音声をアライメントします。これにより、長時間音声や激しく重なる会話でも、話者ラベル付きの単語レベルタイムスタンプを生成でき、メインモデルの負荷は増加しません。
04Nemotron 3.5 Transcribeの使い方
ハードウェアの準備:BF16版には約80GBのVRAMが必要です。FP8/NVFP4またはGGUF版を選べば必要なリソースを抑えられます。
モデルの取得:Hugging FaceまたはModelScopeでNVIDIA-Nemotron-3.5-Transcribe-30B-A4Bを検索し、OpenMDW-1.1ライセンスに従って重みをダウンロードします。
環境の構築:Nemotron Transcribe NIM(公式コンテナ)、vLLM(MTPアクセラレーション対応)、NeMo-Speech.cpp(GGUFによるローカル実行)の3つからデプロイ方法を選べます。
音声の準備:最長1時間の録音ファイルをアップロードし、使用するフレームワークの要件に合わせて形式を変換します。
プロンプトの作成:自然言語でタスクを指定します。例:「逐語的な発言を保持し、話者を付与」「フィラーを除去して英語に翻訳」。
推論の実行:インターフェースに音声とプロンプトを送信すると、モデルが転写テキストを返します。必要に応じて話者ラベルや単語レベルのタイムスタンプも付与されます。
(任意)すぐに試す:デプロイせず、Hugging Faceのnvidia/nemotron-transcribeデモスペースでオンライン体験できます。
(任意)分野別ファインチューニング:NeMo Speechツールキットでアノテーション済みデータを準備すると、単一GPUで約0.5~2.3時間で独自のアクセント、用語、形式に適応できます。
05Nemotron 3.5 Transcribeの主な優位性
指示による出力切り替え:自然言語による1文の指示で、逐語録、整理稿、翻訳などの形式を切り替えられます。再学習や複数モデルの設定は不要です。
高い転写精度:英語Open ASRベンチマークの平均WERはわずか4.71%、多言語ベンチマークでは4.62%で、いずれもオープンウェイトモデルで首位です。
高度な話者識別:複数人の音声が重なる話者ラベル付き転写タスクで、初めて専用カスケードシステムを上回りました。最長1時間、8人のシナリオにも対応します。
強力な文脈誤り訂正:用語や人名などのエンティティリストを指定すると、固有表現誤り率を6分の1に低減でき、専門用語を推測に頼る必要がありません。
話者ラベル付き単語レベルタイムスタンプ:軽量なCTCアライメントにより、転写結果の聞き直しや検索が可能になり、講義の再生や会議検索などを直接支援します。
高い推論効率:ネイティブMTP投機的デコードとDFlash2ドラフトモデルにより、単一のRTX PRO 6000で毎秒2238秒分の音声を処理できます。
06Nemotron 3.5 TranscribeのプロジェクトURL
Hugging Faceモデルリポジトリ:https://huggingface.co/nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B
技術論文:https://research.nvidia.com/labs/nemotron/files/NVIDIA-Nemotron-3.5-Transcribe-Technical-Report.pdf
07Nemotron 3.5 Transcribeの活用シーン
会議議事録と意思決定事項の抽出:話者を自動識別し、発言をそのまま保持しながら、指示に従って会議の結論やToDoを抽出します。
メディアインタビューとニュース編集:インタビュー対象者の発言を逐語的に保持して話者を付与し、引用の正確性を確保します。必要に応じてフィラーも除去できます。
授業・研修の振り返り:単語レベルのタイムスタンプ付き転写稿を生成し、受講者がキーワードを直接検索して、講師が該当内容を説明した時点へ移動できます。
医療・専門分野の記録:用語リストと分野別ファインチューニングを組み合わせ、医療者と患者の会話を標準形式の診療記録に変換し、専門用語の誤り率を低減します。
多言語コンテンツのローカライズ:40言語の録音を英語稿へ直接翻訳し、国際会議、インタビュー、動画字幕の制作に活用できます。
© 免責事項:ドメインやリンク先のコンテンツは時間の経過とともに変更される場合があります。AIEZZは第三者のウェブサイトを管理していません。外部コンテンツとリスクはご自身で確認してください。
ユーザーレビュー0