
- 월간 방문 수
- 0
- 가격
- 설정되지 않음
- 등록일
- —
- 업데이트됨
- 2026-10-08
01VoxMem이란
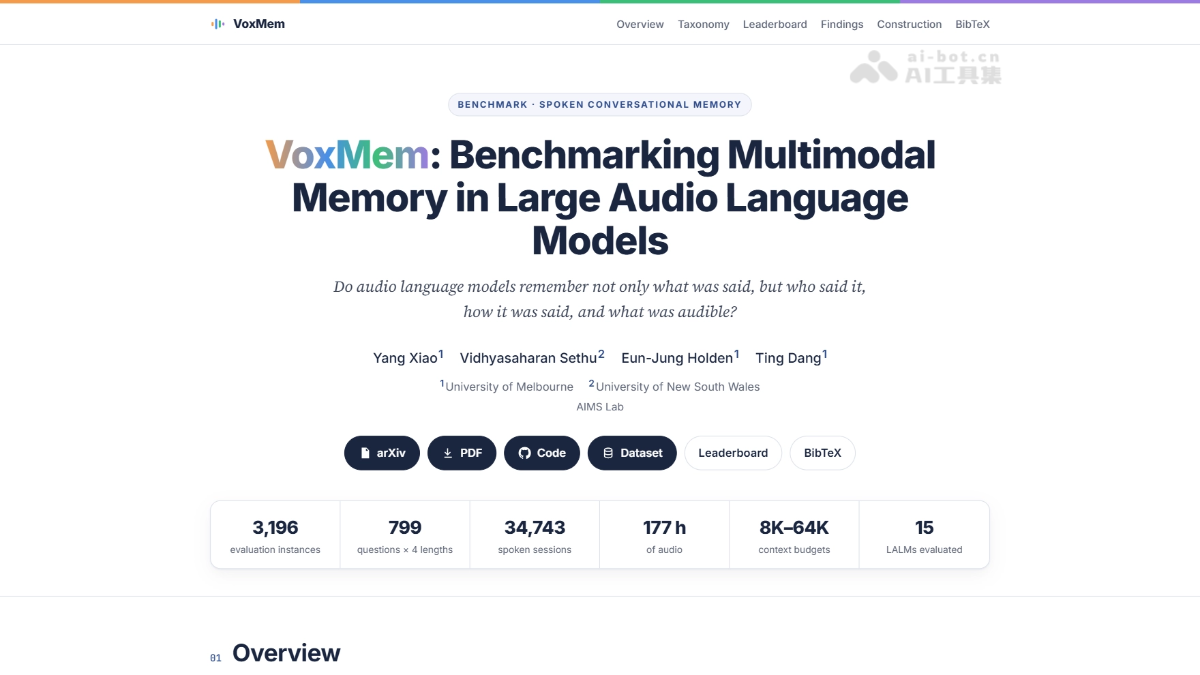
VoxMem은 멜버른대학교와 뉴사우스웨일스대학교 연구팀이 개발한 오디오 대규모 모델 메모리 벤치마크입니다. 의미, 화자, 말투, 환경음의 4가지 음향 증거와 정보 추출, 세션 간 추론, 시간적 추적, 답변 거부의 4가지 메모리 작업을 결합한 2차원 평가 프레임워크로, 8K부터 64K 토큰까지의 다중 세션 기록을 다룹니다. 15개 모델을 테스트한 결과, 32K에서 전체 정확도가 40%를 넘은 모델은 하나도 없었습니다. 모델은 무엇을 말했는지는 기억하지만 누가 어떻게 말했는지는 기억하기 어려웠으며, 오디오 컨텍스트를 단순히 늘리는 것만으로는 지속적인 음성 상호작용을 구현하기 어려웠습니다.
02VoxMem의 주요 기능
다중 세션 음성 메모리 평가: 여러 세션과 다양한 길이의 음성 기록 환경에서 대규모 오디오 언어 모델이 이전 대화 내용을 기억하고 되짚어 볼 수 있는지 체계적으로 테스트합니다.
4가지 음향 증거 범위: 음성 의미, 화자 정체성, 준언어적 단서, 환경음을 함께 평가합니다. 뒤의 세 가지는 전사만으로는 복원할 수 없는 ‘오디오 고유’ 정보입니다.
4가지 메모리 작업 분류: 정보 추출, 다중 세션 추론, 시간에 따른 상태 변화 추적, 증거 부족 시 답변 거부를 포함하며, 이들을 조합해 15개의 유효한 평가 셀을 구성합니다.
통제된 기록 길이: 동일한 문제에서 8K/16K/32K/64K 토큰의 네 가지 기록 길이별로 증거는 완전히 동일하게 유지하고 방해 세션만 추가하므로, 길이가 메모리에 미치는 영향을 독립적으로 분리할 수 있습니다.
개방형 평가 체계: 코드와 데이터를 모두 공개하고 표준 실행·채점 스크립트와 Leaderboard를 제공하여 API 모델과 로컬 모델의 재현을 지원합니다.
03VoxMem의 기술 원리
WeChat에서 ‘오픈소스’라고 회신하여 AI 오픈소스 프로젝트 그룹에 참여하세요.
2차원 분류 프레임워크: VoxMem의 핵심 설계는 음향 증거×메모리 작업의 2차원 분류표입니다. 음향 증거는 무엇을 기억해야 하는지에 답하며, 음성 정보를 의미, 화자, 준언어, 환경음의 네 가지로 나눕니다. 메모리 작업은 이를 어떻게 활용할지에 답하며, 단일 세션에서 정보를 가져오는 작업(IE), 여러 세션에 걸쳐 증거를 통합하는 작업(MSR), 시간 순서에 따라 상태 변화를 추적하는 작업(TET), 증거가 부족할 때 답변을 거부하는 작업(AR)을 포함합니다. 의미×IE 조합은 순수 텍스트 검색으로 퇴화하므로 의도적으로 제외했으며, 나머지 15개 셀이 완전한 평가 공간을 구성합니다. 이를 통해 음향 메모리 능력을 단편적이 아니라 체계적으로 평가할 수 있습니다.
3단계 데이터 구축: 데이터 생성은 ‘계획 수립—대화 작성—음성 합성’ 파이프라인으로 진행됩니다. 먼저 각 문제에 대해 질문, 답변, 증거 분포 및 유효성 제약 조건을 정의한 구조화된 계획을 생성합니다. 그런 다음 사용자 측과 어시스턴트 측의 대화 텍스트를 각각 생성하며, 양쪽 모두 화자, 말투, 배경음을 언급하지 않도록 하여 텍스트에서 답이 누출되는 것을 방지합니다. 마지막으로 TTS로 음성을 합성하고, 각 사용자에게 고정된 음색을 사용하며, 스타일 제어로 말투 단서를 주입하고, 10dB 신호 대 잡음비로 환경음을 혼합합니다. 또한 단서가 포함된 각 발화 차례마다 단서를 제거한 대응 버전을 보존하여 품질을 검사합니다.
방해 세션과 길이 제어: 각 기록은 증거 세션, 방해 세션, 채움 세션으로 구성됩니다. 방해 세션은 증거 주제와 유사하지만 값은 다르며, 텍스트만 보고 정확도가 51–56%에 불과한 분류기로 검증하여 모델이 표면적인 주제 일치만으로 답을 찾을 수 없도록 합니다. 길이 제어에서는 네 가지 길이 구간의 기록을 엄격하게 중첩하고, 무관한 채움 세션만 추가해 기록을 늘립니다. 따라서 네 구간에서 질문, 답변, 증거는 완전히 동일하며, 정확도 변화는 기록 길이 증가에만 기인하고 문제 난이도가 섞이는 영향을 배제합니다.
04VoxMem 사용 방법
저장소 복제: GitHub에서 코드를 가져온 후 git clone https://github.com/swagshaw/voxmem 을 실행하고 프로젝트 디렉터리로 이동합니다.
의존성 설치: pip install -r requirements.txt 를 실행합니다. 오디오를 자동으로 배열로 디코딩하려면 선택적으로 pip install "datasets" 를 설치할 수 있습니다.
API 키 설정: API 모델을 평가할 경우 해당 SDK를 설치하고 키를 설정합니다. 예: pip install openai 후 export OPENAI_API_KEY=.
스모크 테스트 실행: 먼저 python run_voxmembench.py --config 8k_speaker_information --model abstain --allow-abstention --limit 25 --out predictions_smoke.jsonl 로 흐름을 검증한 다음, score_voxmembench.py --judge exact-match 로 채점합니다. 거부 계층이 거부 문제에서 1.0, 답변 가능한 문제에서 0.0을 받는지 확인합니다.
정식 평가: 구성(예: 32k 전체 세트 또는 32k_speaker_information 하위 세트)과 대상 모델을 선택해 실행합니다. 예: python run_voxmembench.py --config 32k --model openai:gpt-4o-audio-preview --allow-abstention --out predictions_32k.jsonl. 로컬 모델은 --adapter 로 사용자 지정 어댑터 함수를 지정하고 --model-dir 로 가중치 디렉터리를 지정해야 합니다.
LLM 심판 채점: python score_voxmembench.py --predictions predictions_32k.jsonl --judge openai:gpt-4o-mini --out metrics_32k.json 을 실행합니다. 심판은 질문, 표준 답변, 응답만 보고 개방형 답변의 동등성을 판정합니다.
05VoxMem의 핵심 장점
오디오 고유 메모리를 체계적으로 다루는 최초의 벤치마크: 기존 벤치마크가 어휘 내용만 평가하던 한계를 넘어, 누가 말했는지, 어떻게 말했는지, 무엇을 들었는지와 같은 비텍스트 음향 정보를 처음으로 통합 평가 프레임워크에 포함합니다.
엄밀한 2차원 분류 설계: 4가지 음향 증거×4가지 메모리 작업의 15개 유효 셀을 통해 단편적인 문제 구성을 대체하여 음성 메모리 능력을 종합적이고 직교적으로 분석할 수 있습니다.
실제 환경에 가까운 다중 세션 설정: 사람과 기기의 음성 상호작용에서 시간에 걸쳐 반복되는 여러 세션을 모방합니다. 단일 장문 독백이 아니라 반복적으로 등장하는 화자와 상태 업데이트에 대한 모델의 장기 기억을 검사합니다.
길이 효과의 완전한 분리: 동일한 문제의 8K~64K 네 가지 기록 길이에서 증거를 엄격하게 중첩하고 동일하게 유지하여, ‘기록이 길어지는’ 효과를 문제 난이도 및 증거 유형과 명확히 분리합니다.
누출 방지 구성과 이중 품질 검사: 대화 양쪽에서 음향 단서를 언급하지 않고, 대응 버전을 비교하며, 전사만으로 답할 수 있는 문제를 2단계 품질 검사로 제거합니다. 이를 통해 문제가 실제로 ‘읽기’가 아니라 ‘듣기’를 요구하도록 합니다.
편법을 어렵게 만드는 방해 설계: 주제는 유사하지만 값이 다른 방해 세션을 사용하고, 정확도 51–56%에 불과한 텍스트 분류기로 검증하여 키워드 일치만으로 답을 찾는 지름길을 차단합니다.
06VoxMem 프로젝트 주소
프로젝트 공식 웹사이트: https://swagshaw.github.io/voxmem/
GitHub 저장소: https://github.com/swagshaw/voxmem
HuggingFace 모델 저장소: https://huggingface.co/datasets/AudioMemory/voxmembench
arXiv 기술 논문: https://arxiv.org/pdf/2609.32607
07VoxMem의 활용 분야
음성 비서·스마트 스피커의 장기 기억 능력 선정: 제조업체는 VoxMem으로 후보 모델이 세션을 넘어 사용자의 선호, 가족 구성원의 목소리, 이전 약속을 기억할 수 있는지 통합 테스트하여 ‘지난주에 한 말을 금방 잊는’ 문제가 출시 후 발생하지 않도록 할 수 있습니다.
차량 및 웨어러블 음성 상호작용 평가: 차량 내부는 환경음이 시끄럽고 사용자의 말투도 다양합니다. VoxMem의 환경음 및 준언어 단서 차원은 실제 소음 환경에서 모델의 기억 신뢰성을 검증할 수 있습니다.
다중 화자 고객 서비스 및 회의 시스템 품질 검사: 고객센터와 회의록 등의 환경에서는 ‘어떤 말을 누가 했는지’를 정확히 연결해야 합니다. VoxMem의 화자 연결 오류 및 잘못된 귀속 평가는 이러한 시스템의 화자 혼동 문제를 진단하는 데 직접 활용할 수 있습니다.
동반 로봇 및 고령자 돌봄 제품의 감정 기억 검증: 노인이 지난주 한숨을 쉬며 말한 일이나 말투에 드러난 피로감은 준언어적 단서만이 전달할 수 있습니다. VoxMem의 시간적 추적 차원은 제품이 시간에 따른 상태 변화를 감지할 수 있는지 평가합니다.
© 면책 조항: 도메인 및 연결된 콘텐츠는 시간이 지나면서 변경될 수 있습니다. AIEZZ은(는) 제3자 웹사이트를 관리하지 않습니다. 외부 콘텐츠와 위험을 독립적으로 검토하세요.
사용자 리뷰0