
- 월간 방문 수
- 0
- 가격
- 설정되지 않음
- 등록일
- —
- 업데이트됨
- 2026-10-16
01MiDashengLM-Spatial이란
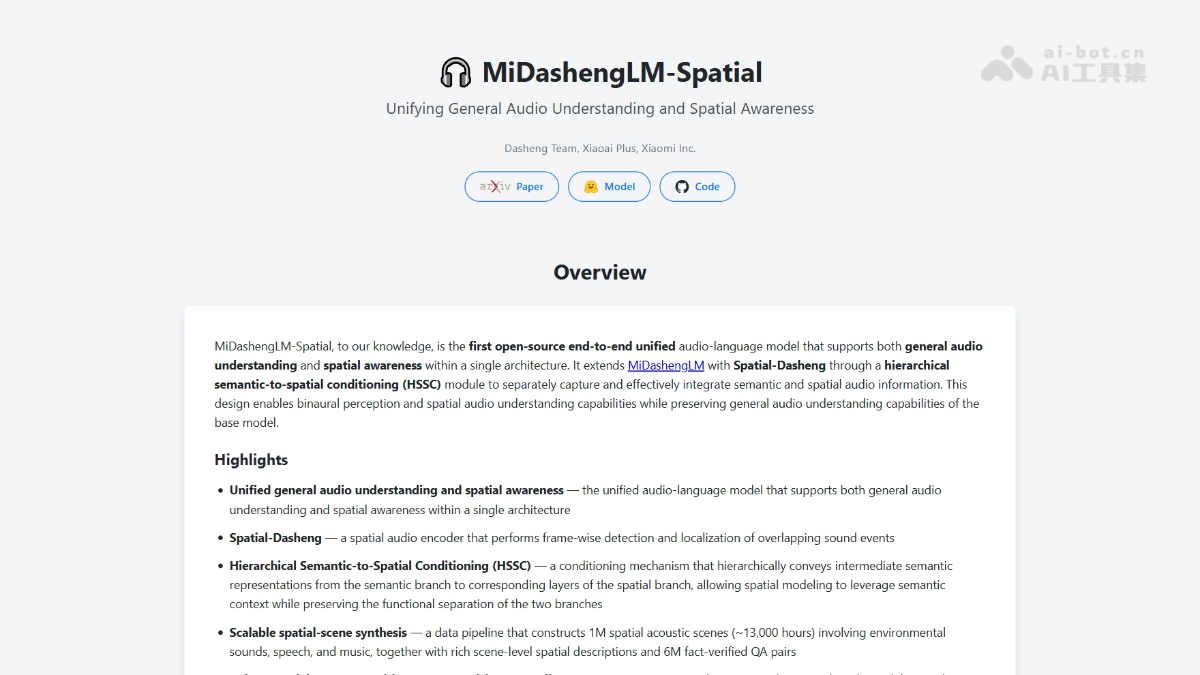
MiDashengLM-Spatial은 Xiaomi Dasheng 팀이 오픈소스로 공개한 공간 오디오 이해 대규모 모델로, 단일 아키텍처에서 범용 오디오 이해와 공간 인식을 통합한 업계 최초의 엔드투엔드 모델입니다. MiDashengLM-Spatial은 MiDashengLM-7B를 기반으로 Spatial-Dasheng 인코더와 계층적 의미-공간 조건 모듈을 추가하여 음원 방향, 이동 궤적 및 여러 음원 간 시공간 관계를 인식하고, 겹치는 음원을 프레임 단위로 위치 추정할 수 있습니다. 1M개의 공간 장면과 6M개의 QA 학습 데이터를 활용하며 Apache 2.0 라이선스로 공개되어 스마트 홈과 자동차 콕핏에 적용될 예정입니다.
02MiDashengLM-Spatial의 주요 기능
음원 위치 추정: 소리가 왼쪽, 오른쪽 또는 정면에서 오는지 판단합니다.
이동 궤적 인식: 공간에서 음원이 이동하는 방향과 경로를 파악합니다.
그룹 시공간 관계 추론: 여러 음원 간 상대적 공간 위치 관계를 추론합니다. 예를 들어 어느 음원이 더 왼쪽에 있는지, 같은 방향에 있는지 판단합니다.
공간화 콘텐츠 이해: ”무엇을 들었는가”와 ”어디에서 소리가 왔는가”를 결합해 질문에 답합니다. 예를 들어 어느 화자가 먼저 주문했는지 판단할 수 있습니다.
공간 오디오 설명: 장면에 있는 모든 음원의 위치, 움직임 및 시간적 관계를 개방형으로 생성해 완전하게 설명합니다.
공간 음성 전사: 화자 순서에 따라 내용을 전사하고 각 화자의 방향을 표시합니다.
03MiDashengLM-Spatial의 기술 원리
WeChat에서 팔로우 후 “오픈소스”라고 답장하여 AI 오픈소스 프로젝트 교류 그룹에 참여하세요.
통합 이중 분기 아키텍처: MiDashengLM-7B를 기반으로 Spatial-Dasheng 공간 오디오 인코더를 확장해 의미 분기와 공간 분기가 병렬로 작동하는 구조를 구성합니다. 두 분기는 각각 콘텐츠 이해와 방향 인식을 담당하여 하나의 모델에서 범용 오디오 이해와 공간 인식을 동시에 구현합니다.
Spatial-Dasheng 인코더: 양이 입력을 기반으로 겹치는 음원을 프레임 단위로 감지하고 위치를 추정하며, ITD/ILD 등의 양이 단서를 포착해 음원 방향과 이동 궤적을 세밀하게 공간 모델링합니다.
계층적 의미-공간 조건(HSSC): 의미 분기 중간 계층의 표현을 공간 분기의 대응 계층으로 단계적으로 전달하는 조건 메커니즘입니다. 이를 통해 공간 모델링이 의미적 맥락을 활용하면서도 두 분기의 기능적 독립성을 유지할 수 있습니다.
확장 가능한 공간 장면 데이터 파이프라인: 시뮬레이션을 통해 100만 개의 공간 음향 장면을 구축합니다. 환경음, 음성, 음악을 포함하며 장면 수준의 공간 설명과 600만 개의 사실 검증 QA 쌍을 자동 생성해 공간 능력의 대규모 학습을 지원합니다.
Sim-to-Real 일반화: 합성 데이터로 학습한 모델이 실제 양이 녹음에서도 안정적인 공간 인식 능력을 보이며, 공간 능력을 확보하는 동시에 기반 모델의 범용 오디오 이해 성능을 유지합니다.
04MiDashengLM-Spatial 사용 방법
코드 저장소를 복제합니다: git clone https://github.com/xiaomi-research/midashenglm-spatial.git。
추론 환경을 생성하고 종속성을 설치합니다: conda create -n midashengspatial python=3.13 -y && conda activate midashengspatial, 이후 pip install -r requirements.txt를 실행합니다.
모델 가중치 가져오기: 별도로 다운로드할 필요가 없으며, 코드가 HuggingFace에서 mispeech/midashenglm-spatial을 자동으로 가져옵니다.
양이 오디오 준비: (2, T) 형식의 2채널 실제 양이 오디오를 입력합니다.
모델과 프로세서 로드: AutoModelForCausalLM과 AutoProcessor를 사용하고 trust_remote_code=True로 모델을 로드합니다.
대화 메시지 구성: 학습 순서인 ”오디오 먼저, 텍스트 나중”에 따라 messages를 구성합니다. 예를 들어 오디오 + “Write a general audio caption describing the sound source and its spatial information.”과 같이 입력합니다.
추론 실행: processor.apply_chat_template으로 입력을 처리한 후 model.generate를 호출하고, batch_decode로 결과를 출력합니다.
예제 실행: 저장소의 example/inference.py에서 바로 실행할 수 있는 전체 예제를 제공합니다.
05MiDashengLM-Spatial의 핵심 장점
업계 최초: 단일 아키텍처에서 범용 오디오 이해와 공간 인식을 동시에 지원하는 최초의 오픈소스 엔드투엔드 오디오-언어 모델입니다.
최고 수준의 공간 인식 능력: STAR-Bench 공간 추론 하위 집합에서 정확도 70.3%를 기록해 인간 수준인 73.7%에 근접했으며, Gemini-3.6-Flash의 47.0%를 크게 웃돕니다.
실제 인식의 신뢰성: Channel-Swap ACR이 72.6%에 달해 좌우 방향 판단이 실제 청각 단서에 기반함을 입증합니다.
범용 능력 유지: 모노 오디오 질의응답, 음성 인식, 오디오 설명 등 범용 벤치마크에서 기반 모델인 MiDashengLM-7B와 거의 동등한 성능을 보여 공간 능력이 범용성을 저해하지 않습니다.
겹치는 음원 분석: Spatial-Dasheng 인코더는 겹치는 음원을 프레임 단위로 감지하고 위치를 추정할 수 있어, 실제 환경에서 여러 사람이 동시에 말하는 복잡한 상황을 처리합니다.
06MiDashengLM-Spatial 프로젝트 주소
프로젝트 공식 사이트: https://jinbo-hu.github.io/midashenglm-spatial-demo/
GitHub 저장소: https://github.com/xiaomi-research/midashenglm-spatial
HuggingFace 모델 저장소: https://huggingface.co/mispeech/midashenglm-spatial
arXiv 기술 논문: https://arxiv.org/pdf/2610.11156
07MiDashengLM-Spatial의 활용 분야
스마트 콕핏 상호작용: 차량 내부에서 어느 좌석의 승객이 말하고 있는지 판단해 구역별 음성 인식과 명령 실행을 구현합니다.
스마트 홈 음향 인식: 스피커 및 스마트 홈 기기를 통해 집 안에서 발생하는 소리의 방향과 이동을 파악합니다.
AR/VR 공간 오디오: 가상 세계에 청각적 공간 이해를 제공하여 음원 위치 추정, 공간 설명 생성 및 몰입형 상호작용을 구현합니다.
보청 및 접근성 기기: 청각 장애인이 소리가 어느 방향에서 오는지 파악할 수 있도록 지원해 환경 인식과 이동 안전을 높입니다.
© 면책 조항: 도메인 및 연결된 콘텐츠는 시간이 지나면서 변경될 수 있습니다. AIEZZ은(는) 제3자 웹사이트를 관리하지 않습니다. 외부 콘텐츠와 위험을 독립적으로 검토하세요.
사용자 리뷰0